Concitech AI · 深度长文
2026/09/15 08:31
多 Agent 等于高智能?Google 与 MIT 的 260 组实验推翻这条公式
Google Research、Google DeepMind 与 MIT 的 44 页论文研究 260 种配置、6 个 Agent 基准、5 类架构和 3 个模型家族。结论指向任务结构、单 Agent 基线、工具数量与验证机制。
一个 Agent 解决失败,产品团队加三个 Agent。
三个 Agent 产生分歧,产品团队增加辩论、评审与中控。
系统拥有更多角色、更多消息和更长调用链。账单增长,成功率却缺少保障。
Google Research、Google DeepMind 与 MIT 的论文《Towards a Science of Scaling Agent Systems》研究了这个问题。论文 v3 共 44 页,包含 260 个受控配置、6 个 Agent 基准、5 类系统架构和 3 个模型家族。
实验给出一个刺眼的总数:多智能体架构与单智能体基线的平均收益差为 -0.3%。
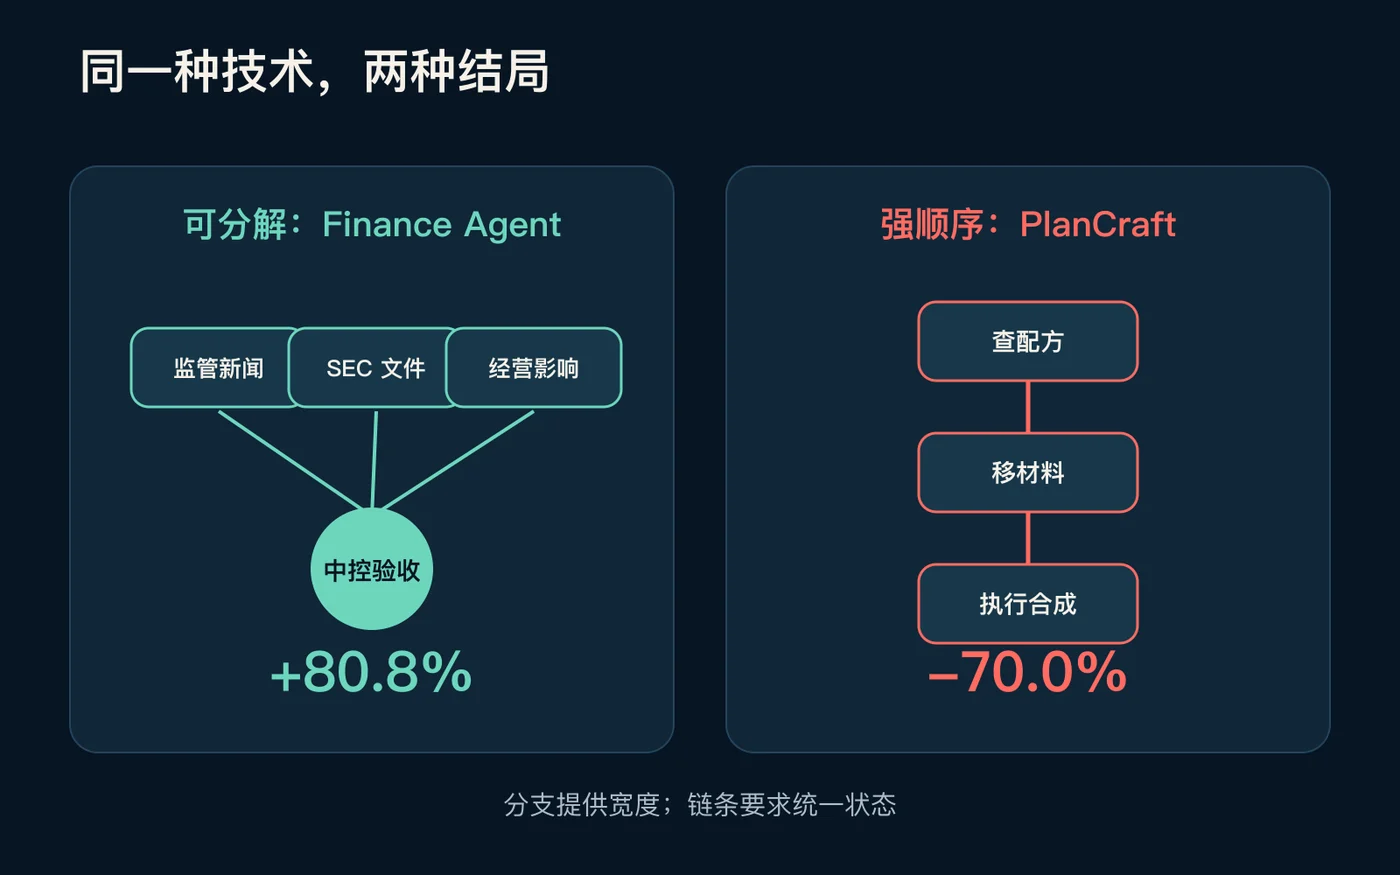
这个平均数具有误导性。多智能体系统的收益区间是 +80.8% 到 -70.0%。同一种技术产生两种结局。决定因素来自任务结构与架构匹配。
一场控制变量实验
研究团队选择五类架构。
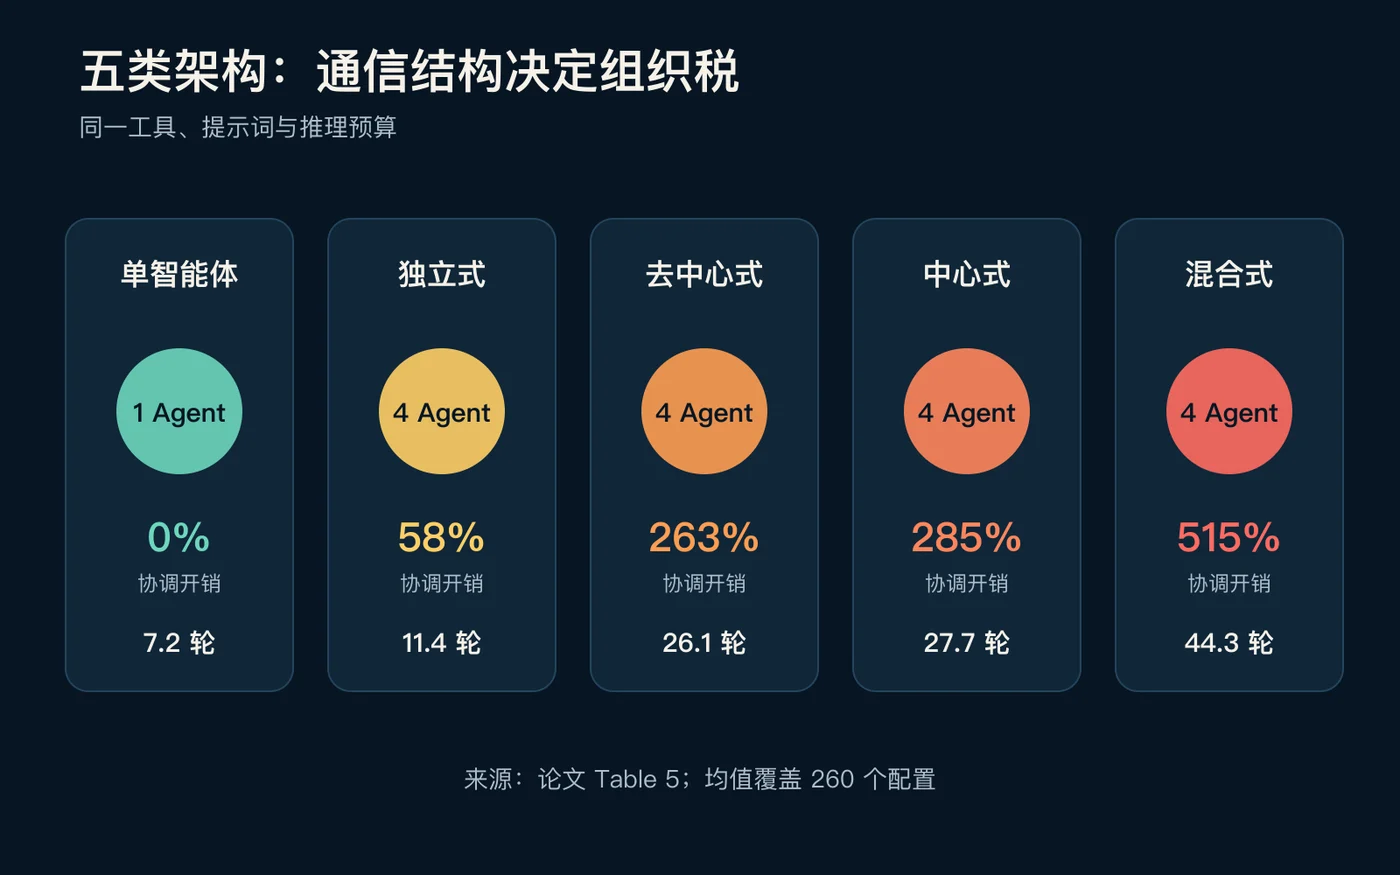
单智能体系统拥有一个推理中心和一条记忆流。独立式架构包含多个隔离执行的 Agent,系统末端汇总答案。中心式架构设置一个 Orchestrator,任务分派与结果验收归属中控。去中心式架构包含 Agent 间消息。混合式架构结合中控与同伴通信。
六个基准覆盖六类工作:BrowseComp-Plus 代表网页检索,Finance Agent 代表金融分析,PlanCraft 代表顺序规划,Workbench 代表办公工具调用,SWE-bench Verified 代表软件工程,Terminal-Bench 代表终端任务。
模型集合来自 OpenAI、Google 与 Anthropic。具体模型包含 GPT-5 系列、Gemini 2.x 系列和 Claude Sonnet 3.7 至 4.5。
控制条件构成这项研究的价值。各架构使用相同任务提示、工具权限和总推理预算。单 Agent 获得更多连续推理轮次,多 Agent 分享同一预算。平均预算为每次试验 4800 个推理 Token。
论文研究的是“同一笔预算交给一种组织结构”的结果,而非“更多预算购买更多模型”的结果。
结果一:任务可分解性决定上限
Finance Agent 的任务包含监管新闻、SEC 文件、经营影响和财务指标。各部分具有独立证据源。中心式架构的成功率是 0.631,单 Agent 成功率是 0.349,增幅达到 80.8%。去中心式与混合式架构取得 74.5% 和 73.1% 的增幅。
PlanCraft 的任务结构相反。一个典型任务包含配方查询、材料移动和合成操作。状态具有顺序依赖。上一步结果决定下一步动作。
多 Agent 分工制造了人工边界:一个角色查询配方,一个角色检查库存,一个角色执行合成。消息交接切断完整状态。独立式架构的性能降幅达到 70.0%。其余多智能体架构的降幅落在 39% 至 50.3% 区间。
Finance Agent 与 PlanCraft 给出同一条工程规则:任务宽度支持协作,任务链条排斥交接。
信息搜集、证据核验和多方案搜索拥有天然分支。状态机执行、连续调试和约束规划依赖统一记忆。Agent 数量属于次要变量。
结果二:45% 基线是一条警戒线
论文提出“基线悖论”。单 Agent 成功率代表剩余改进空间。基线升高,协作收益缩小,协调成本保持存在。
回归模型给出的经验分界估计值是 45%。单 Agent 基线超过该水平,多 Agent 数量与性能呈负向关系。交互项系数为 -0.236,聚类稳健检验的 p 值为 0.004。多重比较校正保留了这项发现。
SWE-bench Verified 提供一个样本。单 Agent 平均成绩达到 0.522。混合式下降 2.1%,中心式下降 3.1%,去中心式下降 5.4%,独立式下降 14.9%。
“45%”属于经验阈值,缺少普适常数地位。它来自六个基准与当前模型集合。这个数字适合作为实验门槛:单 Agent 基线超过 45%,多 Agent 方案的立项条件是额外证据。
论文的稳健性分析给这条结论最高证据等级。工具数量与协调开销的若干关系属于方向性模式;45% 附近的能力饱和经受住更严格的统计检验。
结果三:通信成本呈幂律增长
Agent 团队的成本增长曲线呈幂律。
研究团队拟合出交互轮数公式:
T = 2.72 × (n + 0.5)^1.724
单 Agent 平均轮数为 7.2。独立式架构为 11.4 轮,去中心式为 26.1 轮,中心式为 27.7 轮,混合式为 44.3 轮。
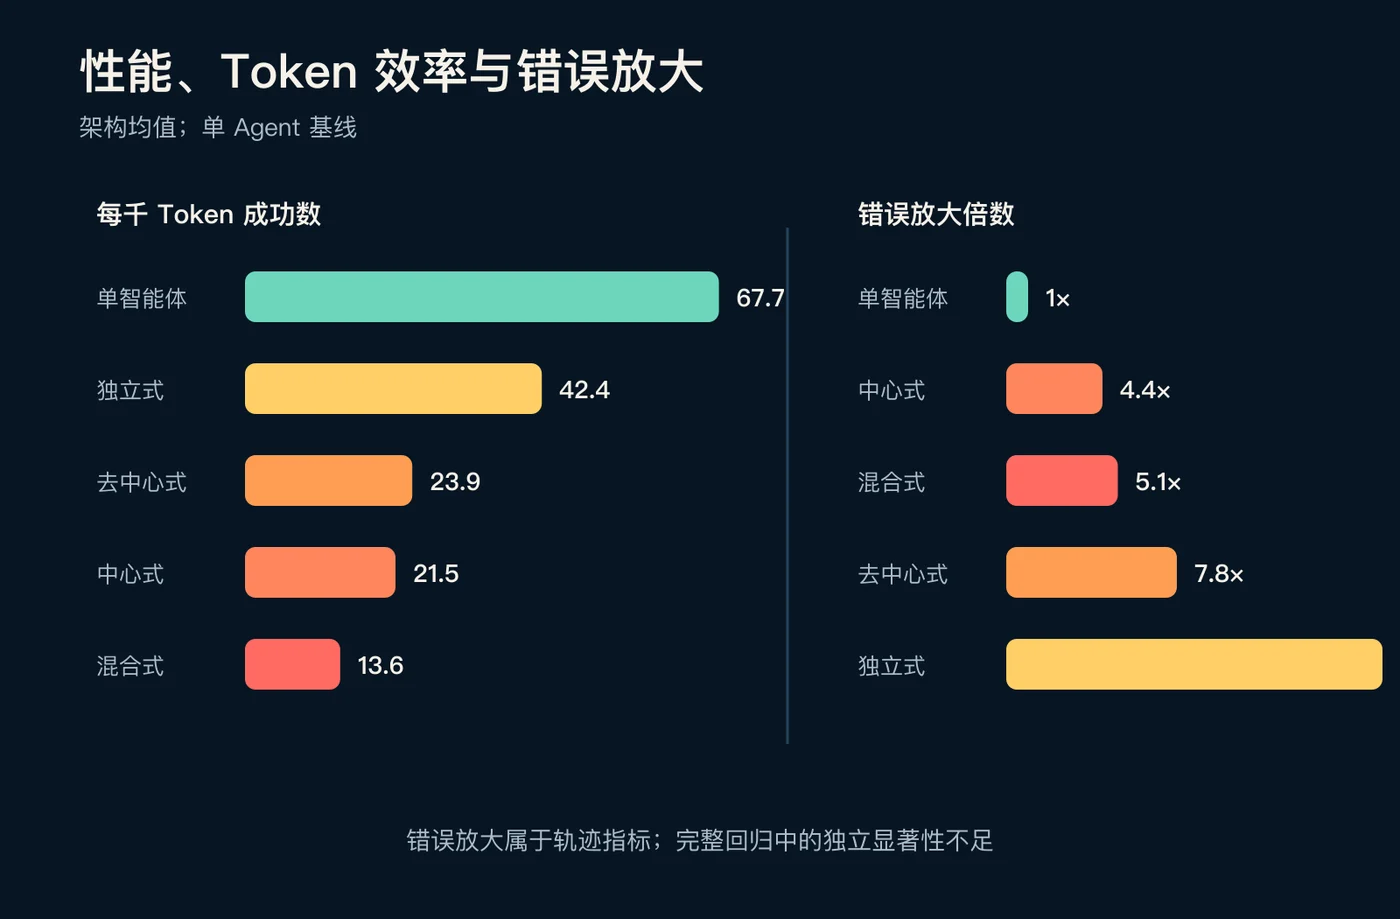
混合式架构的协调开销达到单 Agent 基线的 515%。其 Token 效率降至每千 Token 13.6 次成功。单 Agent 的对应数字为 67.7。差距接近五倍。
消息数量与信息量属于两项指标。论文发现消息密度与成功率的关系存在平台期。中心式与去中心式架构接近每轮 0.4 条消息,收益达到饱和。混合式架构增加消息,内容重叠与协议冲突增加。
固定预算加剧了问题。每个 Agent 分到的推理空间缩小。任务描述、状态摘要和同伴结论占用上下文。系统用思考预算支付组织税。
结果四:验证中枢控制错误传播
独立式架构缺少同伴通信,协调成本处于最低水平。它的错误放大倍数达到 17.2 倍。
多个 Agent 重复同一错误的风险存在。末端汇总缺少共同幻觉识别能力。去中心式架构的错误放大倍数为 7.8,混合式为 5.1,中心式为 4.4,单 Agent 基线为 1.0。
中心式架构的优势来自验证瓶颈。Worker 输出经过 Orchestrator 的一致性检查。论文的错误分类显示,中心式架构对逻辑矛盾、数值漂移和上下文遗漏拥有较强抑制效果。
这项结果带有一个限定:完整回归模型缺少错误放大指标的统计显著性。效率与开销拥有更强解释力。17.2 倍适合描述执行轨迹中的传播现象,缺少单独因果结论的资格。
安全含义清楚。高风险系统验收节点的权限集包含证据访问权、冲突裁决权和结果否决权。多个独立答案加一个拼接器,缺少可靠验证结构。
大模型老板加小模型员工?证据有限
成本优化常见一种设计:强模型担任 Orchestrator,小模型承担检索与执行。
论文测试了 13 个异构配置。BrowseComp-Plus 的中心式混合团队比强模型同构团队低 12.6 个百分点。去中心式配置获得 2.0 个百分点的小幅收益,收益主要来自团队中的强模型。
这组实验属于初步研究。样本覆盖 13 个配置和一个主要基准。异构团队必然失败的证据缺失。领域微调模型、角色专用模型与新型路由器不属实验范围。
可靠结论只有一条:模型价差与团队性价比缺少确定映射关系。廉价 Worker 的错误进入中控上下文,信息污染成本存在超过调用成本节省的风险。
87% 的选型准确率意味着什么
回归模型包含模型能力、Agent 数量、工具数量、单 Agent 基线、协调效率、消息密度、冗余率和错误放大等变量。
传统 Intelligence Index 版本的交叉验证 R² 为 0.373。Agent 基准成绩构成的 ACI 版本拥有 0.413 的 R²。模型对留出配置的最佳架构选择准确率达到 87%。随机选择基线为 20%,能力指标模型为 54%。
87% 指向“同类任务里的架构排序”。“陌生行业的成功率预测”属于另一命题。论文的跨数据集验证显示,绝对成功率预测存在困难。BrowseComp-Plus 的新模型测试提供单一基准内的迁移证据。
这套公式更像选型筛网。明显错误架构的排除是它的用途。业务样本测试具有独立价值。
一份工程决策表
决策表包含四个检查项。
第一项是单 Agent 基线。测试集覆盖真实工具、失败恢复和长链状态。基线达到 45% 附近,多 Agent 方案适用更高立项门槛。
第二项是任务依赖图。平行证据分支适合 Worker 并发与中控汇总。强顺序依赖适合单一状态拥有者。
第三项是工具密度。工具数量增加了路由、权限、参数与状态同步成本。论文中的工具范围为 2 至 16 个。小团队与窄通信面适配工具密集任务。
第四项是验收机制。高价值输出的门禁包括证据引用、结构化字段、规则校验器、测试执行器或人工审批。Orchestrator 的合适角色是验收者,转发者角色价值有限。
一个保守起点具有三层结构:单 Agent 负责主链,专用 Worker 负责天然分支,验证节点负责门禁。每个新增 Agent 对应三个问题:它提供什么独立信息?它消除什么错误?它消耗多少预算?
论文的边界
这项研究仍有七类限制。
团队规模实验覆盖 1、3、5、7、9 个 Agent,超大群体缺少实证。异构团队研究样本有限。各架构沿用统一提示词,专属 Prompt 优化带来结果差异风险。六个基准属于文本环境。SWE-bench Verified 与 Terminal-Bench 各使用 20 个实例,单元比较的置信区间较宽。经济分析受模型价格影响。回归模型的数据集簇数量是 6,统计功效受限。
这些限制削弱“普遍定律”的说法。核心警告保有价值:多 Agent 是一种组织结构,与性能按钮属于两类事物。
单 Agent 保留完整上下文。多 Agent 购买探索宽度,代价包括通信、同步、错误传播和 Token 分割成本。
工程问题因此发生变化。
“需要几个 Agent”缺少首要地位。
首要问题是:任务拥有多少独立分支,哪一个节点掌握完整状态,哪一种机制负责验收。
答案决定系统架构、账单与可靠性。
