Concitech AI · 深度长文
2026/08/25 18:30
别再给 AGENTS.md 打补丁:把项目规则训练出来
一条规则该不该写进 AGENTS.md,不应取决于上一次踩坑有多恼火。backpass 提出一套更像工程实验的维护方法:从真实会话取证,批量观察,小步更新,在固定预算内删旧增新,并由人做最后决定。
Coding Agent 又犯了同一个错。
最顺手的处理方式,是打开 AGENTS.md,补上一条“永远不要……”。当时很解气,问题似乎也解决了。几个月后再看,这个文件已经塞满了历史事故:旧命令、过期目录、互相打架的规范,还有不少只发生过一次的偶然失误。
Agent 每次开工,都要先读完这座规则坟场。
8 月 25 日,X 上一则中文帖子推荐了 Kun Chen 的文章《Your AGENTS.md is a Neural Net》。标题很会抓人,但这篇文章最有价值的地方并不是“神经网络”这个比喻,而是一套更朴素的工程纪律:不要凭印象维护项目规则,要根据真实会话留下的证据,在固定预算内持续做小改动。
这让 AGENTS.md 从一份越写越长的注意事项,变成了一个可以观测、评估和迭代的系统。
项目规则通常不是写错,而是慢慢失效
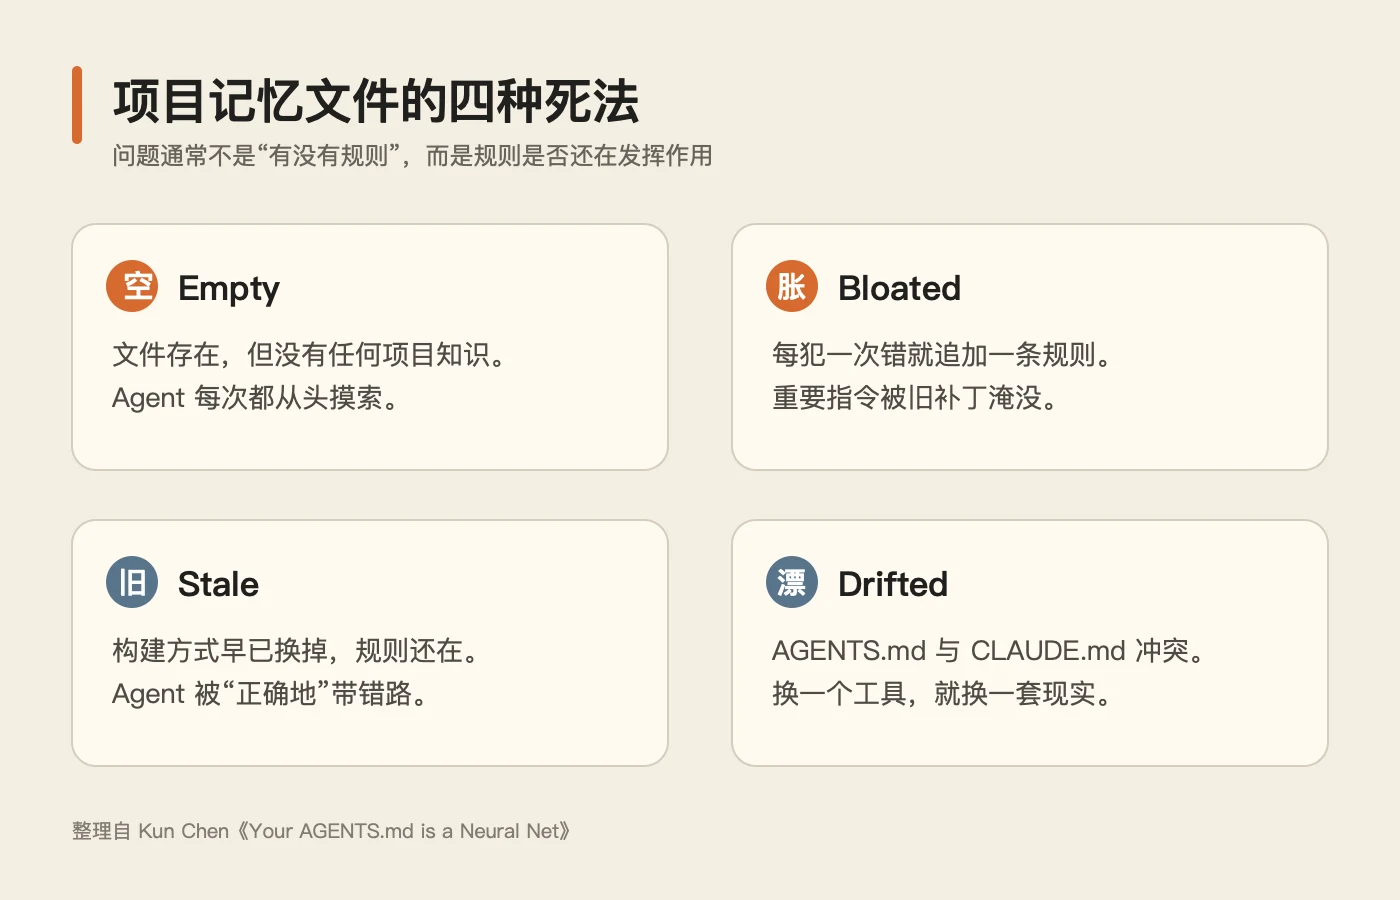
Kun Chen 把常见的项目记忆文件分成四种失败状态。
第一种是空。文件由工具自动创建,里面没有真正的项目知识。Agent 每次都要重新发现包管理器、测试命令和目录边界。
第二种是臃肿。每次出错就追加一条规则,旧规则从不退出。文件越来越长,真正重要的要求被埋在大量低频细节中。
第三种是过时。项目已经从 npm 换成 pnpm,构建系统也重做了,规则仍在要求 Agent 走老路。它不是没遵守指令,恰恰是太认真地遵守了错误指令。
第四种是漂移。AGENTS.md、CLAUDE.md 和其他工具的项目说明各写一套。今天换一个 Agent,项目规范也跟着换一套版本。
这些问题会直接进入每次任务的上下文。OpenAI 的官方文档写得很明确:Codex 在开始工作前会读取 AGENTS.md,从全局配置一路加载到当前目录,越靠近工作目录的文件优先级越高。项目指令默认累计到 32 KiB 后停止继续加载。
32 KiB 是加载上限,不是推荐目标。一个文件没有撞到上限,也可能已经太长、太旧,或者充满重复要求。
AGENTS.md 真的是神经网络吗?
技术上不是。
AGENTS.md 没有可训练参数,也不会计算数值梯度。它只是被放进上下文的自然语言指令。修改文件也不会改变底层模型的权重。
但作为维护方法,这个类比很有用。
项目规则相当于当前的“权重”;一次 Agent 会话是 forward pass;实际结果与预期之间的差距是 loss;读取会话记录、找出哪些规则有效或缺失,再小幅修改文件,是 backward pass;每次只改少量内容,相当于控制 learning rate。
最关键的一点,是把更新依据从“我记得上周被它气过一次”换成真实的 session transcript。
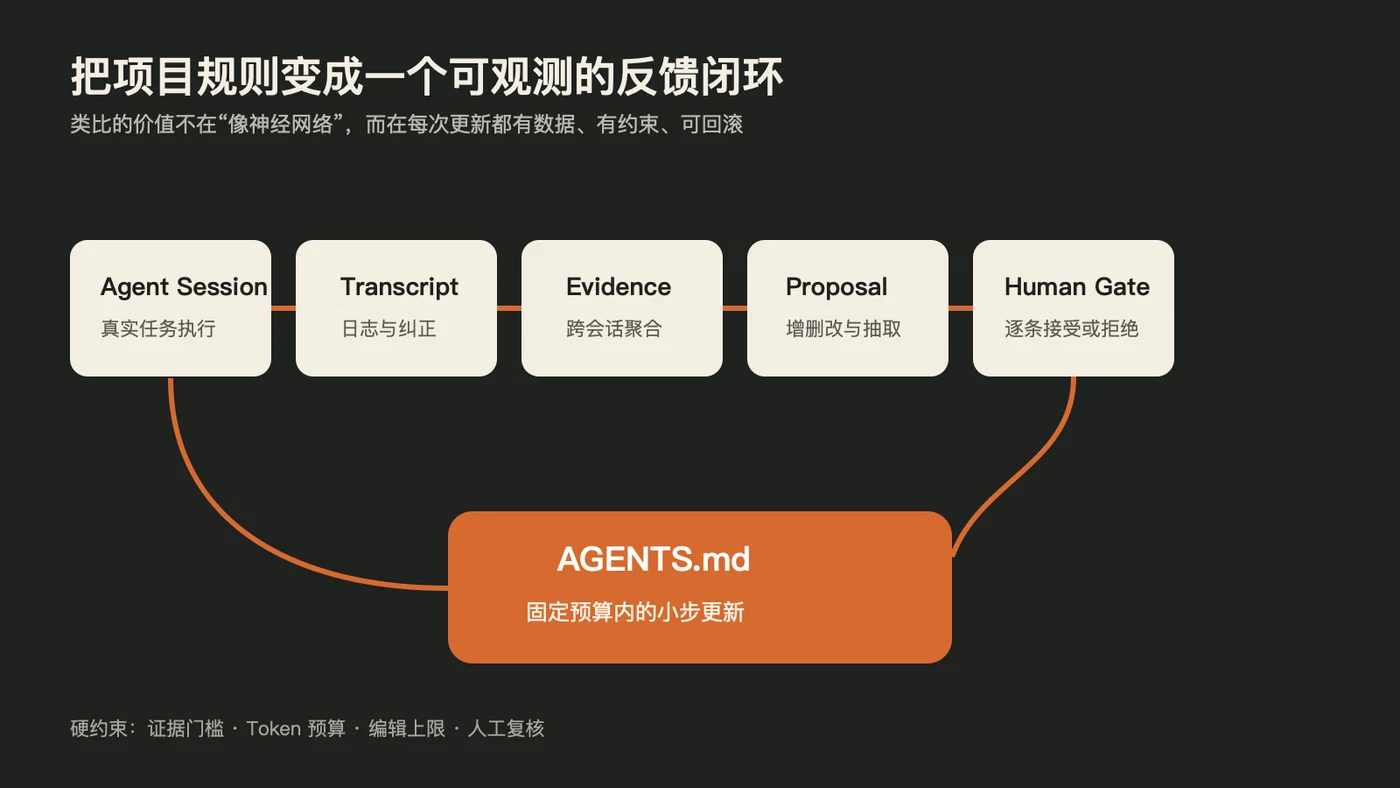
这套说法的边界也要记住:它是一张工作流程图,不是机器学习原理的等价替换。真正值得借走的是证据、批处理、小步更新、容量约束和人工复核。
backpass 把“反向传播”做成了什么
Kun Chen 随文章开源了 backpass。截至本文写作时,仓库里的版本是 0.1.3,采用 MIT License。
它会读取本机上多种 Coding Agent 的会话记录,包括 Claude Code、Codex、pi、opencode、Grok、Cursor CLI 和 Hermes,再根据工作目录或 Git remote 判断哪些会话属于当前仓库。
接下来,工具把冗长的 tool call 压缩成较短的轨迹,保留用户要求、Agent 回应和关键操作。作者称这一步通常能减少 96%—99% 的内容,且不调用模型。明显的 API Key、Token 等模式会先被遮蔽,然后才把压缩后的材料交给已登录的 Agent harness 分析。
分析不是直接改文件。它先把每条规则变成可定位的单元,寻找三类证据:规则被遵守后带来了什么,违反规则造成了什么,以及哪些重复错误没有规则覆盖。没有逐字会话证据的判断,会被代码丢弃;新增规则默认至少要在两个不同会话里出现过。
生成修改建议时,backpass 允许增加、删除、重写,或把低频规则抽成 Skill。文件在预算内时,每轮默认最多五处修改;文件严重超预算时,上限会自适应提高,但最高不超过二十处。所有修改先发生在 staging copy 中,只有运行 backpass apply、逐条接受之后,才会写回仓库。
默认预算是 5000 个估算 Token。这个数字不是行业标准,只是工具给出的起点。它真正表达的是:常驻上下文有容量成本,增加一条规则时,必须考虑由哪条删除、合并或抽离来买单。
“提示词越短越好”也不准确
规则文件需要预算,不等于越短越好。
一条能阻止生产事故的安全约束,即使只触发一次,也值得常驻。一段看似冗长的示例,如果稳定地纠正了模型行为,也可能比抽象口号更有用。真正该删除的是重复、过时、互相冲突和没有证据支持的内容。
OpenAI 在 GPT-5.6 的模型指导中披露过一组内部 Coding Agent eval:精简重复指令、示例和工具描述后,评测分数方向性提升约 10%—15%,总 Token 减少 41%—66%,成本下降 33%—67%。官方也特别提醒,结果会因工作负载而异,必须在代表性任务上验证。
学术研究给出了相近的警告。ICML 2023 的一项研究发现,大模型会被无关上下文干扰;后续长上下文基准也持续观察到,模型“装得下”内容,并不等于能稳定使用每一条信息。
所以,预算是实验约束,不是审美偏好。判断一条规则值不值得占位置,最终还要看它是否改善了真实任务。
这套方法有三处不能自动化迷信
第一,归因很难。Agent 失败,可能因为规则缺失,也可能因为模型能力、工具故障、任务描述含糊或随机性。即使有逐字证据,也不能自动证明某条指令就是原因。backpass 自己的 README 也把“因果归因困难”列为限制。
第二,本地优先不等于全程离线。原始 transcript 从本机读取,但压缩后的内容仍可能通过你已经登录的远程模型服务进行分析。内置遮蔽只能覆盖“明显的秘密形态”,不能保证找出所有客户数据、内部 URL 或业务敏感信息。高敏仓库使用前,应先检查采集范围和脱敏规则。
第三,这是一个很早期的工具。0.1.x 版本、未文档化的 transcript 格式、不同 Agent 客户端随时可能变化。目前也没有独立评测证明,使用 backpass 一定能提高项目成功率。它提供的是一套值得试验的方法,不是已经验证完毕的最佳实践。
一套不装工具也能执行的维护流程
你完全可以先手工做一轮,时间控制在 30 分钟。
-
分开个人偏好与项目事实。 全局文件保存你长期坚持的工作方式;项目文件只放仓库特有、可验证的约束。
-
先定预算和基线。 记录当前文件长度,再选 10—20 个代表性任务,保存成功率、返工次数或人工纠正次数。5000 Token 可以当起点,不必照抄。
-
按批次看会话。 每周集中检查一次,不为单次偶发错误立刻加规则。新规则至少需要两次独立证据,安全约束除外。
-
每次只做少量增删改。 优先删过时和重复内容。适用面窄、触发条件清楚的说明抽成 Skill;低频又无法稳定触发的规则,考虑删除。
-
用同一批任务回测。 看修改后是否真的减少返工,同时检查有没有引入新的误伤。没有改善,就回滚。
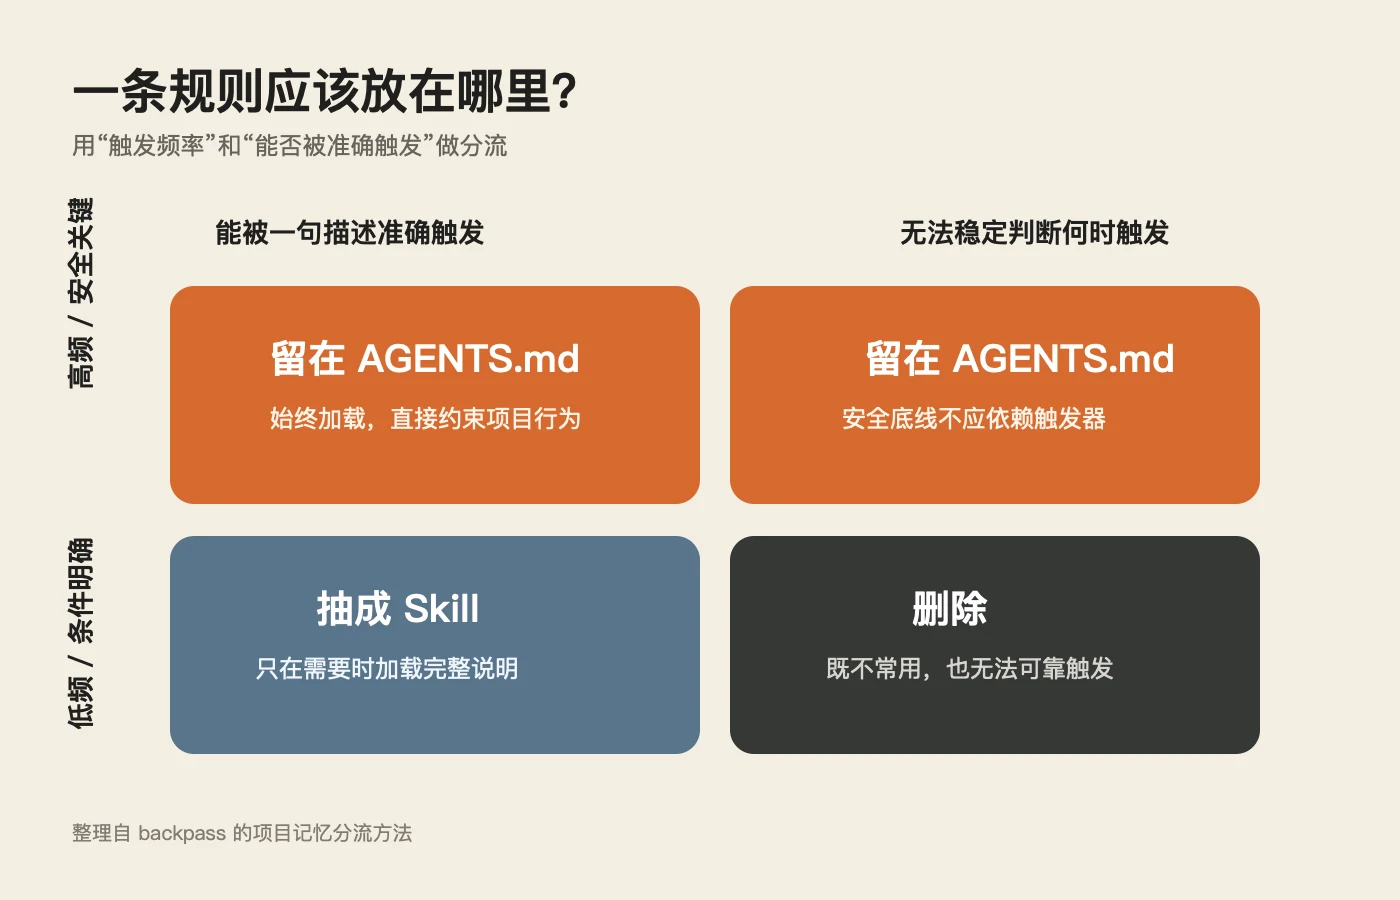
这套流程真正改变的,是维护规则时的举证责任。
过去,新增一条规则只需要一次不爽;删除一条规则却没人敢负责。现在应该反过来:任何常驻指令都要说明它解决了哪些重复问题,为什么值得每次加载,以及哪条旧内容可以让出位置。
AGENTS.md 当然不是神经网络。
但如果我们愿意像训练系统那样对待它:保留数据,测量误差,限制容量,小步更新,并让人守住最后一道闸门,它会比一份靠情绪增长的规则清单可靠得多。
参考资料
- Xudong Han:推荐《Your AGENTS.md is a Neural Net》
- Kun Chen:Your AGENTS.md is a Neural Net
- GitHub:kunchenguid/backpass
- OpenAI 官方文档:Custom instructions with AGENTS.md
- OpenAI Model guidance:Favor leaner prompts
- ICML 2023:Large Language Models Can Be Easily Distracted by Irrelevant Context
- NeurIPS 2024:RULER / long-context evaluation
