Concitech AI · 深度长文
2026/10/30 06:42
AI 浏览器自动化选型:八条技术路线与一套工程架构
Playwright、OpenCLI、Ego Lite、Stagehand 与云浏览器承担不同职责。本文介绍八条自动化路线,拆解决策、工具、运行时、基础设施与结果校验,解释登录态、快照引用、WebMCP、重试和成本评估,并给出订单采集任务的工程示例。
一个订单导出任务,包含登录、日期筛选、分页、字段提取和文件生成。Agent 的演示视频展示鼠标与按钮,生产系统的验收对象是订单条数、金额、权限和任务记录。
浏览器自动化的工具名单包含 Playwright、OpenCLI、Ego Lite、Browser Use、Stagehand、云浏览器与 WebMCP。它们的职责存在层次差异,选型需要回答几个具体问题:谁决定动作,谁执行动作,登录态属于谁,结果的验收标准是什么?
我的选型主张是:**业务契约定义结果,脚本承担稳定步骤,模型处理页面歧义,执行记录提供验收证据。**各个组件的价值需要业务任务检验。
本文的依据是项目文档、公开仓库与浏览器开发文档,资料核验日期为 2026 年 10 月 29 日。本文包含一项自拟工程示例,性能排名与跨产品实测属于本文的范围之外。
1. 一套架构,五种职责
决策层解释任务、选择动作。工具层暴露导航、读取、填写等操作。浏览器运行时维护页面、登录态和下载。基础设施负责实例生命周期、并发与资源。验收层检查结果,保存证据。
这些层次组成一套系统。Stagehand 的决策与提取能力、MCP 工具接口、云端浏览器实例,具有组合空间。产品名称的并列,缺少互斥选项的含义。
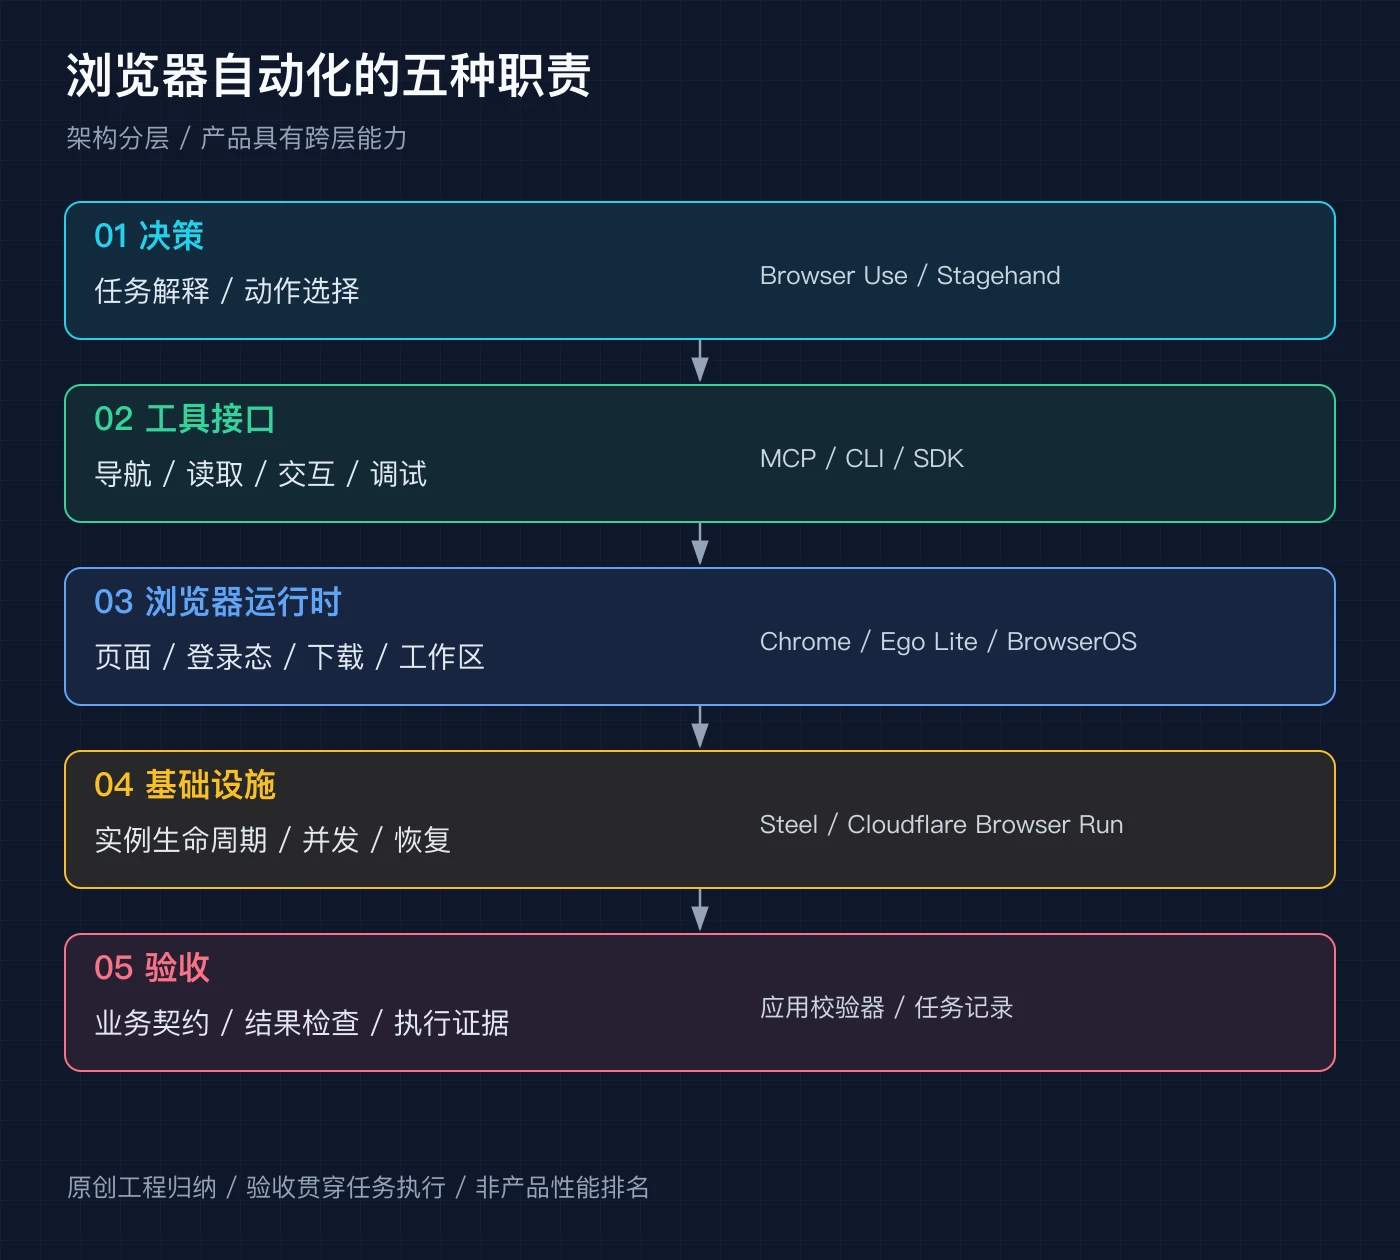
图:原创职责分层示意。产品具有跨层能力,图中的位置表示主要职责,技术分层属于本文的工程归纳。
“浏览器能运行”与“业务任务正确”具有不同的验收标准。点击成功说明驱动完成一次交互;订单文件的完整性需要字段、数量和业务规则的校验。
2. 八条路线,八类工程问题
八条路线是一张技术地图。表中的“适用任务”属于本文的选型建议,具体性能需要目标系统的测试。
| 路线 | 代表项目与资料 | 主要职责 | 选型关注点 |
|---|---|---|---|
| 确定性脚本 | Playwright | 定位、交互与断言 | 页面契约、测试与维护 |
| MCP/CLI 工具接口 | Playwright MCP、Chrome DevTools MCP | Agent 的浏览器工具 | 工具粒度、上下文与调试能力 |
| 扩展与本地桥接 | OpenCLI | 日常浏览器连接与网站适配器 | 登录态、扩展权限与会话归属 |
| 专用浏览器运行时 | Ego Lite、BrowserOS | Agent 工作区与浏览器协作 | 工作区、身份隔离与开源范围 |
| 自主决策与混合 SDK | Browser Use、Stagehand | 页面探索、动作选择与提取 | 终止条件、模型预算与验证器 |
| 云浏览器设施 | Steel、Cloudflare Browser Run | 实例、会话与生命周期 | 并发配额、恢复与资源成本 |
| 抓取与清洗 | Crawl4AI、Firecrawl | 页面内容与结构化结果 | 提取质量、覆盖率与去重 |
| 网站原生工具接口 | WebMCP | 网站业务能力的结构化暴露 | 浏览器支持、工具契约与授权 |
脚本的可靠性来自页面契约
Playwright 的定位文档推荐角色、标签与测试标识。getByRole('button', { name: '导出', exact: true }) 表达按钮的语义,getByTestId('orders-export') 表达团队约定的测试契约。CSS 层级属于另一种定位选择。
稳定业务路径适合脚本。页面文案、可访问名称和业务流程的变更,构成脚本的维护成本。脚本驱动的模型推理 Token 成本为零,端到端耗时包含网络、渲染、等待和重试。“固定流程等于毫秒级完成”缺少通用依据。
CDP、MCP 与 CLI 具有不同语义
CDP 是浏览器调试协议;MCP 定义 Agent 的工具交互;CLI 提供命令行入口。MCP 工具的底层实现需要浏览器驱动,CDP 是一种连接方式。
Playwright 的连接文档区分自身协议与 CDP,后者的连接支持对象是 Chromium 系浏览器,功能保真度存在差异。Playwright MCP 的核心页面表示是无障碍快照。Chrome DevTools MCP 提供网络、控制台与性能分析能力。
接口形态影响工程体验。一次完整页面快照带来上下文成本;命令行输出的体积取决于命令设计。CLI 和 MCP 的名称,缺少成本优劣的单独证明能力。
登录态复用需要身份边界
OpenCLI 的桥接文档说明了扩展与本地守护进程的连接方式。网站适配器提供可复用命令,浏览器原语支持页面操作。
登录态复用省去一部分认证流程,权限的归属需要设计。两个任务使用不同标签页,账户权限的隔离需要独立机制。Cookie、存储与浏览器 Profile 的隔离范围,需要具体实现说明。
Ego Lite 的 Space 文档介绍独立工作区与人工接管;Node 辅助运行时提供页面、快照与任务空间接口。BrowserOS neo 的仓库介绍了独立标签页、会话回放与 MCP 连接。这些机制服务于人机协作,账户隔离需要额外核验。
开源范围具有另一层区别。Ego Lite README 的 MIT 声明覆盖仓库内容,浏览器是独立下载件;仓库许可证与整款浏览器的授权范围需要区分。BrowserOS 仓库采用 AGPL-3.0。浏览器存储的本地化与模型推理的数据去向,属于不同问题,云模型调用需要数据流说明。
3. 页面表示决定 Agent 看见什么
原始 HTML 包含脚本、样式、隐藏节点和业务内容。无障碍树突出角色、名称与结构,截图保留视觉布局。三种表示具有不同的信息损耗。
Ego Lite 的快照文档展示了交互元素的临时引用。引用与页面状态有关,导航、弹窗和重渲染具有失效风险。新版运行时具有引用维护机制,具体行为取决于对应版本的契约。
我建议执行器保存页面地址、文档版本与目标元素证据。旧引用的失效需要新快照和目标核验。一次缓存的按钮编号,缺少长期稳定身份的含义。
页面表示的取舍影响任务质量。订单表格适合结构化读取;图表与画布需要视觉证据;模糊按钮需要上下文。快照压缩率与业务信息的完整性属于验收对象。
**WebMCP 改变的是网站能力的表达方式。**网站暴露带参数的工具,Agent 获得业务语义。Chrome 文档标注其状态为 Early Preview,要求相应 Chromium 版本与实验开关;规范属于演进中的社区组草案。
WebMCP 的运行位置是页面客户端,工具注册表属于页面。它与后端 MCP 服务的传输机制存在区别。工具参数的 Schema 检查负责输入形状,身份鉴权与业务授权需要网站服务端执行。
4. 一个订单采集任务的实现
本文示例的任务是:读取指定业务日的订单,生成本地结果文件。输入契约包含账户、业务日期、字段集合与分页上限;输出契约包含订单号、业务日期和金额分值。该示例的金额规则是非负安全整数,退款数据需要另一份业务契约。
Stagehand README 展示 observe、act、extract 与 Schema 的组合;Browser Use 提供 Agent 执行循环。本文的实现建议采用稳定步骤与动态节点的组合,模型的结果进入业务校验器。
任务执行链包含五步:
- 账户检查:执行器核对站点、租户与登录用户。
- 页面采集:脚本完成筛选与分页,模型处理存在歧义的节点。
- 契约校验:校验器检查字段、业务日、重复订单与数量。
- 文件生成:执行器写入临时文件,完整性检查决定交付状态。
- 记录归档:任务记录保存输入摘要、页面证据、错误与文件校验值。
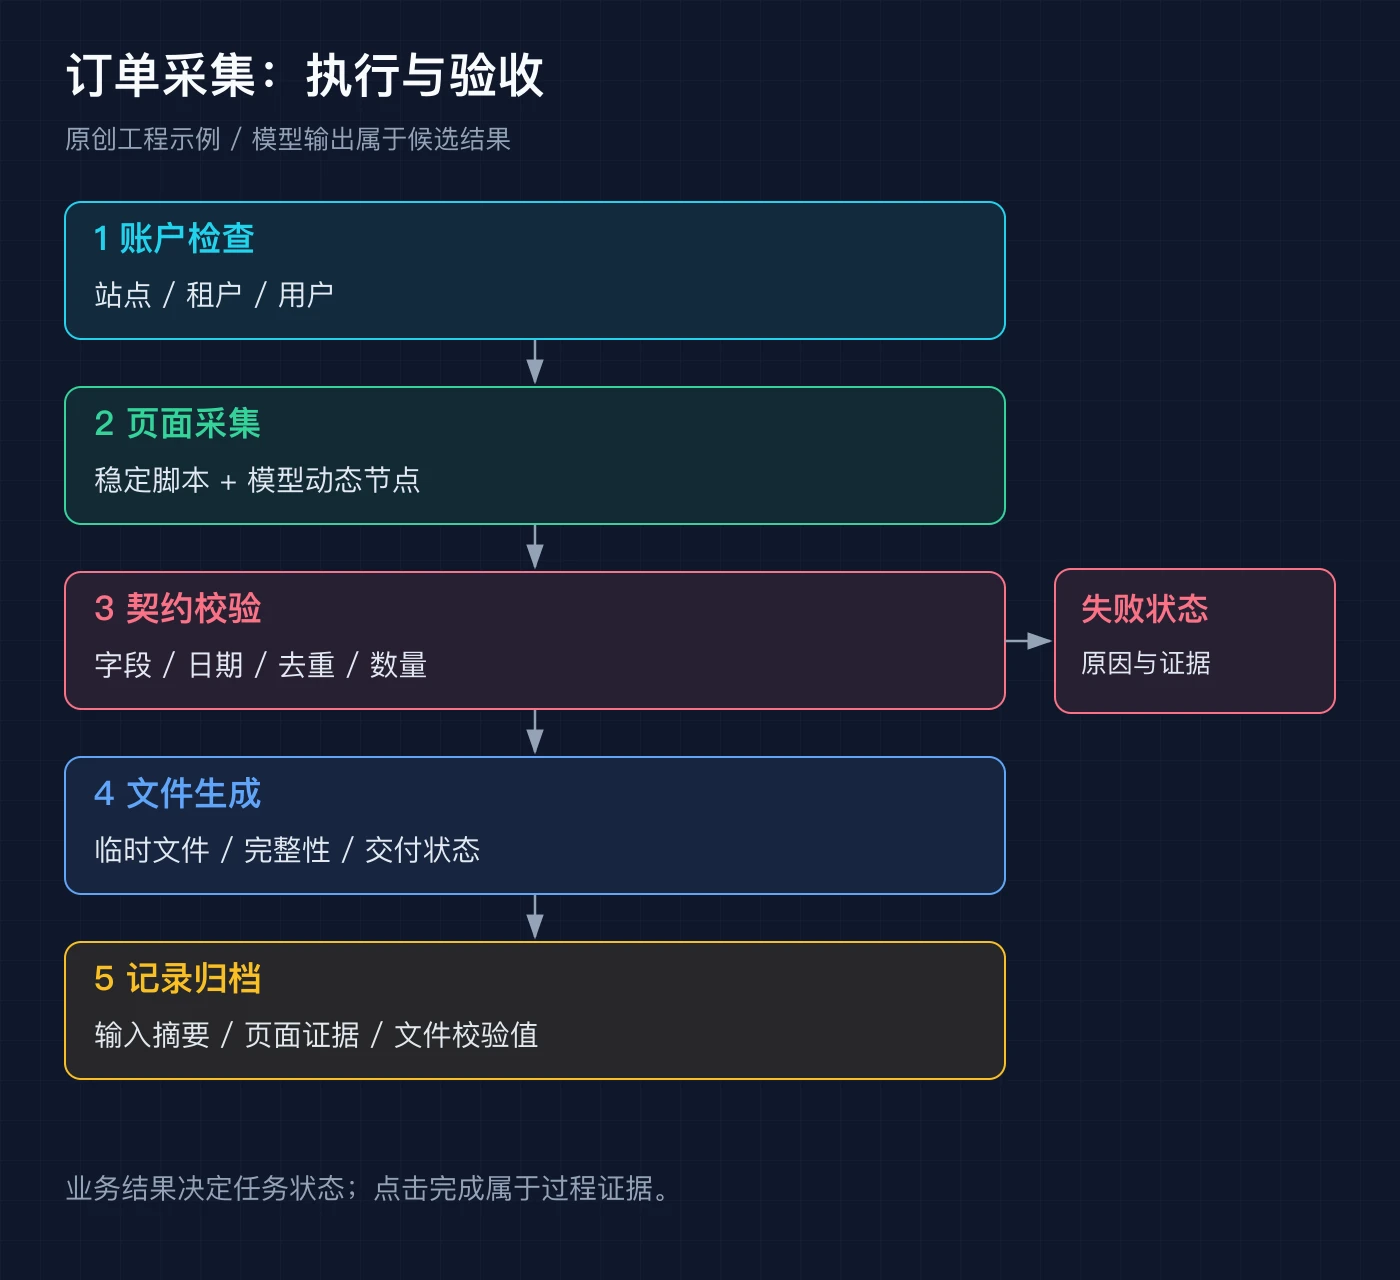
图:原创工程示例。模型输出属于候选结果,契约校验与文件检查决定任务状态。
这段 JavaScript 是本文编写的校验示例,输入 rows 来自浏览器采集,expectedCount 来自独立的数量依据,来源可以是相同筛选条件的后台总数。数量的一致性属于必要检查,订单集合的完整性需要独立 ID 清单或业务对账依据。
function validateOrders(rows, day, expectedCount) {
  if (!Array.isArray(rows) || rows.length !== expectedCount)
    throw new Error('订单数量不符');
  const seen = new Set();
  for (const row of rows) {
    if (typeof row.orderId !== 'string' || !row.orderId.trim())
      throw new Error('订单号缺失');
    if (seen.has(row.orderId))
      throw new Error('订单重复');
    if (row.businessDate !== day)
      throw new Error('业务日期不符');
    if (!Number.isSafeInteger(row.amountCents) || row.amountCents < 0)
      throw new Error('金额格式错误');
    seen.add(row.orderId);
  }
  return rows;
}
函数的模拟数据校验覆盖正常记录、重复订单、日期偏移、金额格式和数量缺口。该验证的对象是校验逻辑,真实站点的登录、分页与文件生成需要集成测试。字段类型的正确,缺少业务数值正确的保证。
重试需要任务状态。分页读取失败适合页面状态恢复,文件生成失败适合临时文件清理。外部写入需要幂等标识、状态查询与结果回读。超时描述一次等待的结束,服务端执行状态的核验需要独立证据。
验收失败的结果需要失败状态。点击次数、模型的完成声明、截图中的绿色提示,属于过程证据。
5. 成本评估需要完整任务
云浏览器解决实例与会话问题。Steel提供会话管理、调试界面与自托管路径;Cloudflare Browser Run提供无头浏览器与多种接入方式。任务调度需要考虑并发、超时、实例清理和会话恢复。
内容采集具有不同的交付物。Crawl4AI 和 Firecrawl 提供 Markdown 与结构化提取能力,后者的文档包含交互接口。产品分类表示主要用途,缺少严格的能力分界。
我建议选型试验使用同一组目标任务、相同权限和相同验收标准。成本记录包含模型调用、浏览器资源、重试、人力接管与维护投入;有效交付量采用验收通过的任务数。
| 指标 | 记录对象 | 解释范围 |
|---|---|---|
| 完整任务成功率 | 验收通过数/尝试数 | 涵盖失败和接管 |
| 完成时长 | 中位数与 P95 | 保留长尾任务 |
| 有效交付成本 | 全部成本/验收通过数 | 包含失败尝试的消耗 |
| 恢复质量 | 页面变更、登录过期和重复执行 | 检查错误状态与结果污染 |
固定回归测试适合 Playwright;日常账户操作需要扩展桥接或专用运行时;页面探索需要 Agent 决策;公开内容采集需要提取管线;多实例任务需要云浏览器设施。具体系统具有组合需求。
我的工程判断是:选型的起点是任务契约,验收的终点是业务结果。模型、浏览器和工具接口承担各自职责,结果校验器承担交付判定。
参考资料
- 控制与接口:Playwright 定位、CDP 连接、Playwright MCP、Chrome DevTools MCP。
- 本地运行环境:OpenCLI、Ego Lite、BrowserOS。
- 决策与基础设施:Browser Use、Stagehand、Steel、Cloudflare Browser Run。
- 数据与网站接口:Crawl4AI、Firecrawl、WebMCP 开发文档。
- 选题线索:浏览器自动化路线讨论。产品事实采用上述项目资料,架构与校验代码为本文的工程示例。
