Concitech AI · 深度长文
2026/10/20 10:07
AI 代码文件的 5000 Token 警戒线:一条提交规则,管住什么?
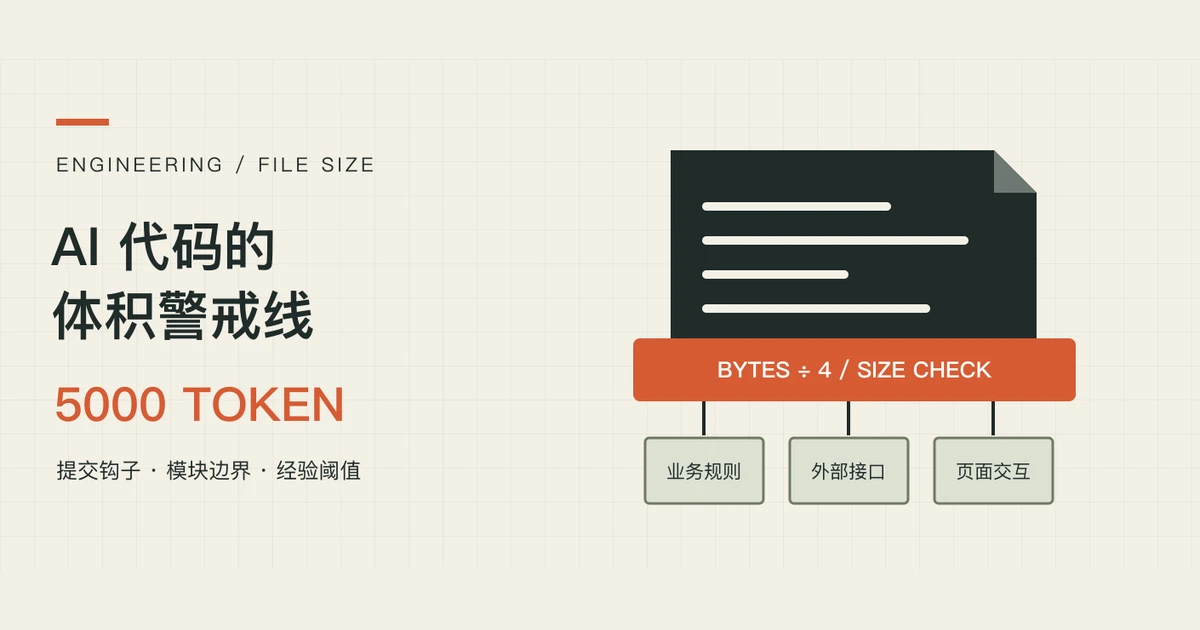
Matt Pocock 提议设置 pre-commit 钩子,拦截估算体积超过 5000 Token 的代码文件。本文介绍规则、讨论中的质疑与证据边界,解释文件体积、模块边界和上下文成本的关系,补充 Git 暂存区检查与生成文件豁免。
一个功能完成了,测试通过了,承载它的文件增加了几段代码。
生成代码的成本下降,理解代码的成本缺少同等幅度的下降。一个文件容纳页面、数据请求、权限判断和状态转换,下一次修改需要寻找的线索增加了。
Matt Pocock 的推文日期是 2026 年 10 月 18 日。他给出一条工程建议:设置 pre-commit 钩子,拦截估算体积超过 5000 Token 的文件,估算公式为字节数除以四。检查对象是暂存文件,锁文件与代码生成产物属于排除项,错误消息需要包含拆分指导。原推文
这条建议的讨论价值,集中于两个问题:文件体积是否值得设门槛,5000 这个门槛有什么依据。
一、5000 是经验值,证据强度需要分清
原帖是一条工作流建议,缺少实验设置、任务样本、成功率对照和收益测量。5000 Token 属于作者选择的阈值,含义区别于模型能力的分界线。
AI Coding Weekly 的讨论整理收录了一条质疑:Agent 具有搜索、局部阅读和局部编辑能力,大文件造成的困难需要什么证据支持?该整理记述的作者回应属于个人使用感受。本文取得了原帖,原始评论页读取失败,回复的原始核验存在缺口;这份整理提供争议线索,技术结论需要独立依据。讨论整理
这个质疑有价值。文件长度、任务上下文长度和理解难度,是三个不同变量。
一个大文件具有清楚的内部职责,目标函数拥有完整局部信息,一次修改具备局部阅读条件。几个小文件共享隐式状态、循环依赖和分散规则,一次修改涉及的知识范围,具有扩大空间。
文件变小,结构质量需要另一组证据。
“字节数 ÷ 4”属于估算规则。5000 对应 20000 字节,单位是十进制字节,换算值为 19.53125 KiB。中文注释、标识符、字符串与不同模型的分词器,影响估算误差。Anthropic 的文档提供 Token 计数接口,其计数依据是指定模型的分词器。Token 计数文档
这类钩子的准确称呼是“文件体积门槛”。精确 Token 预算属于另一种需求。
二、小文件的收益,来自明确的职责
设想一个订单管理页面。一个文件包含列表展示、退款规则、支付请求、筛选状态和权限检查。AI 接到“增加部分退款”任务,修改范围涉及业务判断、接口和界面反馈。
这种结构让一次修改承担数种职责。评审者需要辨认业务规则与页面细节,测试需要触达业务分支,错误排查需要寻找状态的拥有者。
一种拆分方案是:退款规则拥有独立函数,支付服务拥有外部接口,订单页面承担展示和交互。模块边界的价值来自变化原因的分离。
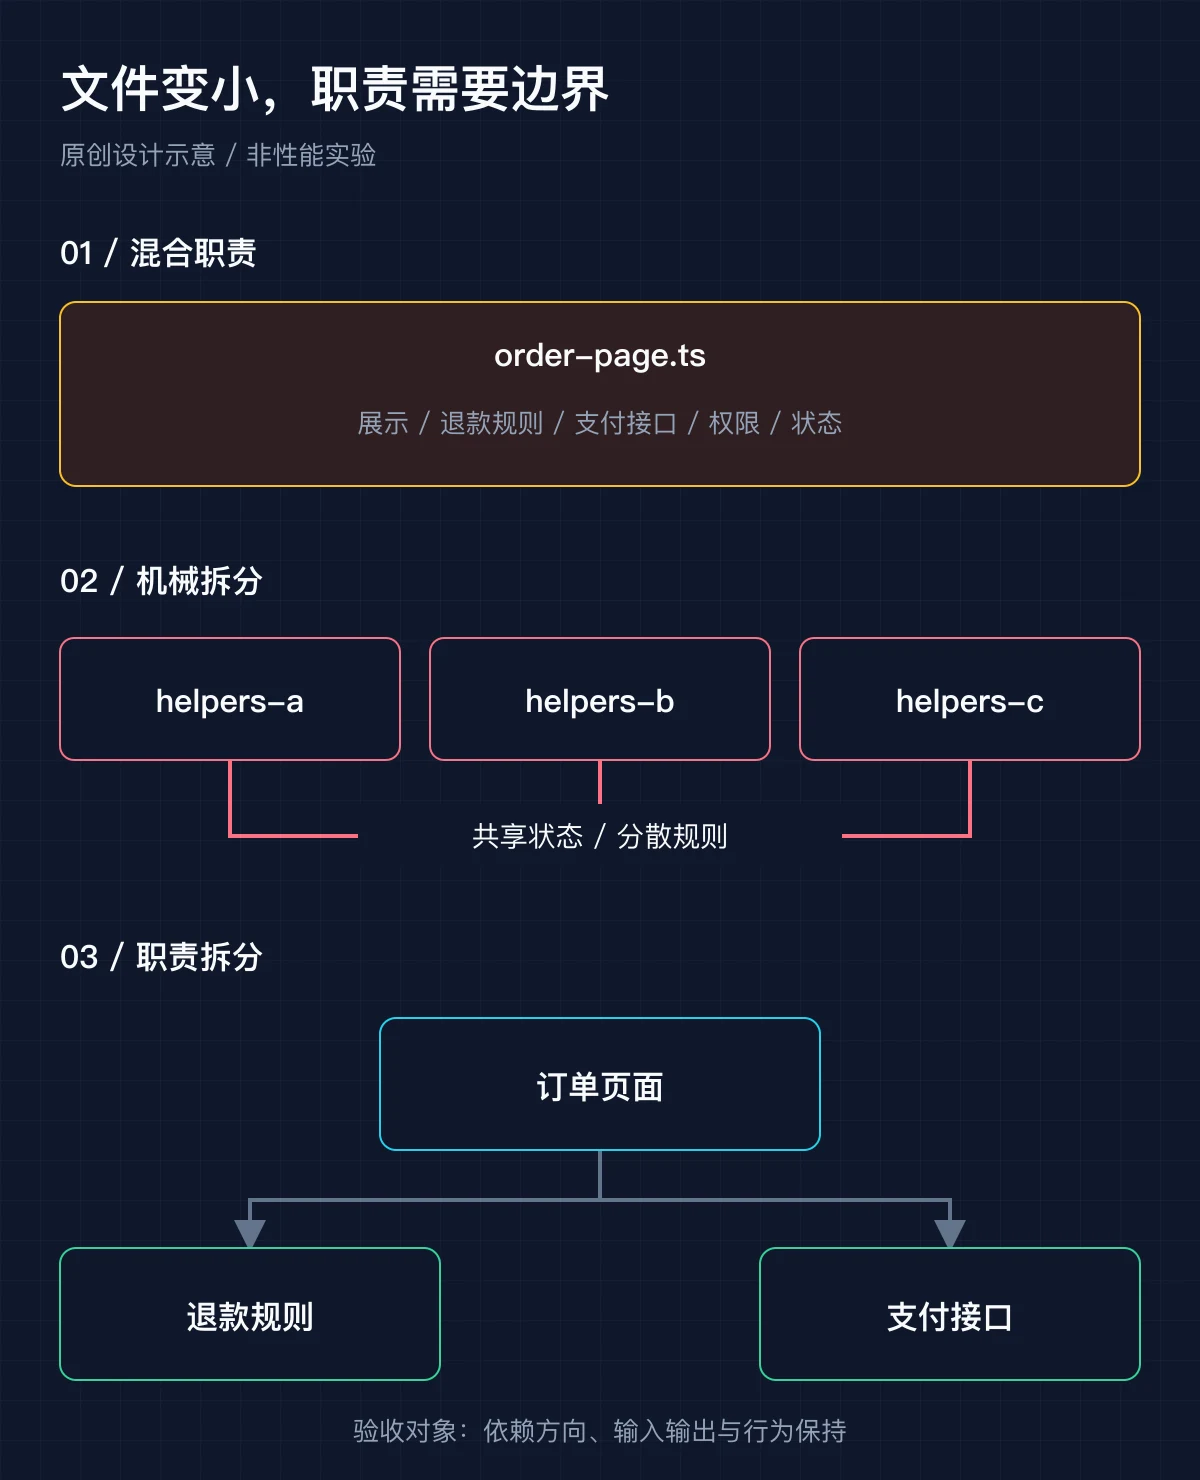
另一种拆分产生 helpers-a.ts、helpers-b.ts 和 helpers-c.ts。这些文件存在相同共享状态,调用者需要理解整条调用链。文件数量增加,隐式耦合保持原样,导航成本增加。
本文判断,体积门槛适合触发一次设计检查。检查的问题是:这个文件是否拥有清楚的职责,目标行为涉及哪些依赖,拆分是否减少一次修改需要理解的知识。
“超过门槛”是一条风险信号。“低于门槛”缺少质量认证的含义。
三、钩子需要检查暂存区,磁盘文件属于另一份内容
这条建议存在一个实现陷阱:暂存文件名与暂存文件内容,属于两个检查步骤。
开发者执行部分暂存,Git 索引保存提交候选内容,磁盘文件保留其他修改。钩子采用暂存文件名和磁盘内容的组合,检查对象产生了错位。
一个例子是:暂存区保存 24000 字节,工作区文件缩减成 12000 字节,缩减部分的暂存状态是待处理。磁盘检查报告通过,提交候选内容超过门槛。反向情况产生误拦截。两种情况源于内容版本差异。
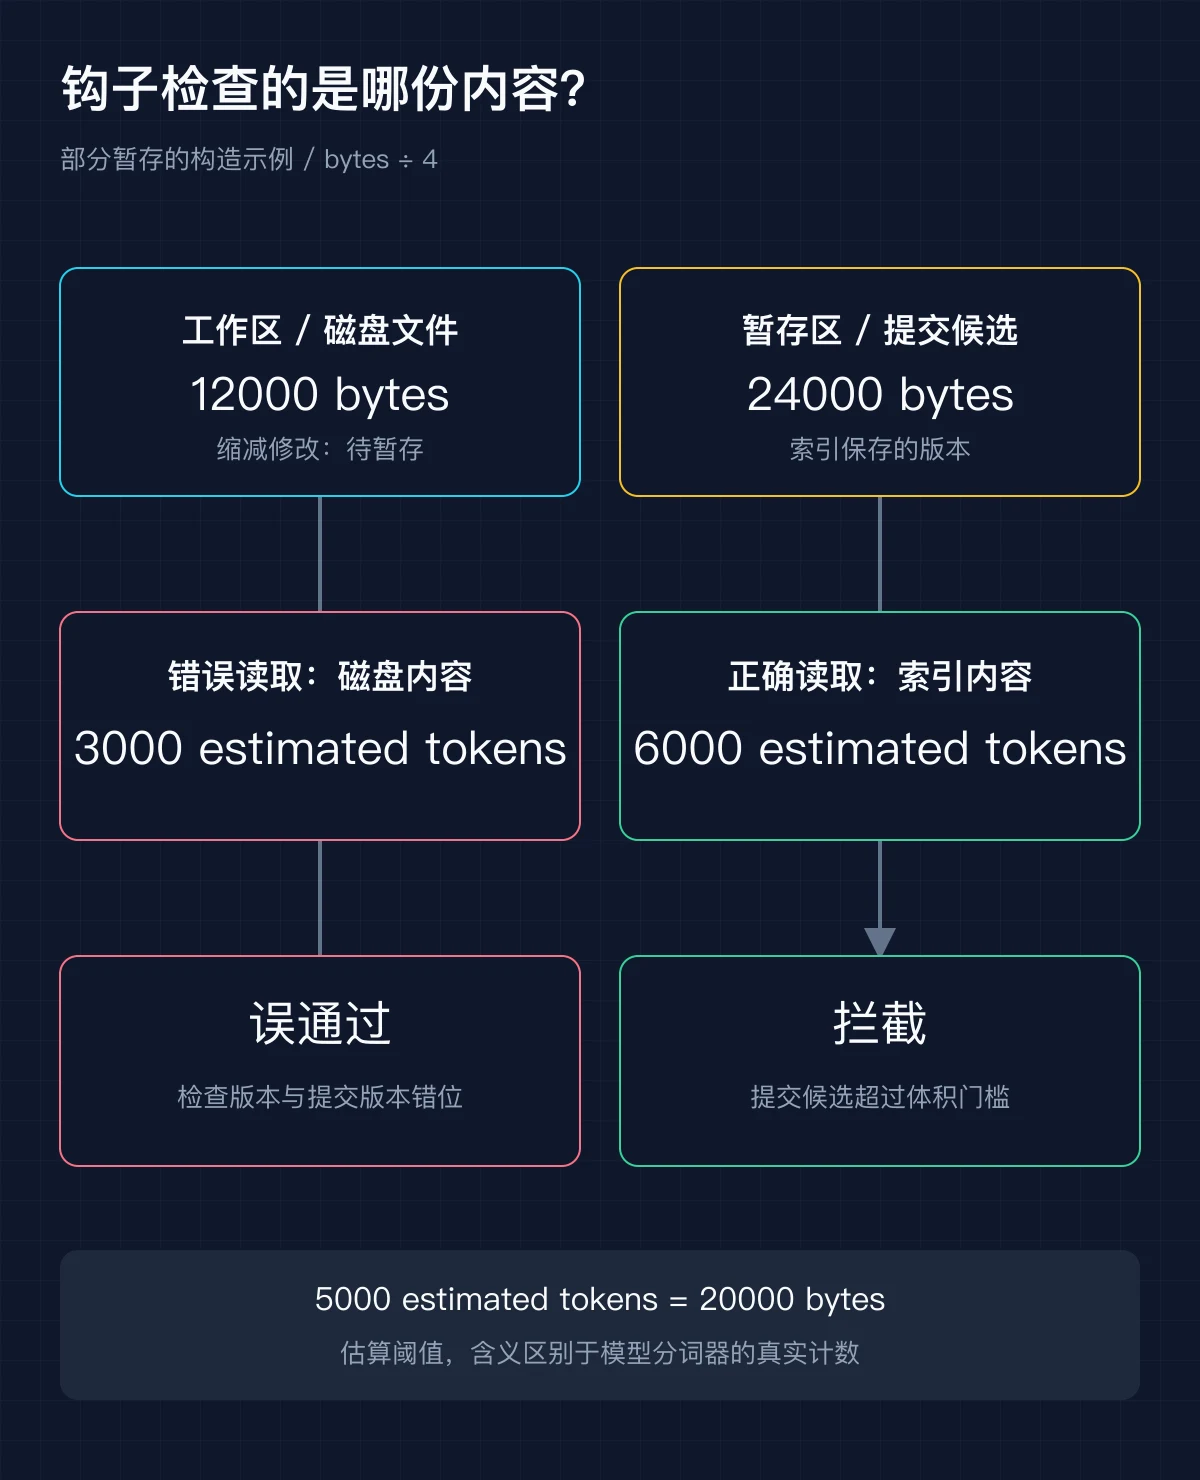
Git 文档说明,git diff --cached 比较暂存变更与指定提交,默认参照是 HEAD;:0:路径 表示索引中对应路径的常规阶段内容。暂存变更 · 索引对象语法
一个实现的输入与读取方式如下,命令片段的性质是实现要点,完整钩子需要错误处理和测试:
# 暂存变更的路径列表;NUL 分隔
git diff --cached --name-only --diff-filter=ACMR -z

# 示例路径的暂存内容
git show ':0:src/order.ts'
路径解析需要保留 NUL 分隔,解析结果需要保持文件名中的空格与换行。内容读取需要校验文件类型,二进制、符号链接、子模块和冲突状态需要独立策略。
检查器的工作是读取与报告。git add、工作区修改和文件拆分属于写入操作,具有改变提交范围的副作用,超出了体积检查的职责。
四、错误消息需要给出改法,豁免需要给出理由
一个“文件超限”的报错,缺少修复入口。Agent 获得数字,结构判断标准存在缺口,压缩空白、删除注释和机械切文件具有取巧空间。
一个实用的错误报告需要四项内容:路径、暂存字节数与估算值、阈值、拆分建议。这份示例输出采用假设数字:
路径:src/order-page.ts
暂存大小:28400 bytes
估算体积:7100 tokens(bytes / 4)
门槛:5000 estimated tokens

修复建议:
识别退款规则、支付接口与页面状态的职责边界。
提取具有清楚输入输出的业务模块。
保留对外行为,执行受影响测试。
提交候选内容需要复检。
原帖要求排除锁文件与代码生成产物。这是文件用途的划分,含义区别于识别代码的实际作者。Git 的文件内容缺少可靠的“AI 创作”标签,人工与 Agent 混合编辑构成另一层复杂性。
团队需要一份明确的路径策略:哪些目录属于手写代码,哪些文件属于生成产物,哪些例外具有负责人和理由。一个宽泛的 generated/ 排除项具有误用空间,目录名称缺少来源证明。
豁免负责解释特殊情况,评审负责检查豁免本身。锁文件和生成文件适合排除体积检查,其安全性、依赖变动与生成流程需要其他检查覆盖。
五、门槛需要观测,团队规则需要执行位置
Git 的官方文档说明,pre-commit 钩子的非零退出状态中止提交,--no-verify 选项具有绕过能力。本地钩子是一道反馈机制,强制治理需要其他执行位置。Git 钩子文档
本文建议的团队方案包含五项:
- 统计手写代码的文件体积分布,记录当前大文件及其职责。
- 建立告警阶段,收集误报、拆分成本和例外原因。
- 确定阻断范围,区分新增超限、历史存量与体积增长。
- 配置本地检查和 CI 检查,统一规则与例外清单。
- 比较任务成功率、评审耗时、上下文消耗与回归缺陷。
CI 的检查对象是待评审提交内容,其实现需要区别于本地暂存区检查。历史存量的处理需要项目决策,避免一个小修复承担整份旧文件的改造成本。
上面的方案属于本文建议,原帖提供的是钩子提示词,缺少完整团队落地方案。效果判断需要实际观测,本文缺少“5000 优于 8000”或“拆分提升某个百分比”的实验依据。
这条规则提供了一个低成本入口:文件增长触发检查,检查促使团队解释职责边界。评价标准是后续修改需要多少理解、评审需要多少时间,以及交付是否保持正确。Token 数承担告警职责,工程判断承担设计职责。
