Concitech AI · 深度长文
2026/10/13 09:49
AI 写完了代码,团队欠下了“理解债”
AI 辅助修复的 Bug 通过了测试,提交者缺少设计依据与调用链知识。理解债是代码产出与团队认知之间的缺口。本文讨论测试的边界、AI 解释的误区,以及问题复现、方案取舍、行为边界、排查回滚四项交付材料。
我遇到一件事。
一个新人提交了 AI 辅助修复的 Bug。代码能跑,测试通过,页面表现正常。
Review 的问题是:这次修改的设计依据是什么?这个状态的归属理由是什么?受影响的调用链有哪些?
他沉默了。
Bug 有了修复方案,提交者缺少解释方案的能力。合并按钮、绿色测试、正常页面,构成了交付完成的证据;它们缺少一项信息:团队对这次修改的理解。
这件事让我关注一个词:理解债。
Addy Osmani 的文章《Comprehension Debt》讨论了这个问题。理解债指系统代码与人类理解之间的缺口。代码增长速度超过团队理解速度,是这个缺口的来源。概念原文
我的关注点是代码交付的验收标准。交付物需要包含可运行的实现、设计依据和排查入口。AI 承担代码生成,提交者承担解释与验证责任。
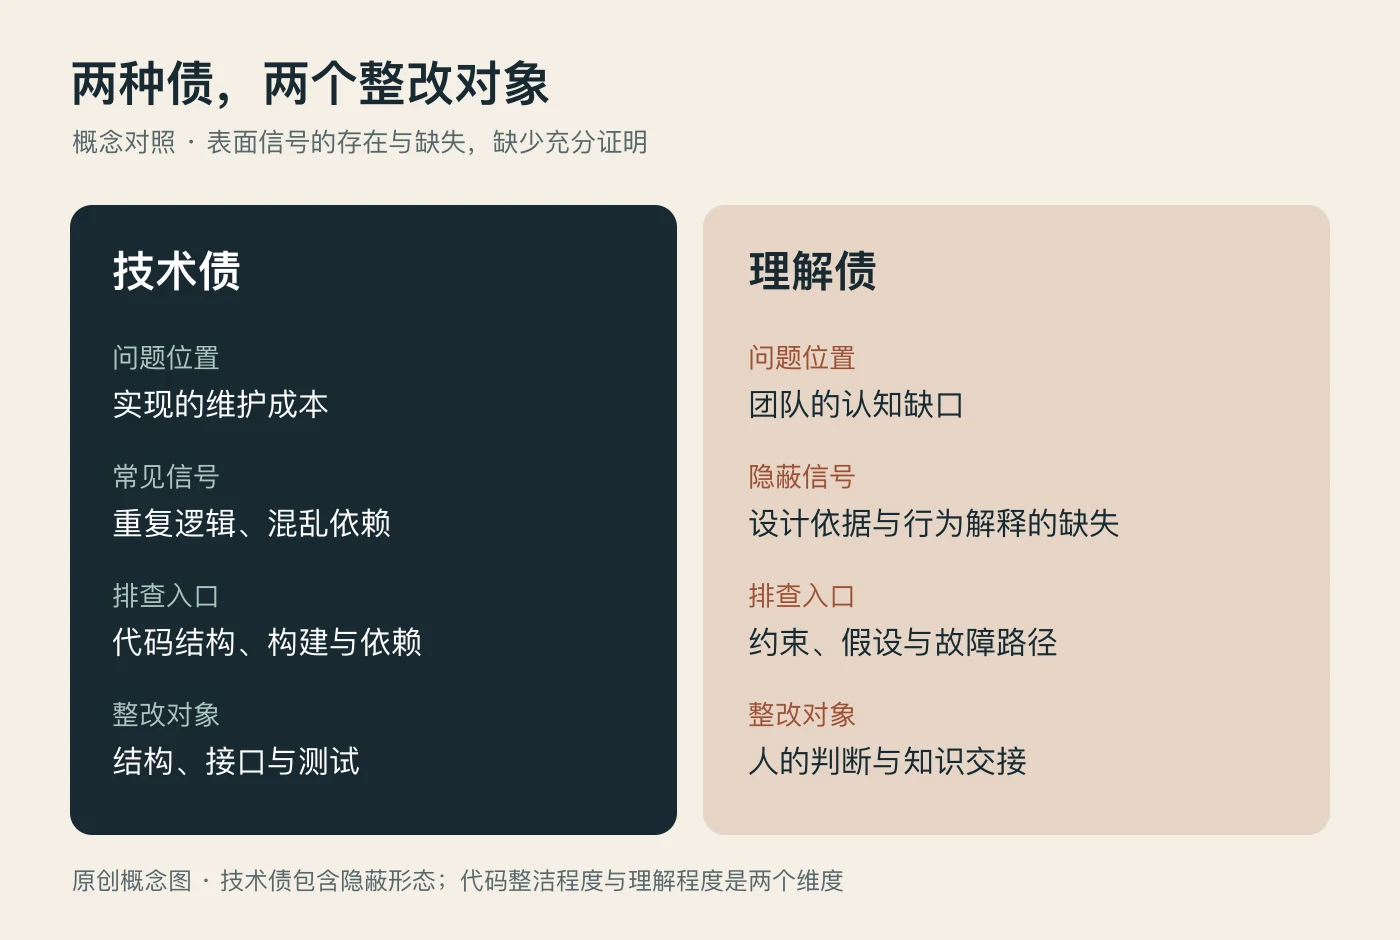
技术债与理解债,欠款的位置不同
技术债涉及实现的维护成本。重复逻辑、混乱依赖、临时方案、缓慢构建,是常见信号。技术债包含隐蔽问题,“代码混乱”与“技术债”之间缺少一一对应关系。
理解债涉及团队的认知缺口。
一段代码的格式、命名、模块划分符合规范,测试结果正常。团队成员缺少这段代码的设计背景、业务假设和故障排查路径。这是理解债的一种表现。
代码的整洁程度与人的理解程度,是两个维度。
一个老模块有重复代码,维护者记得业务约束和历史事故。另一个新模块有漂亮的接口,维护者缺少状态变化的解释。前者有实现上的改进空间,后者有知识上的缺口。
这项区分影响整改方式。重构解决结构问题;设计复盘、调用链核对、故障演练解决认知问题。理解债的偿还需要人建立判断,文档生成属于材料准备。
测试通过,证明了什么
测试通过,说明实现满足这组测试的判定条件。测试的覆盖范围决定这份证据的范围。
一个权限缓存的例子能说明区别。
需求是用户退出登录后,旧权限失效。实现增加一个共享缓存,测试验证首次访问、重复访问、正常退出。测试结果是绿色。
未覆盖的场景包括账号切换、多个标签页、权限撤销、请求竞态。缓存的生命周期、失效规则、租户隔离,决定这些场景的行为。
这个例子是工程示例。它说明验收问题的两个层次:已有测试检查了什么,业务要求包含什么。
测试设计者需要理解业务约束。缺少约束知识的测试,包含错误预期的风险。一次 AI 修改包含实现变化与匹配新行为的测试断言,绿色结果存在接受错误行为的风险。
Review 需要检查断言变化的业务依据。一次测试更新是需求变化,还是实现迁就?答案需要需求、代码和运行证据的相互核对。
测试提供行为证据。人的理解负责判断证据与需求的关系。
AI 解释与人的理解,是两件事
AI 对新人有帮助。调用链说明、术语解释、历史代码梳理,是学习材料的来源。新人拥有问题意识,AI 提供了问答入口。
风险是解释文本替代了人的判断。
一份流畅的说明包含设计动机、模块边界、性能理由。代码实现与这份说明的关系,需要核验。历史约束、仓库外的业务规则、某次事故的背景,属于模型输入的缺失项。
理解的检验需要反例。
用户切换账号,状态的变化是什么?服务返回错误,哪一层承担恢复?两个请求交换完成顺序,结果是什么?一次回滚撤销了代码,数据变化的处理方式是什么?
这些问题要求提交者预测行为、定位实现、寻找证据。照读一段解释,缺少这样的检验。
Anthropic 的一项研究提供了相关证据。52 名软件工程师参与了 Python Trio 库的学习任务。AI 组的即时测验平均成绩为 50%,手工编码组为 67%,差距是 17 个百分点。完成时间的差异未达到统计显著。研究说明
研究记录了不同的 AI 使用模式。概念提问、代码解释等模式与较高成绩存在关联,重度委托与较低成绩存在关联。模式分析缺少因果结论。
这项研究的边界是小样本、新库学习和即时测验。实验工具是侧边栏 AI 助手,结论的适用范围限于实验条件;长期技能变化与其他编程 Agent 的影响属于研究的未解问题。
它支持的提醒是学习过程需要验收。一次任务的完成状态,缺少对知识获得的证明。
PR 需要四项理解交付物
我倾向于一个验收规则:提交者需要解释修改,解释需要证据。
这项规则适用于 AI 代码和人写代码。AI 代码增加了关注的必要性,作者类型与责任豁免缺少关系。
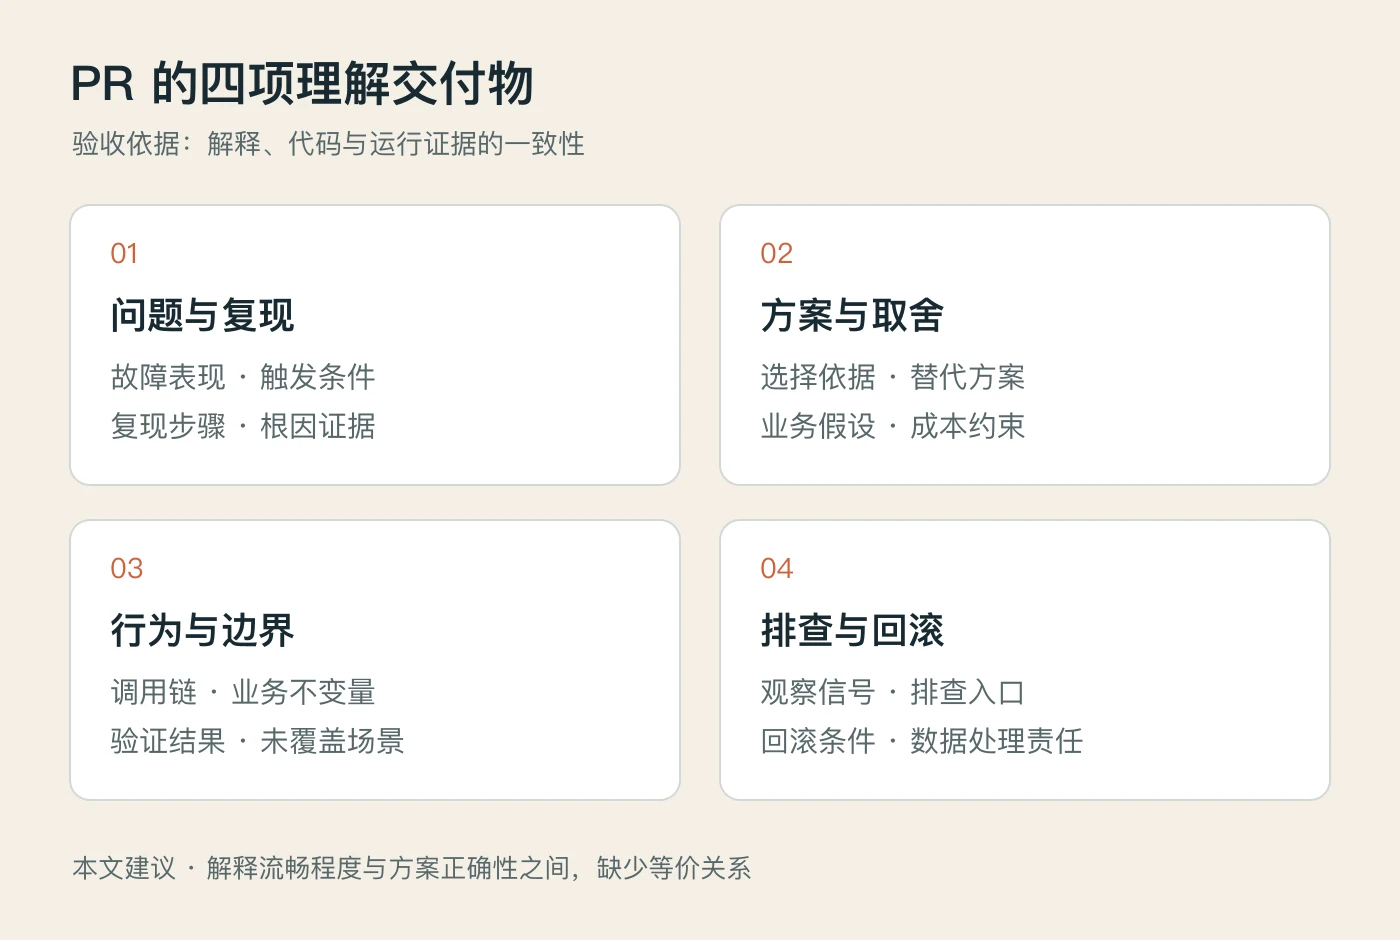
一份 PR 的理解材料包含四项。
- 问题与复现:故障表现、触发条件、复现步骤、根因位置。
- 方案与取舍:选择依据、替代方案、依赖的业务假设。
- 行为与边界:改变的行为、受影响的调用链、需要保持的行为、未覆盖场景。
- 排查与回滚:观察信号、排查入口、回滚方式、残留数据的处理责任。
这些材料的价值来自核对。根因对应日志或复现结果,调用链对应代码路径,行为边界对应测试或人工验证,回滚方式对应执行条件。
PR 作者填写了一份模板,审核者看到了完整段落。理解验收需要内容核对。模板的存在是流程证据;解释与代码的一致性是内容证据。
一份简短的提交说明包含这样的信息:
问题:账号切换遗留了旧权限缓存。
方案:缓存的归属范围改为会话;会话结束触发清理。
边界:正常切换与权限撤销有验证记录;多标签页同步是未覆盖项。
排查:观察会话标识与缓存命中日志;回滚需要兼容新增缓存键。
这段文字是示例。具体项目需要具体证据,示例本身属于说明材料。
理解验收需要风险分层
一个按钮的文案修改,一次支付状态机调整,承担的风险不同。相同长度的解释要求,缺少效率依据。
低风险修改需要说明行为变化和验证结果。权限、支付、并发、数据迁移等高风险修改,需要覆盖业务不变量、失败路径、恢复条件和责任人。
审核者的时间需要分配。一次包含大量文件的 AI 修改,适合拆成有行为边界的变更。拆分的依据是责任范围与验证条件,文件数量属于参考信息。
提交者的认知缺口与能力评价是不同问题。陌生代码库、缺失的历史记录、模糊需求、交付压力,是认知缺口的常见来源。
团队的任务是提供学习入口。新人需要可核对的上下文,资深工程师需要解释约束的时间,管理者需要承认理解工作的成本。交付指标需要包含知识交接的验收结果。
某个模块依赖一位维护者的记忆,团队缺少替代排查人,这属于知识集中风险。一次 PR 的解释需要进入共享记录,另一位维护者需要具备定位问题的能力。
代码作者有更替,模型有更替,责任人的安排需要明确。
“完成”的定义需要包含理解
那个新人修复的 Bug,交付状态有两个答案。
功能修复有了结果,知识交接缺少结果。
AI 生成代码的价值是实现能力。团队维护软件的能力,包含判断、解释、定位和恢复。两者之间的连接,需要提交者与审核者完成。
我的验收标准是:代码有验证证据,设计有选择依据,影响有边界说明,故障有排查入口。提交者的解释接受代码与反例的检验,团队获得可交接的知识。
一次合并的交付物,是实现和理解。
参考资料
新人修复 Bug 的案例来自本文作者提供的经历;权限缓存和提交说明属于解释用示例。PR 验收方案属于本文建议。
