Concitech AI · 深度长文
2026/10/21 06:31
AI 评测的 0.5 陷阱:分数、阈值与告警成本
AI 裁判的分数、告警阈值与失败概率属于三个问题。本文核对决策模型评测的样本与成本,借助八条假设数据解释精确率、召回率、误报与漏报,介绍阈值验证、概率校准和上线记录。
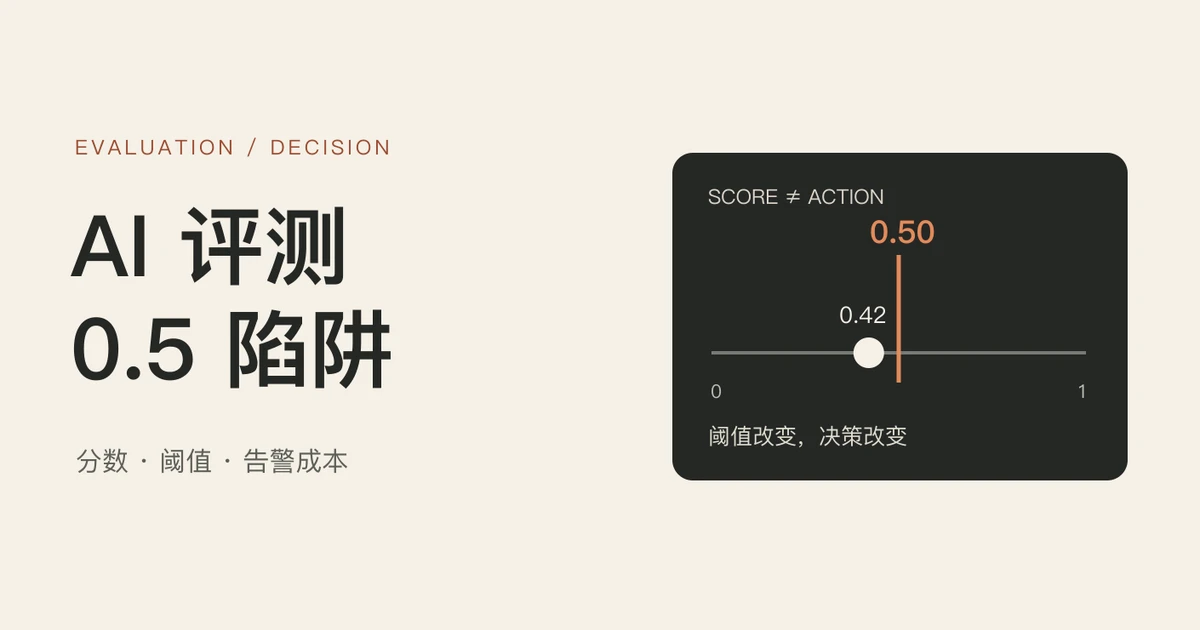
一个假设案例:Agent 执行记录出现了预约失败。评测模型给出 0.42 的失败分数,系统的告警阈值是 0.5,结果是“通过”。
这是模型识别能力的问题,还是告警规则的问题?
Hamel Husain 与 Antaripa Saha 的新文章讨论决策模型评测:样本为租房 Agent 轨迹,性能统计包含 98 条记录,其中失败 61 条、其余 37 条。文章的重点是模型选择、阈值和分数解释。原文
本文的决策模型指评测链中的分类器:输入是执行记录,输出是失败分数。这个案例带出三个问题:模型区分什么,系统拦截什么,分数代表什么。三者需要各自的证据。
一、0.5 是规则,缺少“正确答案”的地位
二分类评测包含两层:模型产生分数,决策规则产生“通过”或“失败”标签。scikit-learn 的文档区分了统计预测与行动决策;阈值选择属于后者。阈值文档
本文采用这样的定义:正类表示失败,高分表示强失败倾向;告警条件是分数大于或等于阈值。接口中的“成功概率”需要另一套方向定义。
以下八条数据属于本文构造的教学样本,缺少真实模型测评的含义:
| 记录 | 人工标签 | 失败分数 |
|---|---|---|
| A | 失败 | 0.48 |
| B | 失败 | 0.44 |
| C | 失败 | 0.38 |
| D | 失败 | 0.31 |
| E | 通过 | 0.42 |
| F | 通过 | 0.25 |
| G | 通过 | 0.12 |
| H | 通过 | 0.08 |
阈值 0.50 对应零条告警、四条漏报。阈值 0.30 对应五条告警,其中四条是真实失败,一条是误报。
模型、输入和分数保持相同,标签结果发生变化。变化来自决策规则。
精确率表示告警中的真实失败比例,召回率表示真实失败的检出比例。F1 是两者的调和平均。指标定义
| 阈值 | 精确率 | 召回率 | F1 |
|---|---|---|---|
| 0.50 | 无定义 | 0% | 0 |
| 0.40 | 66.7% | 50% | 0.571 |
| 0.30 | 80% | 100% | 0.889 |
| 0.10 | 57.1% | 100% | 0.727 |
0.50 行缺少预测正类,精确率的分母为零;表格保留“无定义”,避免“零误报就是高精度”的误解。
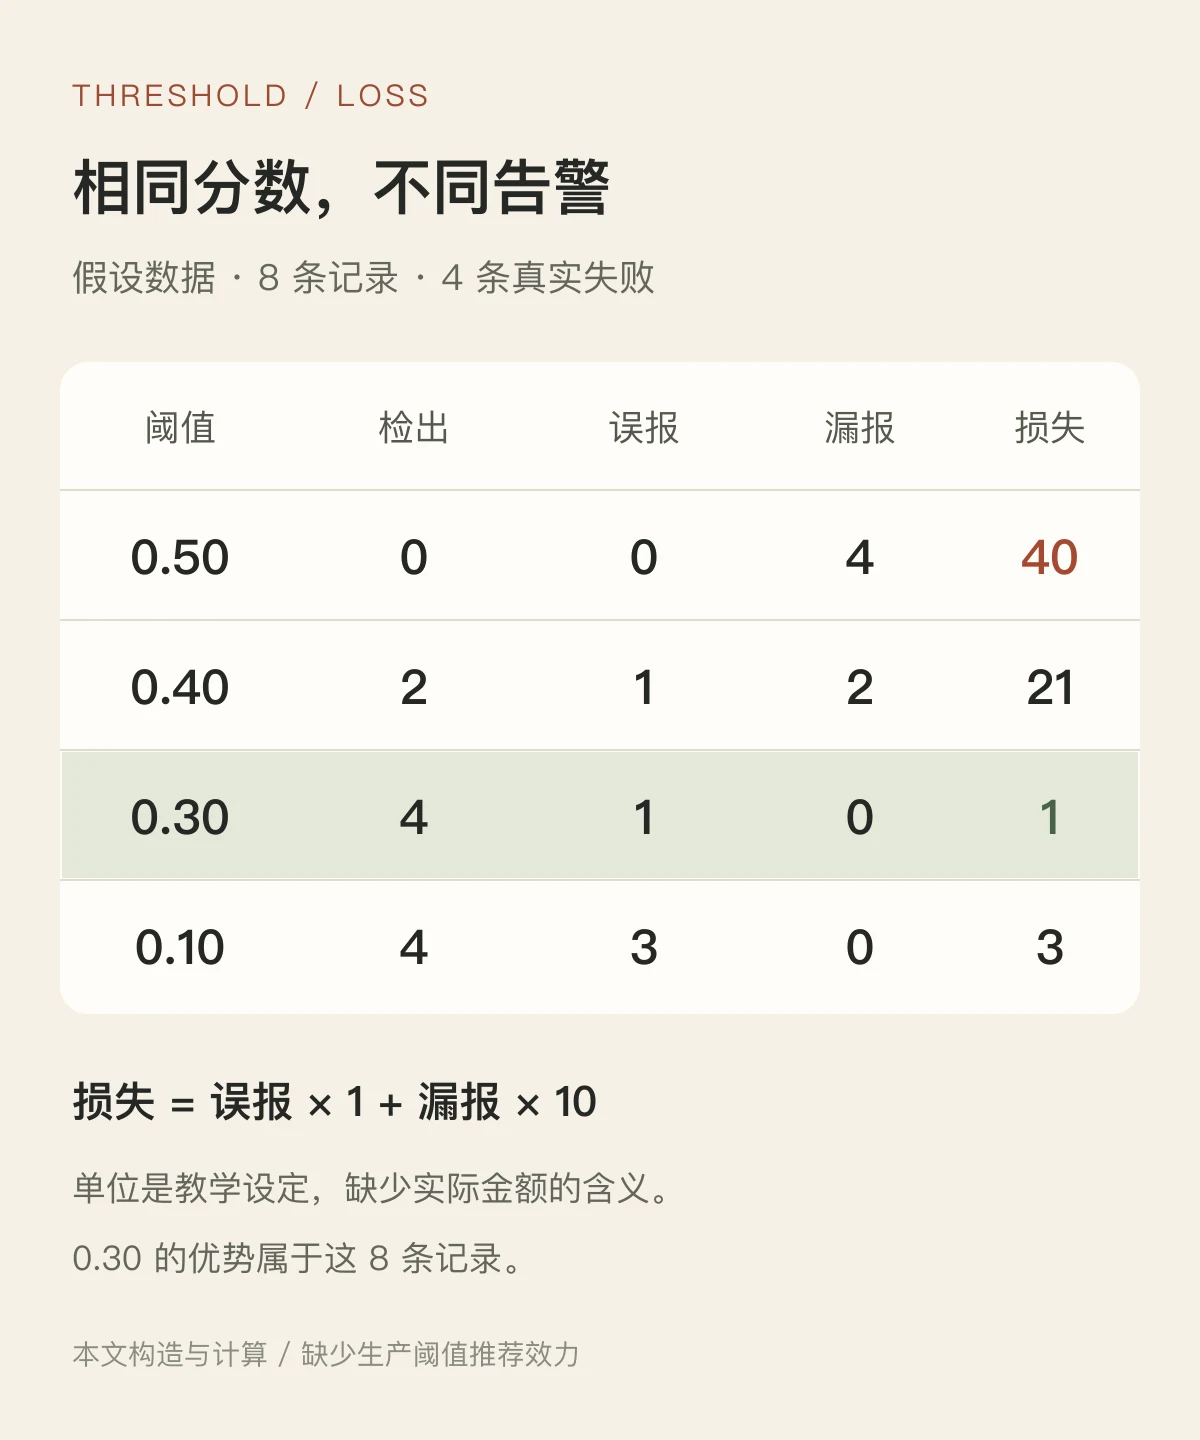
这组样本中的 0.30 得分最高。这个结论的适用范围是八条假设记录,缺少生产阈值的推荐效力。新样本需要验证。
二、F1 与业务损失,属于两种目标
误报和漏报具有不同代价。
误报占用人工复核队列,漏报意味着预约失败、错误订单或遗漏的人工转接逃过检查。模型的调用费用属于第三项成本。
假设某个系统的误报代价为 1 单位,漏报代价为 10 单位,损失函数为:
总损失 = 误报数量 × 1 + 漏报数量 × 10
上述样本的四个阈值对应 40、21、1、3 单位损失。两项阈值的召回率是 100%,0.10 增加了两条误报。
这些单位属于教学设定,含义区别于实际金额。真实代价需要业务记录:复核耗时、事故损失、重试开销,以及告警处理容量。
F1 赋予精确率和召回率相同权重,业务目标具有自己的权重。阈值优化需要明确目标:最低损失、召回底线,或复核容量约束。业务代价与阈值示例
原文报告了两个候选模型的结果:
| 决策模型 | 验证 F1 | 100 次评测调用费用 |
|---|---|---|
| Perplexity Decider 1.1 27B | 0.79 | 0.0082 美元 |
| OpenAI Decisions | 0.87 | 0.0372 美元 |
费用统计包含 100 次调用,性能统计排除了两条内部 QA 记录。模型排序的范围是该任务与评测设置,缺少通用榜单的含义。实验说明与脚注
这张表提供了质量与调用费用的对照,人工复核费用、事故损失和线上吞吐属于其他指标。生产选型需要完整成本表。
三、阈值的验证,需要数据边界
“找一个 F1 最高的阈值”有两种结果:选出适合任务的规则,或者选出适合这批样本的规则。
二者的区别需要留出数据。
训练数据服务于模型或校准器拟合;阈值选择数据服务于规则调整;测试数据服务于冻结方案的最终检验。数据复用存在乐观偏差风险。交叉验证文档
小样本场景的一个选择是交叉验证:各轮的训练部分负责阈值选择,留出部分负责结果计算。报告需要包含各折差异、误报数量与漏报数量,平均分缺少全部信息。
原文的阈值审计具有一个重要细节:精确率、召回率的 80% 约束存在不可行训练折。100 个训练划分的不可行次数为:Perplexity 36 次,Liquid d1-ultra 29 次,OpenAI 零次;不可行折采用无约束 F1 最优阈值,验证汇总包含这些结果。审计数据
80% 是选择过程中的目标,缺少验证结果保证的含义。团队的报告需要“约束是否满足”这一列。
相似会话、同一订单的多段轨迹、同一问题的轻微改写,存在信息重复风险。本文的工程建议是设置样本组标识,使同组记录归属同一数据分区。模型升级、提示词修改和业务规则变更需要新的验证记录。
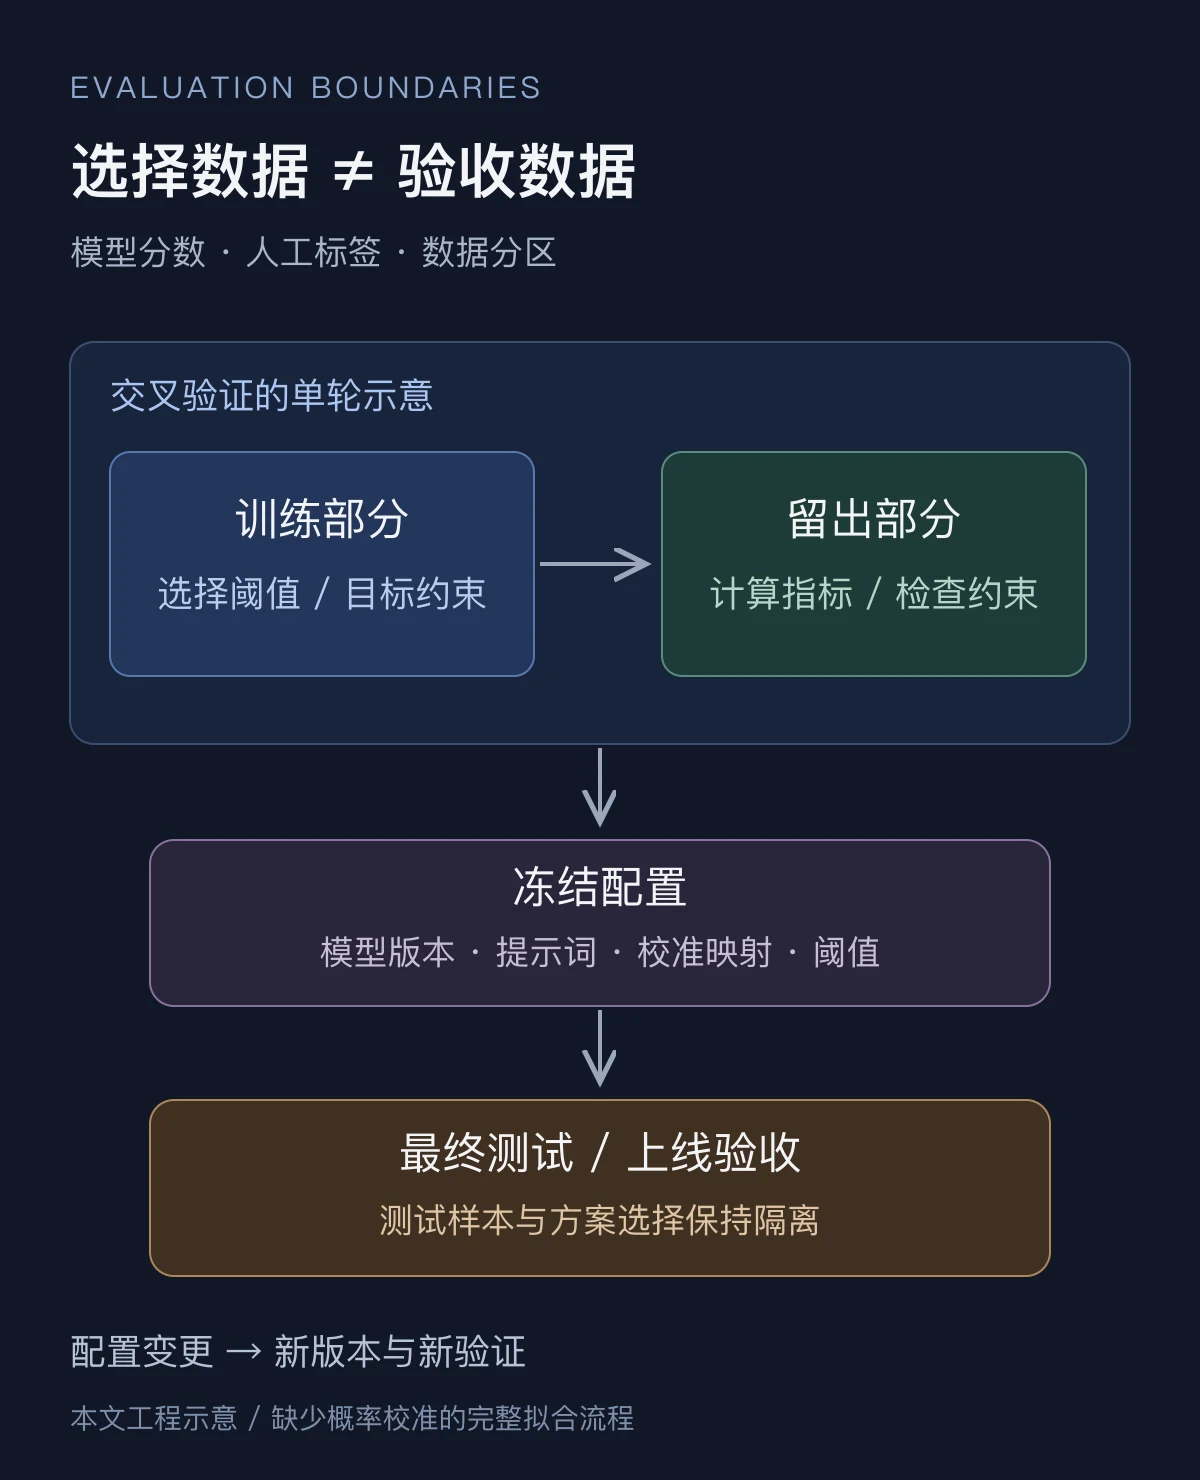
一份上线记录需要五项内容:
- 失败定义:业务错误的判定标准、正类方向、证据要求。
- 样本版本:来源、人工标签、失败占比、数据分区。
- 选择目标:损失函数、指标底线、复核容量。
- 冻结配置:模型版本、提示词、阈值、校准映射。
- 验收结果:测试集指标、错误样例、约束状态、监控规则。
这是本文的工程清单,含义区别于原作者的完整部署方案。
四、0.8 分与 80% 概率,缺少等号
排序能力回答“哪些记录具有高失败倾向”,概率校准回答“这类分数对应多少真实失败”。
假设一个分数组包含 100 条记录,平均预测失败概率为 0.8,真实失败数量为 80 条:这组数据体现了预测概率与观测比例的吻合。单条记录的 0.8 缺少这项证据。
可靠性图的横轴是分组平均预测概率,纵轴是分组真实失败比例。分组样本量属于解释条件:五条记录中的四条失败,与五百条记录中的四百条失败,具有相同的比例和不同的不确定性。概率校准文档
校准和阈值调整具有不同目的。前者处理分数的概率含义,后者处理标签与行动规则。排序能力的实用性与概率解释的欠缺存在共存情况;合适的阈值有助于决策结果改善,缺少概率校准完成的证明效力。
Brier 分数包含概率校准、区分能力和数据不确定性的影响。Brier 的下降与“校准得到改善”之间需要其他证据,可靠性图与留出结果有助于判断。
产品文案中的“失败概率 80%”,需要校准证据。缺少校准证据的产品,适合“失败分数”标签,概率承诺缺少支撑。
五、评测系统的验收对象,是完整决策链
模型分数属于中间产物。系统的交付结果是告警、复核与业务处理。
一份有效的评测报告,需要回答这样的具体问题:每日告警数量是多少,有处理价值的告警占比是多少,漏掉了哪些失败,人工队列的承接容量是多少,规则修改的影响范围是什么。
这些答案需要模型、标签、阈值和处理成本的联合记录。榜单分数提供候选名单,业务验证提供上线依据。
AI 裁判的采购清单有模型名称;AI 评测的验收清单需要阈值、数据边界和错误账本。
分数提供线索,规则决定行动,业务承担结果。
