Concitech AI · 深度长文
2026/10/13 21:13
AI 的新瓶颈:人的“带宽”
模型产出增加,需求转化、结果验收与成本控制决定人的接收能力。本文讨论“带宽”的工作含义,区分任务时长基准与自主运行时间,解释 Skill、Harness 和评估闭环的作用,给出需求、验收、成本与反馈四项自查材料。
Token 额度有余量,任务队列空着。
另一种情况是任务队列排满,结果堆积,审核者缺少验收时间。
前一种情况缺少值得执行的任务,后一种情况缺少接收结果的能力。增加模型调用,缺少对这两个问题的直接回答。
这涉及一种工作能力:人的“带宽”。
本文的带宽指一个人组织 AI 工作、验收产出、控制成本的能力。它是一种工作隐喻,区别于网络速率、Token 数量或行业统一指标。
模型产出与有效交付之间,需要需求、规则、验证和责任人。瓶颈环节造成任务等待、返工和审核成本,侵蚀预期收益。
提升这项能力,需要改进工作流程。消耗额度本身,缺少产出的价值证明。
任务时长,衡量的是哪一种能力
模型的长任务能力,存在概念误读。一次运行跨越几小时,一项任务对应人类几小时工作,一份结果达到交付标准,是三个问题。
METR 的任务时长研究提供了一个定义:任务的时间尺度来自人类专家的完成时间;50% 与 80% 时长指对应成功率的拟合结果。它衡量任务难度,区别于 AI 的自主运行时间。METR 方法说明
软件工程、机器学习和网络安全构成这套基准的主要任务,任务包含明确的输入与验收条件。真实项目包含历史背景、沟通和模糊需求,基准结果的适用范围需要保留。
一条“完成天级任务”的描述,需要说明任务定义、验收标准、失败情况与人工介入。运行日志的长度,缺少对可靠性的充分证明。
长任务能力的进展有价值。但一个人的工作效率,取决于具体任务与实际交付,基准时间缺少代替业务结果的资格。
需求能力决定任务入口
“做一个应用”提供了方向,缺少执行边界。
“做一个给客户提交资料的页面”增加了对象与动作,权限、文件格式、错误处理和交付条件需要补齐。
有用的任务材料需要包含预期结果、现有环境、约束和完成证据。模型需要知道目标,验收者需要知道判定方法。
一个任务的输入材料,决定 Agent 的探索范围。缺少背景的任务增加猜测,缺少边界的任务增加返工。提交者追求的结果,与模型推导的结果之间存在偏差风险。
需求转化是一项具体工作。它包括选择任务、拆分依赖、明确完成条件,决定哪些部分需要人的判断。
一个内容工作流是例子。资料收集、事实核查、正文编辑、图片检查、发布确认,有不同的输入与验收对象。一个笼统的“写好并发布”,缺少每个环节的责任说明。
任务的数量需要对应任务的价值。空任务消耗计算资源,模糊任务占用审核时间。一个人的问题储备,需要包含值得解决、拥有材料、具备完成条件的任务。
Skill 与 Harness,承接的是工作状态
本文的 Skill 指可复用的任务规则与材料。Harness 指模型的运行框架,负责工具调用、工作状态和执行流程。
两者的价值是减少上下文的遗漏,提供执行与交接的结构。它们的存在,缺少对模型正确性的保证。
Anthropic 的长任务工程方案使用功能清单、进度文件和 Git 记录,帮助不同会话接续工作,并安排增量实现与端到端验证。这是一套工程实践,适用性需要任务验证。长任务 Harness 说明
人的工作对应另一侧:验收规则的维护、工具权限的安排、失败状态的处理、历史记录的核对。
一份 Skill 收集了多个案例,但案例缺少版本与适用条件,调用者需要解释差异。一套 Harness 保存了大量日志,但完成状态缺少证据,验收者需要寻找结果。
可复用的材料,需要维护。记录需要提供可信的执行起点,材料的数量缺少对这项质量的说明。
验收能力决定产出出口
Agent 写完了代码,编译通过。业务行为的验证,需要测试与操作记录。
Agent 完成了文章,段落完整。事实、图片和语气的验证,需要来源与编辑判断。
Agent 声称完成了发布。页面的存在、正文的准确性、图片的可访问性,需要结果证据。
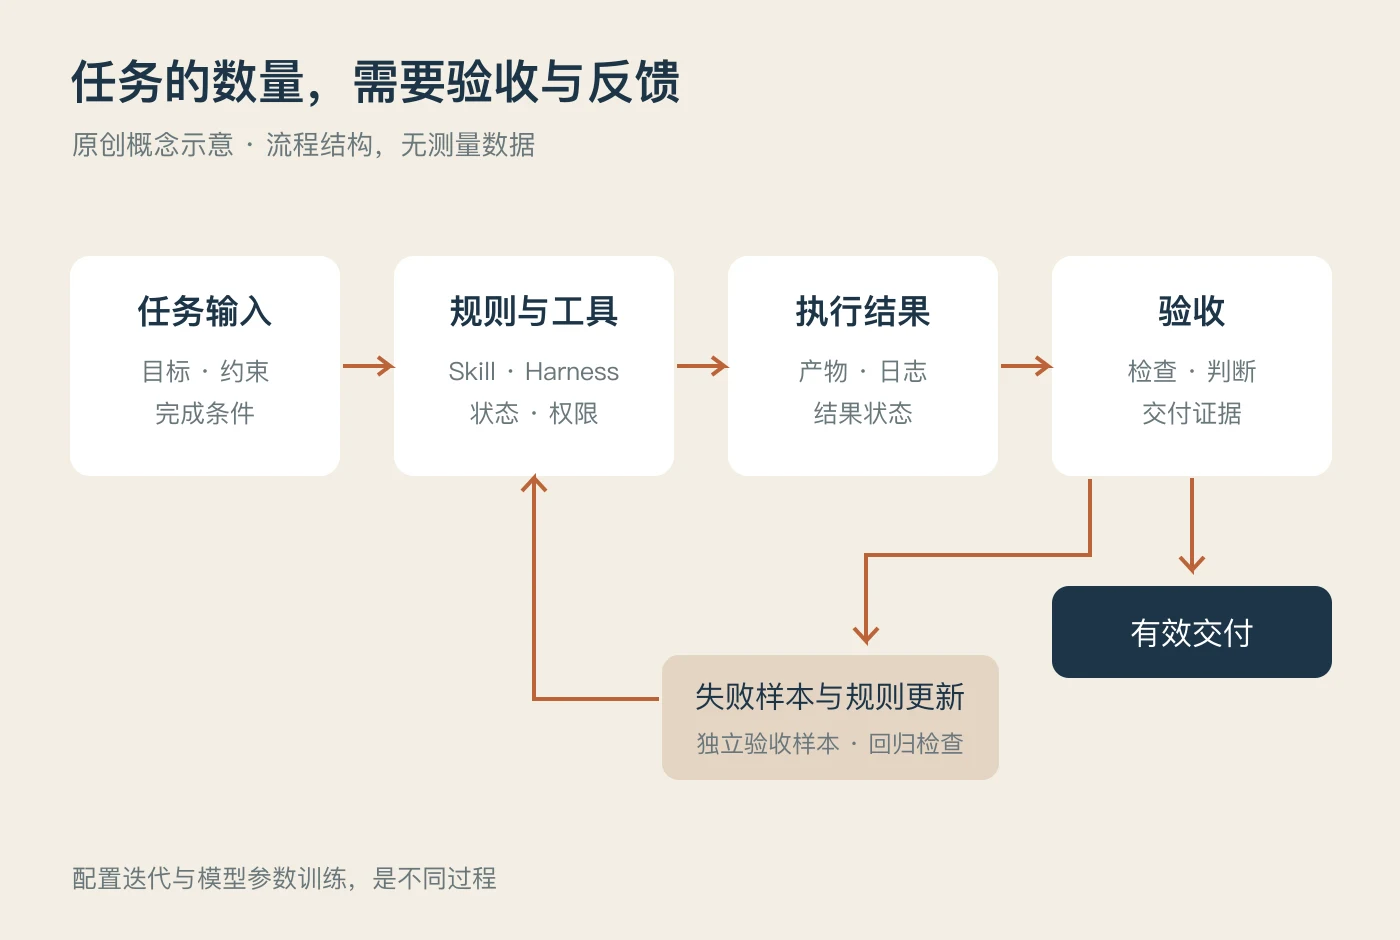
不同任务有不同的完成标准。模型的自述,是过程材料;环境的最终状态,是交付材料。
Anthropic 的评估指南区分任务、执行记录与最终结果,讨论代码评分、模型评分和人工判断的组合。模型评分需要人工校准,测试需要对应目标。Agent 评估指南
一个人的审核精力有上限。验收规则需要区分机器可检查的条件与人需要判断的部分。文件存在、页面返回状态、数据字段完整性,适合确定性的检查。观点的论据、产品的取舍、业务边界,需要人承担判断。
验收的拆分有一个收益:人的时间集中于关键的不确定性。它有一个风险:规则遗漏的部分失去关注。因此,失败样本和人工抽查需要进入维护流程。
高带宽的表现,是结果拥有清晰的验收路径。任务结果的数量,缺少替代这条路径的资格。
Token 预算需要一个成本分母
Token 是投入,合格交付是结果。
一次调用的成本,缺少对整项任务成本的充分说明。重试、上下文补充、评分、返工和人工审核,属于任务的成本构成。
同样的预算,产生的结果有不同价值。一组未经核验的草稿,与一份通过验收的交付物,缺少可比性。成本核算需要一个分母:通过验收的交付数量。
成本记录的内容包括总消耗、失败原因、人工介入和交付状态。额度消耗比例提供使用量线索,两种记录回答不同问题。
预算分配需要对应风险。材料检索与格式检查,允许轻量的验证流程;权限变更、付费操作、公开发布,需要明确的授权和结果检查。预算优化接受这项边界,省下 Token 与减少必要检查是不同目标。
这样的流程适用于独立开发者与小团队。它需要任务材料、验证规则和成本记录,额度的大小与流程的完整性是不同问题。
业务收益与预算之间存在反馈的可能性,但收益需要市场与执行验证。高带宽缺少保证收入增长的依据,增加消费缺少保证商业杠杆的依据。
评估与改进,需要防止“假进步”
一次任务失败触发了提示词修改,下一次任务通过。这是一次修复记录,通用改进的判断需要独立样本的证据。
可维护的闭环包含任务、结果、失败样本和版本对照。修改 Skill、替换工具、调整 Harness,需要记录变化与验证结果。
新的规则需要接受旧任务的检查。目标案例的成绩改善,旧任务的行为退化,代表一项取舍,缺少直接升级的依据。
一套评估材料需要保留独立的验收样本。Agent 调整工作规则,评分规则的改动需要独立审核流程。修改实现与修改答案,属于不同动作。
这类迭代指工作流程与配置的改进,区别于模型参数训练。一次提示词更新,缺少让模型“自我进化”的证据。
可复用的改进是人的带宽的一部分:一个失败形成一项检查规则,一个任务形成一份执行模板,一次交接形成一段可核对的记录。
一份带宽自查
人的带宽需要材料核验,自我评价缺少交付证据。
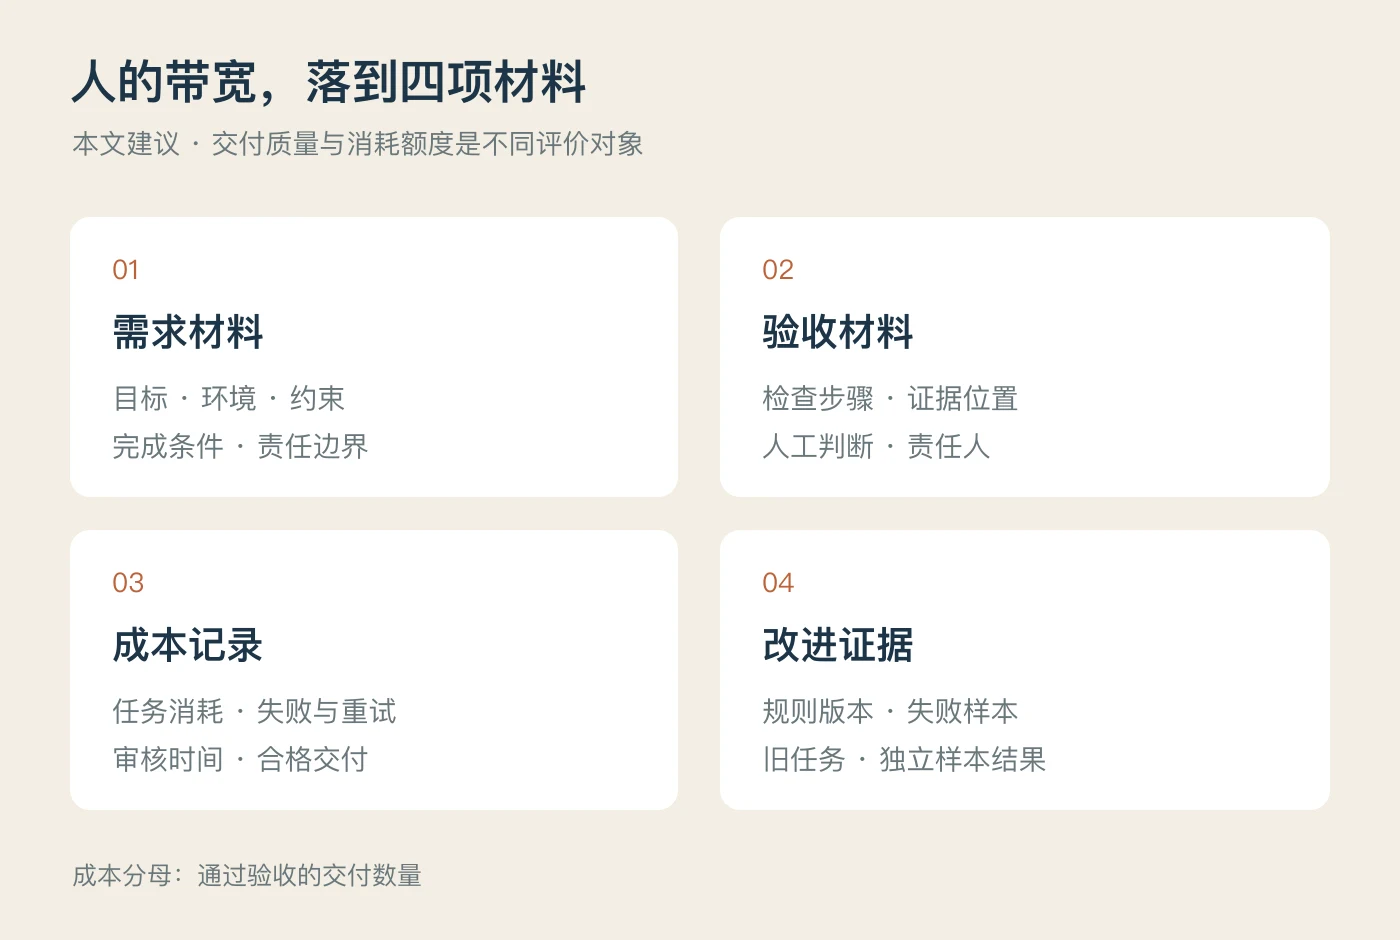
- 需求材料:任务目标、现有环境、约束、完成条件有记录。
- 验收材料:检查步骤、证据位置、人工判断的责任人有记录。
- 成本记录:总消耗、失败、重试和审核时间有记录。
- 改进证据:规则版本、失败样本、旧任务与独立样本的结果有记录。
这份清单属于本文建议,指标需要对应具体工作。
一个重复发生的任务,适合充当改进起点。选出过去的样本,定义完成标准,整理失败原因,形成一份可复用流程。对照记录回答改进的收益,任务质量决定这项投入的价值。
模型能力、工具和预算提供执行资源。需求转化与验收提供交付边界,反馈记录提供改进依据。人的带宽,体现在这些连接工作的质量。
AI 产能的验收对象,是通过检查的有效交付。
参考资料
- METR:Task-Completion Time Horizons
- Anthropic:Effective harnesses for long-running agents
- Anthropic:Demystifying evals for AI agents
本文的“带宽”属于工作组织隐喻;内容工作流与自查清单属于解释用示例和实践建议。
