Concitech AI · 深度长文
2026/11/11 08:09
AI 2027主创重估时间表!超人类AI研究员中位预测提前19个月,METR成关键证据
AI Futures更新了超人类AI研究员的到来预测。Daniel Kokotajlo的中位日期由2028年12月改为2027年5月,依据包含METR的Anthropic评估。本文介绍预测条件、研发加速证据,以及时间跨度图的含义。
2028年12月,改成2027年5月。
AI 2027主创Daniel Kokotajlo调整了“超人类AI研究员”的中位到来日期,两个日期相差19个月。
AI Futures的《Q3.5 Timelines Update》介绍了这次变化。他的SAR预测赋予“2027年5月及以前”50%的累计概率。
中位预测表达个人的概率判断。日期的变化,属于预测更新;能力的实现,需要现实证据。
这份更新的条件,是前沿研发的主动减速力度维持近况。重大监管变化、行业暂停或企业减速,改变预测的适用前提。原始预测更新
六人的2027年,指的是哪种AI?
文章使用两个核心概念。
SAR,即Superhuman AI Researcher,中文是超人类AI研究员。作者的建模定义包含两部分:AGI项目的编码工作自动化,以及研究判断达到顶尖人类研究者水平。
“研究判断”包含选择研究方向、设计实验与解释结果。代码生成、实验执行与研究方向选择,构成不同能力要求。
TED-AI,即Top-Expert-Dominating AI,描述超越顶尖人类专家的广泛任务能力。作者的能力范围设定包含几乎所有任务,以及广泛白领工作的自动化。
两者的范围存在区别。AI研发岗位的任务结构,与医院、法律服务、企业运营等工作的任务结构,具有不同约束。
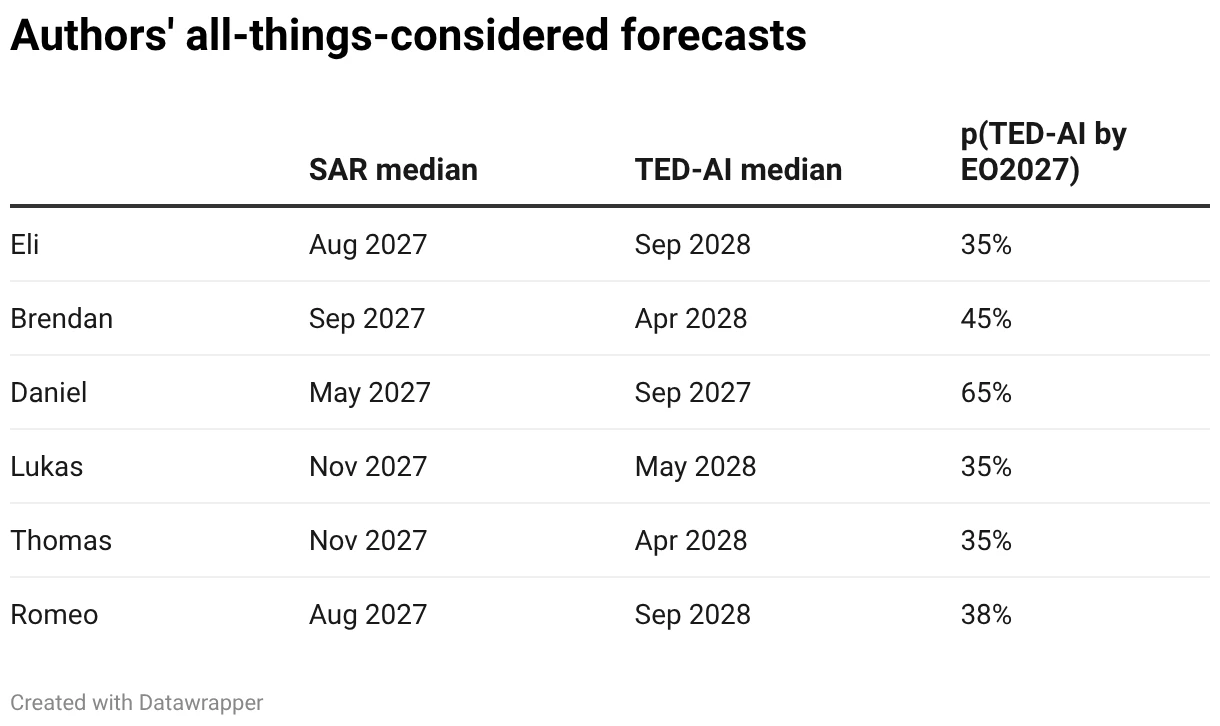
图1:AI Futures原文预测表。SAR与TED-AI是两个里程碑;最后一列是TED-AI到来日期的2027年末累计概率。预测条件包含前沿研发主动减速力度的假设。来源:AI Futures。
这张表给出六人的综合判断:SAR中位日期分布于2027年5月至11月;TED-AI中位日期分布于2027年9月至2028年9月。
六人的TED-AI预测赋予“2027年结束及以前”35%—65%的累计概率。这些数值是六名作者的个人概率判断,研究界共识和统计置信区间属于另外的概念。
METR提供了什么新证据?
METR的Anthropic研发加速评估,是作者列出的最大单项证据来源。
METR的评估周期为2026年8月12日至10月29日,公开报告发布日期为11月5日。评估涉及内部模型得分、训练与研发信息,以及研究人员访谈和调查。
核心公开结果是AECI趋势的变化。AECI是Anthropic采用的综合能力指数,设计来源是Epoch Capabilities Index。
METR估计,2025年10月之后的指数增长斜率,为此前的1.9倍,95%置信区间为1.5—2.8倍。这一量级的含义,是一年的进展对应约两年的历史进展。METR评估原文
这里的1.9倍,描述综合基准进步的速率变化。模型能力的绝对倍数、每位员工的生产率与公司的收入增速,属于不同度量。
报告包含Model 2、Model 3和Model 4等公开产品之外的模型结果。Model 4的训练结束时间为2026年9月至10月。公开报告使用匿名标签,产品名称需要正式发布材料确认。
METR的接触范围包含内部数据与人员交流,非公开模型的抽样调用权限缺席。这个范围支持内部结果分析,外部团队的模型复测属于另一项工作。
1.9倍、80%、1.7倍,回答不同问题
这次讨论的难点,是几组数字的混用。
| 数字 | 对应内容 | 证据类型 |
|---|---|---|
| 1.9倍 | AECI进步速率的变化 | 内部数据的趋势拟合 |
| 约80% | AI的当前加速贡献占比 | METR具有较大不确定性的主观判断 |
| 约1.7倍 | AI Futures采用的AI归因进步加速量级 | 归因假设转换后的建模输入 |
| 约12倍 | 内部调查中的员工自报提效 | 自报数据,解释限制较大 |
METR讨论了算力、招聘、数据改进与算法等潜在解释,认为AI承担了当前加速的大部分贡献。约80%的判断带有显著不确定性,报告的部分关键证据属于删减内容。
AI Futures作者采用这些估计,得到约1.7倍的AI归因进步加速量级,形成时间表模型的一项输入。
这条分析链包含三次转换:基准成绩形成能力趋势,研究者判断AI的因果贡献,预测模型推演未来日期。每次转换具有自己的假设和误差。
个人编程提效增加有效研究劳动;整体研发进度受到实验算力、训练周期、数据和研究判断的约束。12倍的员工自报数据,缺少换算公司整体进步倍数的充分条件。
“一周自主工作”的图,纵轴代表什么?
另一张传播图包含公开模型、内部模型估计与AI 2027情景轨迹。图中内部模型的标记接近“一工作周”,外推曲线指向2027年4月附近的Automated Coder门槛。
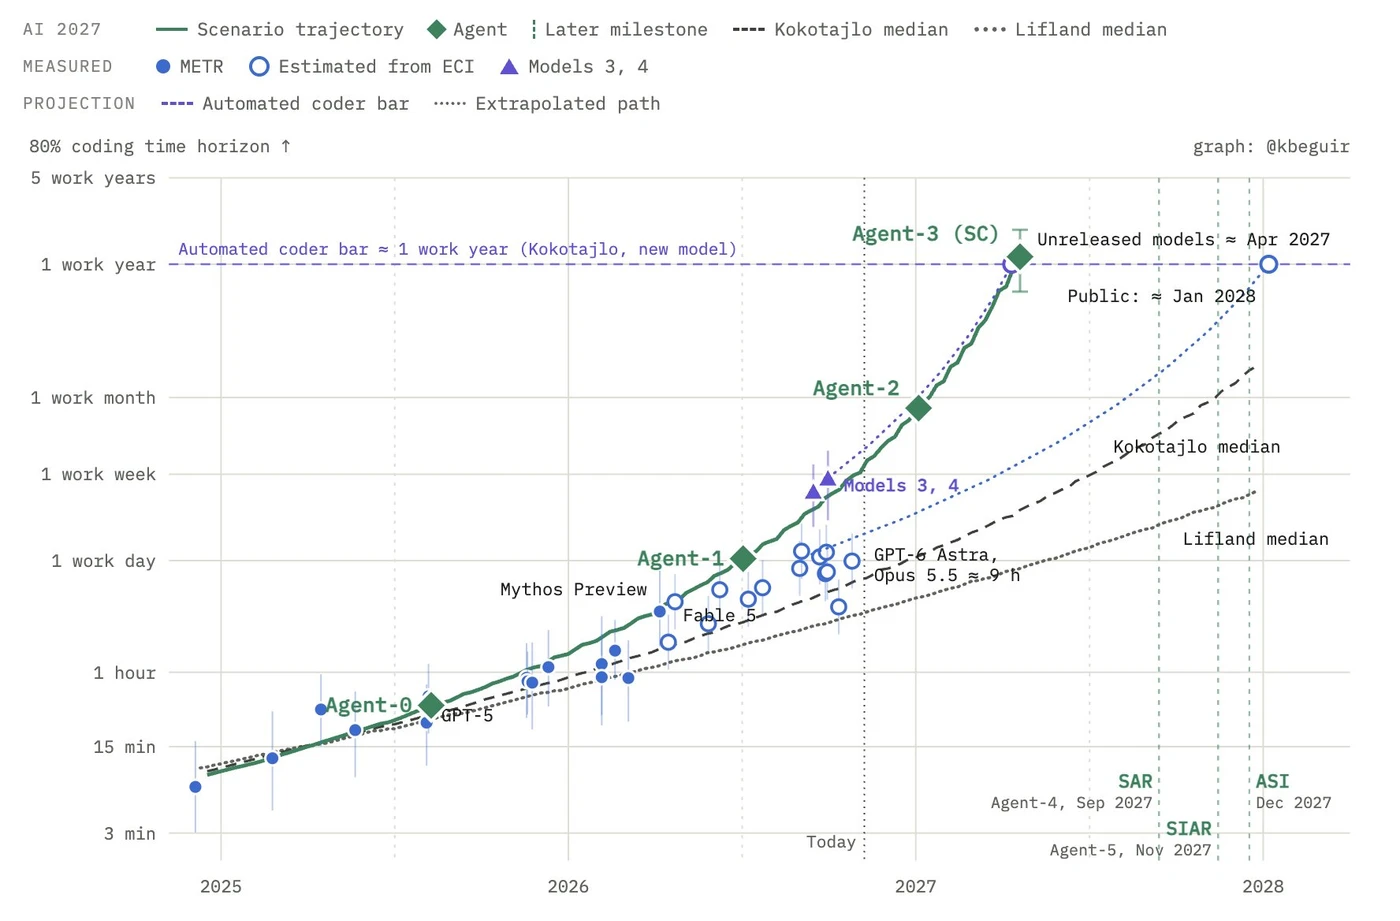
图2:Karim Beguir的汇总图,原图保留图例与署名。蓝色实心点标为METR测量,空心点标为ECI估计;紫色三角标记内部模型,未来曲线属于推演。来源:原始制图帖文。
读图的第一项工作是确认纵轴:它写的是80% coding time horizon,即80%可靠性口径的编码任务时间跨度。
METR方法说明的任务长度单位,是人类专家完成任务的耗时。这个时间衡量任务难度,AI实际运行时长属于另一项指标。80%是拟合的成功可靠性水平。METR方法说明
图中的“一周”,属于人类任务长度尺度;无人值守运行一周、完成任意一周企业工作,分别需要对应的运行记录和工作验证。
图例的区别具有实质意义。实测点、ECI换算点、内部模型的推算位置和未来外推线,承载不同来源的证据。
METR公开方法页的最近更新日期为2026年9月8日,页面注明当前任务集的16小时以上测量可靠性限制。数天、数周和一工作年的时间跨度,需要关注外推范围、换算方法与任务分布。图中的2027年4月,是制图者的路径推演。对照图原始帖文
时间表收缩,来自怎样的反馈链?
这次预测更新的核心逻辑,是AI参与下一代AI的研发。
反馈设想包含三个环节:模型协助实验、数据与工具开发,团队产出下一代模型,下一代模型承担后续研发任务。反馈的强度,取决于有效贡献占比、资源瓶颈和收益递减。
AI Futures使用简单趋势外推、人员提效外推、自动化水平外推与AI Futures Model等方法,比较不同假设的结果。
这些方法的日期存在差异。作者的综合日期,包含模型结果、其他证据与个人判断。不同模型提供比较视角,多个模型共用同一份METR报告,证据来源之间存在关联。
作者指出,完整训练周期具有时间成本,研究能力的衡量存在困难,代码与“研究判断”之外的技能影响研发工作。METR的删减内容、可核对信息和基准选择,影响读者对预测的信任。
我的判断是,这次更新的价值,是一个预测团队披露了调整依据和概率变化。它提供了跟踪AI研发反馈的线索,日期的精度需要后续证据检验。
下一轮观察需要关注:内部结果的独立复测、真实研发项目的贡献记录,以及加速对复杂开放任务的泛化。程序员与研究团队的采用决策,需要自己的任务数据、验收标准和成本记录。
