Concitech AI · 深度长文
2026/11/04 14:53
Anthropic开源大模型“验真器”!4000亿参数测试,瞄准中转站掺假
Anthropic发布FlashProve可验证推理原型,测试对象是4000亿参数的Llama 4 Maverick。可信模型指纹、严格匹配策略与真实请求的核验覆盖,构成发现中转站掺假的前提。文章介绍密码学证明的工作方式、性能成本与证据边界。
你购买A模型的服务,接口返回A模型的名字,回答出自什么模型?
这是模型中转服务面临的验收问题。产品标签、接口字段与客服承诺属于服务描述。一次具体计算的来源,需要计算证据。回答质量带有波动,“感觉变笨了”属于疑点,模型身份需要另外的证据。
Anthropic的11月2日研究介绍给出一个技术方向:FlashProve,可验证推理的开源原型。
它的目标是给模型回答附加一份密码学证明。用户核验这份证明,检查回答与指定模型的计算是否对应。Anthropic原文
这项研究与第三方中转站的关系是:可信模型指纹、严格匹配策略、真实请求与输出的核验覆盖,构成发现掺假的前提。违反这些约定的输出,触发验证失败。
偷换模型、篡改回答产生的不一致结果,有了暴露路径。FlashProve是一种研究原型,中转服务的接入需要开发、计算预算与身份信任安排。
一份证明,核对什么?
FlashProve涉及两个角色:提供计算与证明的服务商,核验结果的用户。
服务商公布一个commitment,中文称为“承诺”。它的作用类似模型权重的密码学指纹:固定一组权重,保留权重的秘密。
用户提供输入,获得输出与证明文件。验证器核对的命题是:这组承诺权重遵循指定计算规则,产生这些被检查的输出token。
这套分工称为Commit、Prove、Verify:承诺、证明、验证。官方仓库说明
证明采用zkSNARK,中文称为零知识简洁知识论证。零知识承担权重保密目标,简洁性承担降低核验负担的目标。用户侧的核验材料是承诺与证明,完整模型权重属于服务商的秘密资料。
当前设计公开模型架构,权重保密属于协议目标。协议的安全结论依赖密码学假设,产品实现涉及代码与运行环境的可信程度。
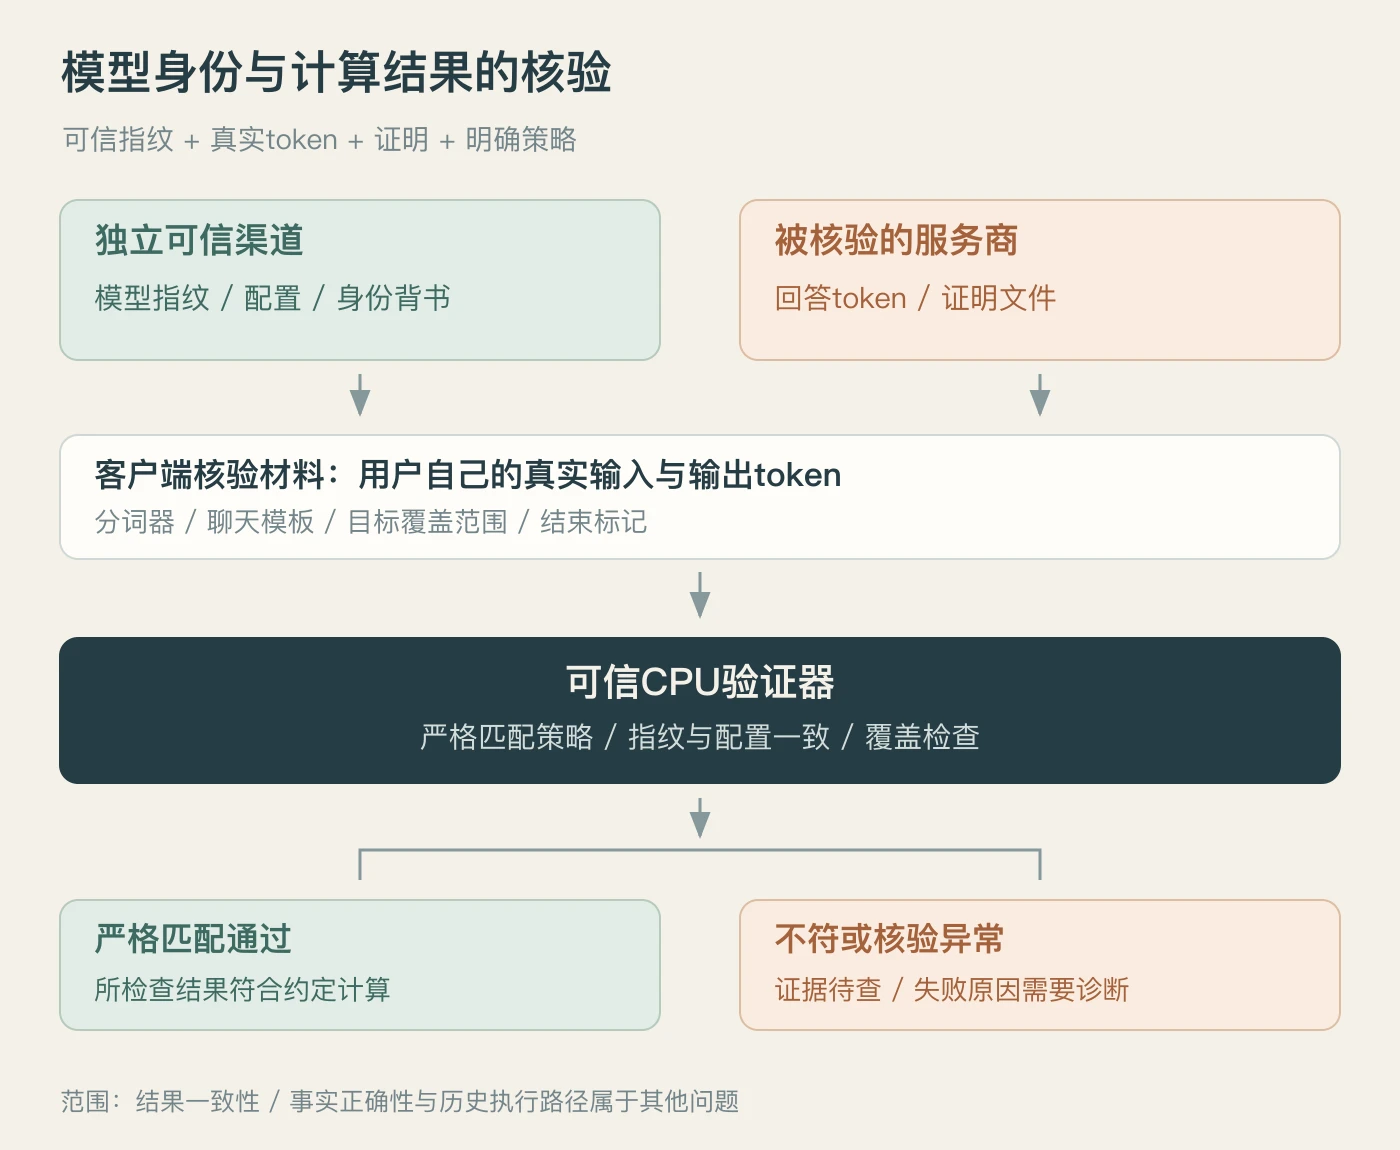
图1:本文原创流程图。可信指纹的来源、核验策略和覆盖范围,决定证明的含义。
中转站掺假,暴露需要四个条件
一个假设场景:某中转服务销售A模型,交付B模型的答案。A、B的输出出现差异,严格核验要求A模型的承诺权重与该答案一致,两者构成冲突。
有权重与计算轨迹支撑的有效证明,成为服务交付的一部分。伪造错误命题的有效证明,意味着攻破协议依赖的密码学安全假设。
第三方中转站的掺假结果,面临密码学核验的暴露风险。完整的核验链条,是这个判断的前提。
四项条件缺一不可:
- 可信的模型指纹。 模型身份背书来自可信主体,指纹与配置的取得渠道独立于被核验中转站。
- 用户自己的请求记录。 核验输入对应用户发送的token,核验输出对应用户收到的token;分词器、模板与结束标记需要对应。
- 明确的严格匹配策略。 用户接受的命题是指定整数模型的逐位置最高分选择,宽松策略代表另一种保证。
- 足够的覆盖与可信验证器。 被检查的位置覆盖目标内容,验证程序与配置可信,完整回复需要结束条件检查。
这些要求来自仓库的验证指南。核验指南
中转站选择低价模型、公布它的指纹、宣称“验证成功”,构成一条自证链。这条链支持它选择的模型,模型身份需要独立背书。
一份证明的覆盖对象是指定位置。单个token的证明覆盖该位置,整篇回复的验真需要覆盖整篇。
通过验证,等于什么?
仓库区分两种接受策略。
Exact match,严格匹配。 它要求被检查token是承诺整数模型对应位置的最高分选择,核验计算结果的一致性。
Clipped gap,宽松策略。 它检查输出token的分数代价是否符合指定阈值。WITHIN LIMITS表示符合这套限制,缺少等同于“原模型的准确输出”的依据。阈值设置影响约束强度,仓库提示宽松限制容纳篡改的风险。已知限制
两种策略的成功状态涉及退出码0,结论有区别。策略、覆盖范围与具体输出,构成解释依据。
证明针对整数化模型。浮点计算、采样解码与整数模型的严格选择之间存在差异。诚实服务的数值差异,有触发严格核验失败的风险;验证失败本身,缺少认定商业欺诈的充分性。
无证明、文件错误、核验中断和结果不一致,需要不同的处理。证明缺席是证据缺口,商业欺诈需要额外调查。
另一个边界是执行历史。结果一致性证明回答“这些输出符合指定计算吗”。GPU型号、缓存命中与其他程序的同值输出,属于执行路径问题。历史执行路径需要其他证据。
4000亿参数测试,成本是什么?
公开基准使用Llama 4 Maverick:总参数约4000亿,MoE架构,4-bit权重。证明端的硬件是一张H100和24个CPU核心。
| 项目 | 研究报告的设置或结果 |
|---|---|
| 基准请求 | 1024个上下文token,单份证明核验一个下一token |
| 证明端吞吐 | 24请求批次约223秒,约110 Tokens/s |
| 证明文件 | 单份约18.78 MB |
| CPU核验 | 24线程约17秒;单线程约21秒 |
| GPU计算成本 | 相对报告采用的vLLM基准,约70—95倍GPU时间 |
110 Tokens/s的统计包含证明端处理的上下文token。它是证明阶段的处理吞吐,模型生成速度是另一个指标。223秒是一个批次的时间,用户侧的验证耗时属于另一个指标。
性能指南区分稳态吞吐、启动与承诺生成的成本。完整线上交付耗时需要计入额外开销。性能指南
成本对照采用不同实现:证明端使用量化整数模型,对照使用八张H100的FP8版vLLM,比较指标是GPU时间。70—95倍缺少等同于所有商业API价格倍率的依据。
MoE的稀疏计算、批次共享工作、主机内存与GPU间的权重流转,支撑了这个原型的实现。成本与1024-token上下文限制,解释了研究原型距离通用聊天服务的工程距离。技术报告
Lean证明覆盖哪里?
Anthropic提供Lean形式化内容,以及C++验证器与Lean验证器。Lean是一种表达数学命题、检查形式化证明的工具。
Anthropic称,Claude参与了推理证明的优化。技术报告介绍,证明器的GPU代码、验证器的CPU代码涉及AI生成。AI的优化能力与代码生成能力,需要可检查的约束。
这里存在三层对象:安全命题,形式化协议,实现代码。
仓库说明,健全性定理针对Lean验证器;C++验证器与CUDA证明器缺少同等的形式化等价性证明。测试一致性提供实现证据,形式化等价性属于另外的证明任务。证明范围
“形式化验证”这个标签,需要注明验证对象。整套线上服务的安全性包含额外的软件与操作条件。
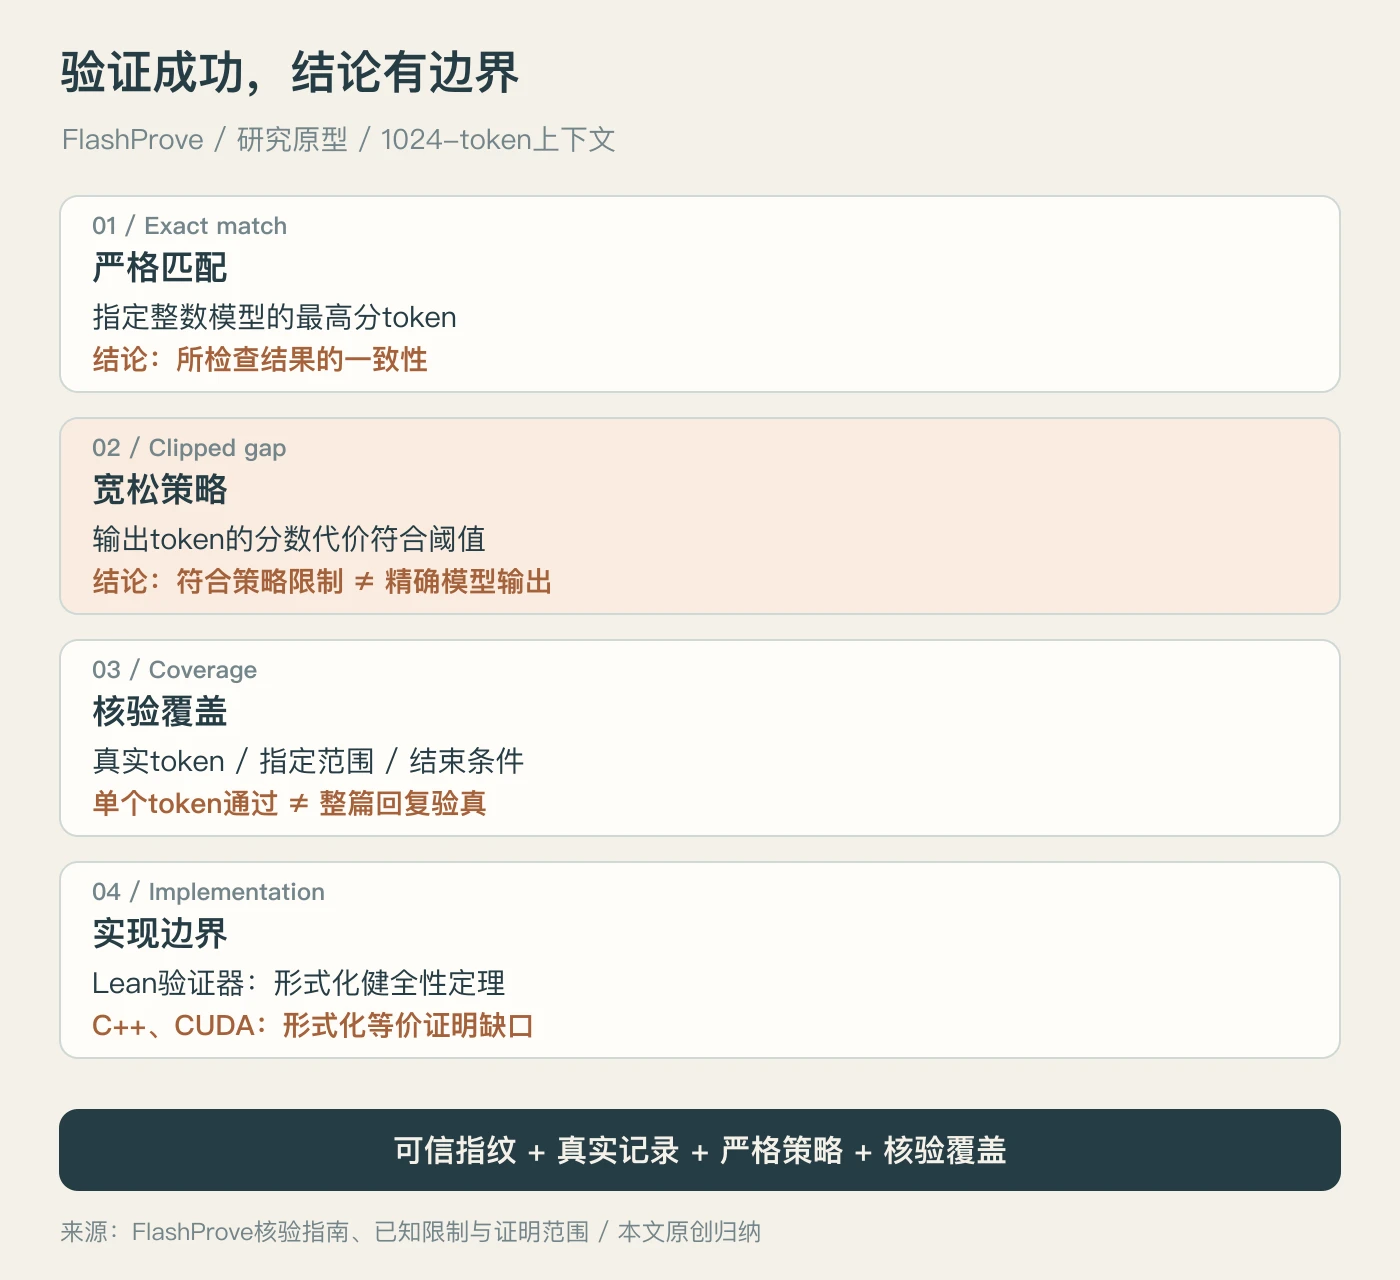
图2:本文原创证据边界图。验证策略、真实token与代码实现决定结论范围。
模型服务的交付物,增加一份计算凭证
FlashProve采用事后证明路线:回答交付,证明生成与核验跟进。这个机制提供篡改检测,缺少阻止错误回答抵达用户的事前拦截保证。真实输入输出日志的完整性,属于安全链条的一环。
这项研究面向模型来源与计算一致性。事实正确性、建议质量、商业授权与隐私合规,属于另外的验收项目。真模型产生幻觉,属于验真证明之外的问题。
公开仓库标注研究制品、Apache 2.0许可,以及停止维护的状态。测试对象是Llama 4 Maverick。研究原型的发布与Claude API的全量接入,属于不同状态。
第三方中转站的验收标准出现一个发展方向:模型名称对应可信身份,请求记录对应核验对象,回答对应计算凭证。
中转站掺假导致的计算不一致,具有验证失败的暴露路径。技术接入、严格策略与覆盖范围,决定这条路径的实际作用。
