Concitech AI · 深度长文
2026/10/14 07:22
日合并量超过 3 万:Anthropic 自研 Scion,重做源码管理
Anthropic 的日合并量超过三万,团队自研 Scion 承接源码管理。本文介绍在线客户端、服务端查询与缓存复用的设计,区分稀疏检出和部分克隆,解释基础设施收益的口径,讨论超大仓库的取舍与普通团队的优化起点。
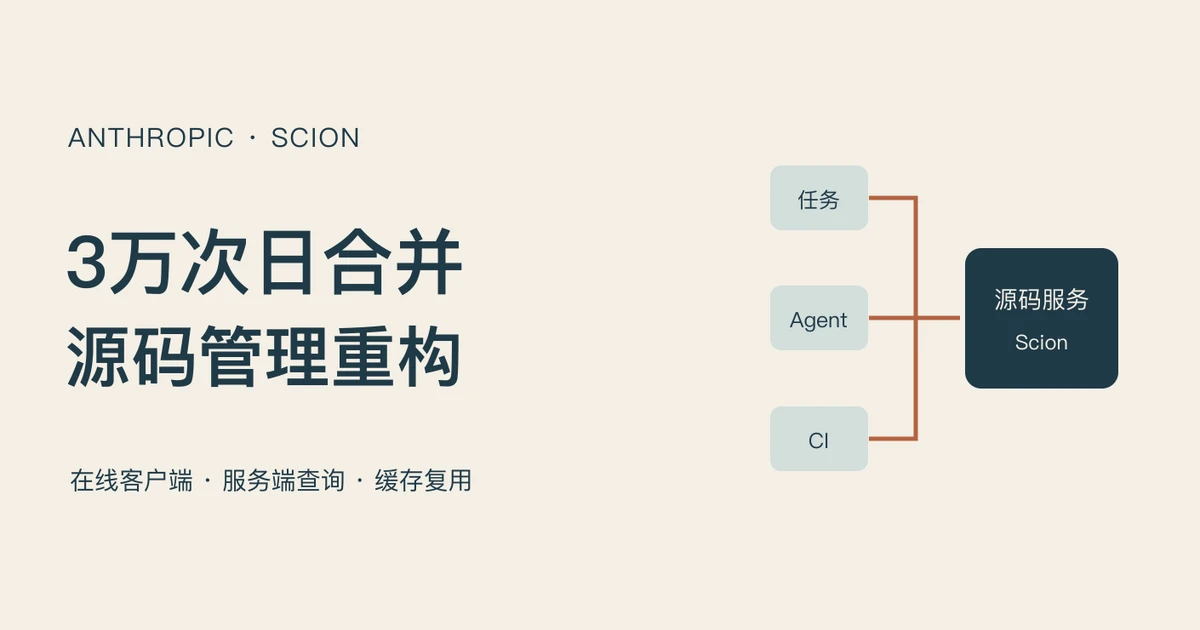
写代码的速度增加,代码进入仓库的基础设施承受压力。
Anthropic 的工程文章报告:2026 年 5 月的日合并量约为 2500,9 月超过 3 万。公司自研源码管理系统 Scion,五个月完成单一大仓库的迁移。原始工程文章
这项变化涉及一种工作负载:大量在线 Agent 与自动化任务,获取代码、查询历史、提交修改。
源码管理的成本,有了不同的组成。人的本地工作需要自主性,自动化任务需要吞吐量。一个设计的优势与代价,取决于使用者的行为。
Scion 的意义是一次针对性重构。它提供了理解 Agent 基础设施的案例,缺少对“Git 过时”的普遍证明。
一个短任务,需要多少仓库
一个任务需要比较两个版本,另一个任务需要运行一个模块的测试。两项任务的目标,决定所需数据的范围。
完整的历史、全部文件、当前依赖,与一次任务实际读取的内容,是不同集合。仓库规模增加、临时环境增加,未使用的数据构成传输与存储负担。
Git 的设计支持本地仓库与历史操作。它提供浅克隆、部分克隆和稀疏检出等工具。Git 的优化能力存在,具体设置需要对应任务。Git 克隆文档
这几种方式有不同职责。
浅克隆减少历史深度。部分克隆控制对象获取,例如 --filter=blob:none 延后文件内容的下载。稀疏检出控制工作目录中的文件范围。
“目录里文件少”和“网络传输少”,属于两个问题。稀疏检出的配置,缺少对传输量的充分说明。稀疏检出文档
一项需要历史关系的任务,浅克隆的历史范围影响结果。一个仓库的检出策略,需要任务验证,配置名称缺少代替验收的资格。
Scion 改变了责任分配
在线服务是 Scion 客户端的工作前提。服务端承担提交、合并和历史查询,客户端保留有限缓存与所需文件;部分查询的 API 返回结果,工作副本属于可选材料。它的文件读取路径包含节点缓存、区域缓存和权威服务。设计原文
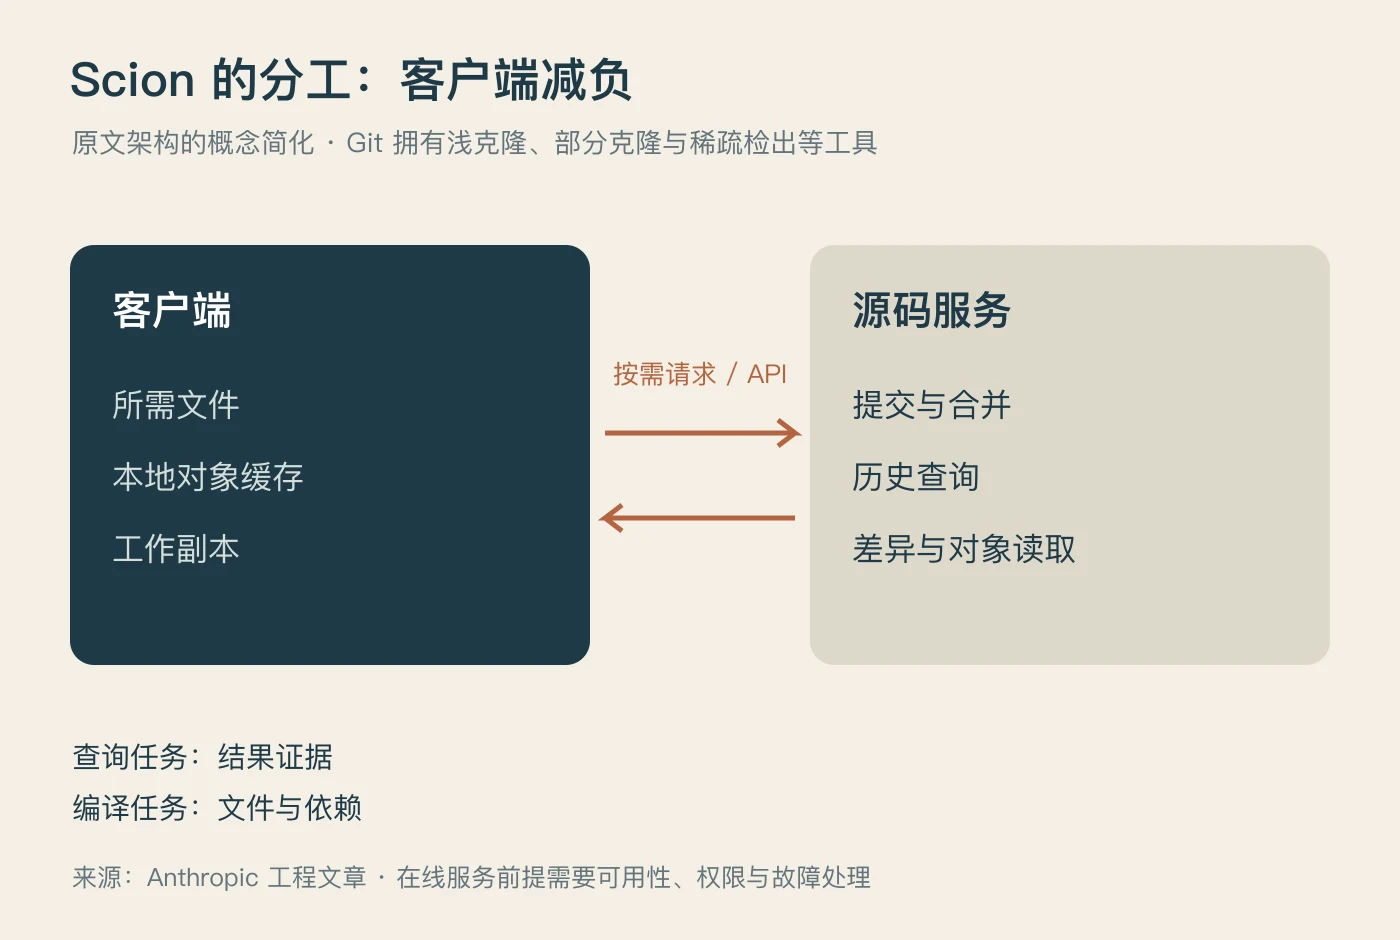
这种分工的取舍,需要区分计算的位置和任务的需求。
一个自动化任务需要一份差异,服务器提供结果,任务获得信息。任务缺少完整仓库的必要性,前提是查询结果、权限和版本语义满足要求。
一个任务需要编译,文件与依赖成为执行材料。查询 API 缺少替代编译环境的能力,工作副本的规模需要依赖关系决定。
客户端减负的代价,是对服务可用性和访问权限的依赖。离线能力、网络延迟、服务限流和恢复路径,需要新的责任安排。
这里的设计问题是“谁承担哪项工作”。一种服务能替代客户端的一段计算,团队需要评估共享收益与新增依赖。
缓存复用,处理的是重复劳动
多个任务读取相同版本的文件。任务的独立下载与保存,构成重复工作。共享缓存提供了复用的机会。
内容的身份、版本的身份和权限,决定复用的正确性。缓存命中提供速度收益,错误的缓存键制造结果污染。
同一个文件路径包含不同版本。路径相同,内容不同,复用需要精确的对象身份。两个任务拥有不同权限,共享存储需要保持权限边界。
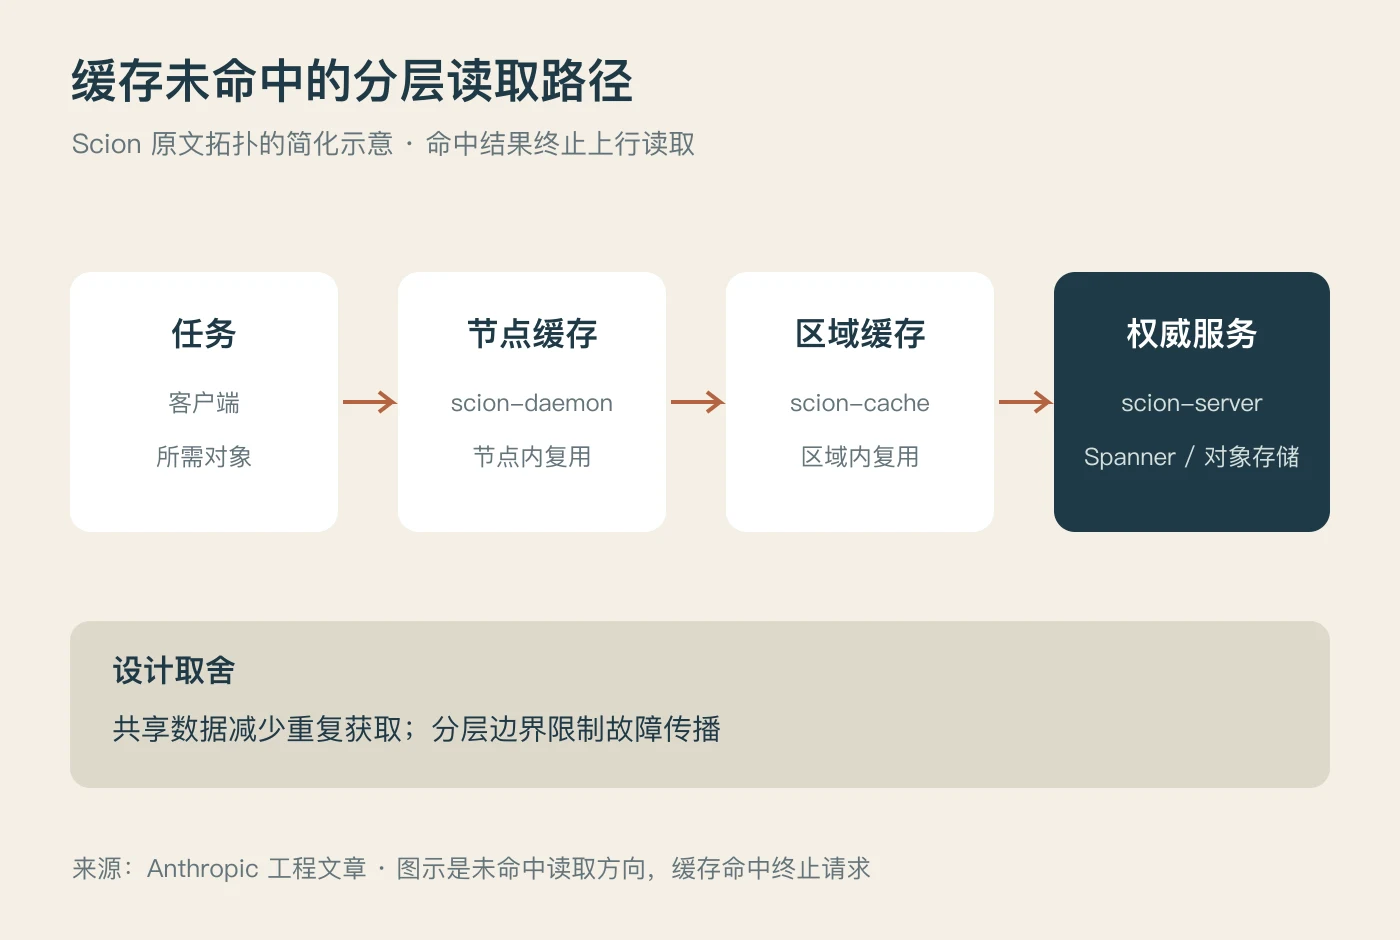
这张图表示缓存未命中的读取方向。命中结果终止上行读取;它区别于每次请求经过所有层。
缓存层的收益与失败模式需要评估。区域缓存故障,回源请求增加。限流、负载隔离和恢复顺序,影响上游服务的稳定性。
一种优化减少正常请求的成本,故障场景的成本需要独立的测量。共享机制的集中程度,影响故障的传播范围。
Git 的拉取涉及对象获取与客户端、服务端之间的协商。缓存、镜像和网络策略需要对应实际瓶颈,下载时长的总数缺少具体原因的说明。Git 拉取文档
“200 倍”,对应哪一份成本
Anthropic 报告,Scion 的源码基础设施 CPU 与内存需求约为旧 Git 镜像架构的二百分之一,CI 获得了 25% 的 CPU 容量收益。公司报告
两个指标的对象不同。一个比较源码基础设施,一个描述 CI 的容量收益。它们缺少对全部开发工作提速的含义。
“基础设施消耗减少”和“工程师交付增加”,需要不同的证据。仓库获取变快,编译、测试、审核和部署有自己的成本。
读者需要保留比较基线。公司内部的仓库、任务分布与旧镜像方案,构成这份结果的环境。普通仓库的收益需要测量,跨环境套用倍数的依据不足。
这类结果适合用于提出检查问题:工作时间消耗在哪里,哪些步骤存在重复,哪项共享机制减少了成本?数字的价值是测量口径,宣传性的全局倍数缺少帮助。
测试结果,需要绑定版本
大量变更进入主线,验证工作需要明确版本。
一个任务检查了版本 A,主线推进到版本 B。A 的测试通过,证明的是 A 满足检查条件。B 包含新的组合,结论需要对应组合的验证。
这是一种普遍的并发问题。源码服务的吞吐量增加,测试结果与提交版本的绑定关系需要保留。
一次测试记录需要输入版本、依赖状态、检查项目和产物身份。一次发布需要确认测试覆盖的对象,与部署对象的关系。
回滚需要相同的追溯能力。某个版本引入行为变化,团队需要定位改动、评估关联影响并恢复可用状态。提交的数量缺少对这项能力的证明。
这部分属于本文的工程分析。Scion 的缓存收益与安全发布之间,需要验证、审计和恢复机制连接。
普通团队的起点,是测量
Anthropic 明确说明,Scion 面向极大仓库与高密度 Agent 工作负载,缺少通用 Git 替代品的适用性。适用范围
这项边界需要保留。迁移源码管理涉及接口、权限、历史、工具与工作习惯,迁移成本需要对应收益。
普通团队适合检查四项材料。
- 获取成本:克隆、拉取、检出和本地维护的耗时与数据量。
- 数据需求:任务读取的目录、文件、历史和依赖范围。
- 复用条件:缓存对象身份、权限边界、生命周期和故障隔离。
- 验证链路:测试版本、产物版本、部署对象和回滚入口。
这份清单属于本文建议。它需要真实任务的观测结果,工具品牌缺少代替测量的资格。
一个团队的痛点是检出全仓库,另一个团队的痛点是测试范围过大。前者需要检查获取策略,后者需要检查依赖与测试选择。两者使用同一套替换方案,缺少问题对应关系。
Scion 给出的启发,是源码管理的设计需要接受工作负载的检验。AI 增加代码产出,基础设施承担获取、验证与交付。每个阶段的责任和成本,需要清晰的记录。
源码管理的优化目标,是可追溯、可验证的有效交付。
参考资料
Scion 的规模与收益属于公司报告,本文的证据范围是原始材料,独立性能复现需要额外验证。工作场景与检查清单属于解释用示例和实践建议。
