Concitech AI · 深度长文
2026/08/26 05:27
512GB Mac Studio 来了:Apple 与 NVIDIA,争的到底是什么?
Apple 用 M6 Mac mini 和最高 512GB 统一内存的 M5 Ultra Mac Studio 把本地 AI 推向更大模型。但这不等于 NVIDIA 只剩数据中心:真正竞争的是内存容量、软件迁移与规模经济。
8 月 25 日,Apple 同时发布 M6、M5 Ultra,以及新一代 Mac mini 和 Mac Studio。最吸睛的数字不是 CPU 核心数,而是 512GB 统一内存:一台桌面电脑,第一次把如此大的共享内存池带到 Mac 上。
随后,一则在 X 上流传的判断把两家公司分成两层:Apple 赢得安静、私密、常驻的个人 AI,NVIDIA 继续掌控训练集群和工业级推理。这个判断抓住了本地 AI 抬头的大方向,但边界画得太整齐。
更准确的说法是:Apple 正在扩大“值得留在本地”的工作范围;NVIDIA 则试图让同一套开发栈从桌面一直延伸到数据中心。 双方争的不是同一块芯片插槽,而是每一项 AI 工作最终放在哪里运行。
两台新 Mac,解决的不是同一件事
先把产品分清。
M6 Mac mini 最高只有 32GB 统一内存和 170GB/s 内存带宽。Apple 给出的卖点,是每个 GPU 核心内置神经网络加速器,加上双 16 核神经网络引擎。它适合常驻代理、个人知识库、代码辅助和中小模型,但不是用来装下超大模型的机器。
真正改变本地模型容量上限的是 M5 Ultra Mac Studio:最高 36 核 CPU、80 核 GPU、512GB 统一内存,内存带宽达到 1.2TB/s。Apple 称它能在本地运行数千亿参数级模型,还可以通过 Thunderbolt 5 和 RDMA 把四台 Mac Studio 组成推理集群。
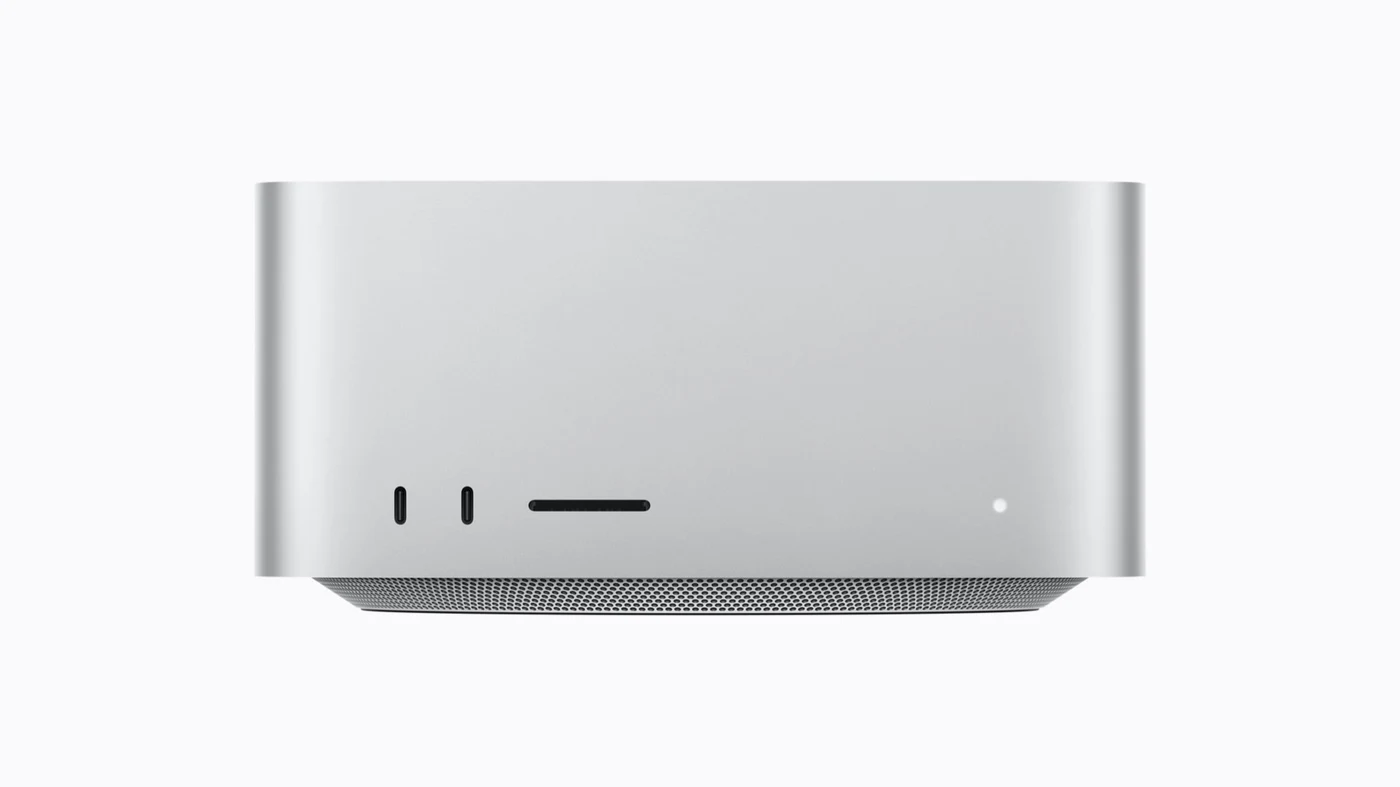
新款 Mac Studio。图片来源:Apple Newsroom。
这里有两处需要降温。
第一,截至 8 月 26 日,新机尚未发货,媒体无法独立复测。Apple 公布的数倍性能提升来自厂商测试,不能直接当成第三方结论。第二,512GB 版本要到 10 月下旬才上市,顶配价格也不能从 46,999 元的起售价简单外推。
所以,眼下最可信的变化不是“速度翻了几倍”,而是 能装下什么模型。
512GB 的价值,首先是越过显存墙
大模型推理有一个朴素限制:模型权重、KV Cache 和运行时开销必须进入可用内存。传统独立显卡的显存一旦不够,就要跨 PCIe 搬运数据,速度和体验都会明显下降;多卡虽然能扩容,也会带来通信、功耗和软件配置成本。
Apple Silicon 的 CPU、GPU 共用统一内存。它的优势不是凭空增加算力,而是让 GPU 能访问更大的内存池。512GB 的 M5 Ultra 因而获得一种很具体的能力:不少过去必须多卡或上云的大模型,现在有机会完整留在一台桌面机器里。
2025 年和 2026 年的两篇预印本也观察到类似取舍:NVIDIA GPU 往往有更高的计算密度,Apple Silicon 则能凭大容量统一内存运行显存装不下的模型,并在部分测试中表现出较好的能效。不过,这些研究使用的是更早硬件和有限模型,不能代替 M5 Ultra 实测。
容量同样不等于吞吐。模型即使能装下,生成速度仍取决于内存带宽、计算单元、量化方法、推理框架和上下文长度。把 1.2TB/s、1.792TB/s 或不同厂商的 TOPS 摆在一起,并不能推导谁一定更快。
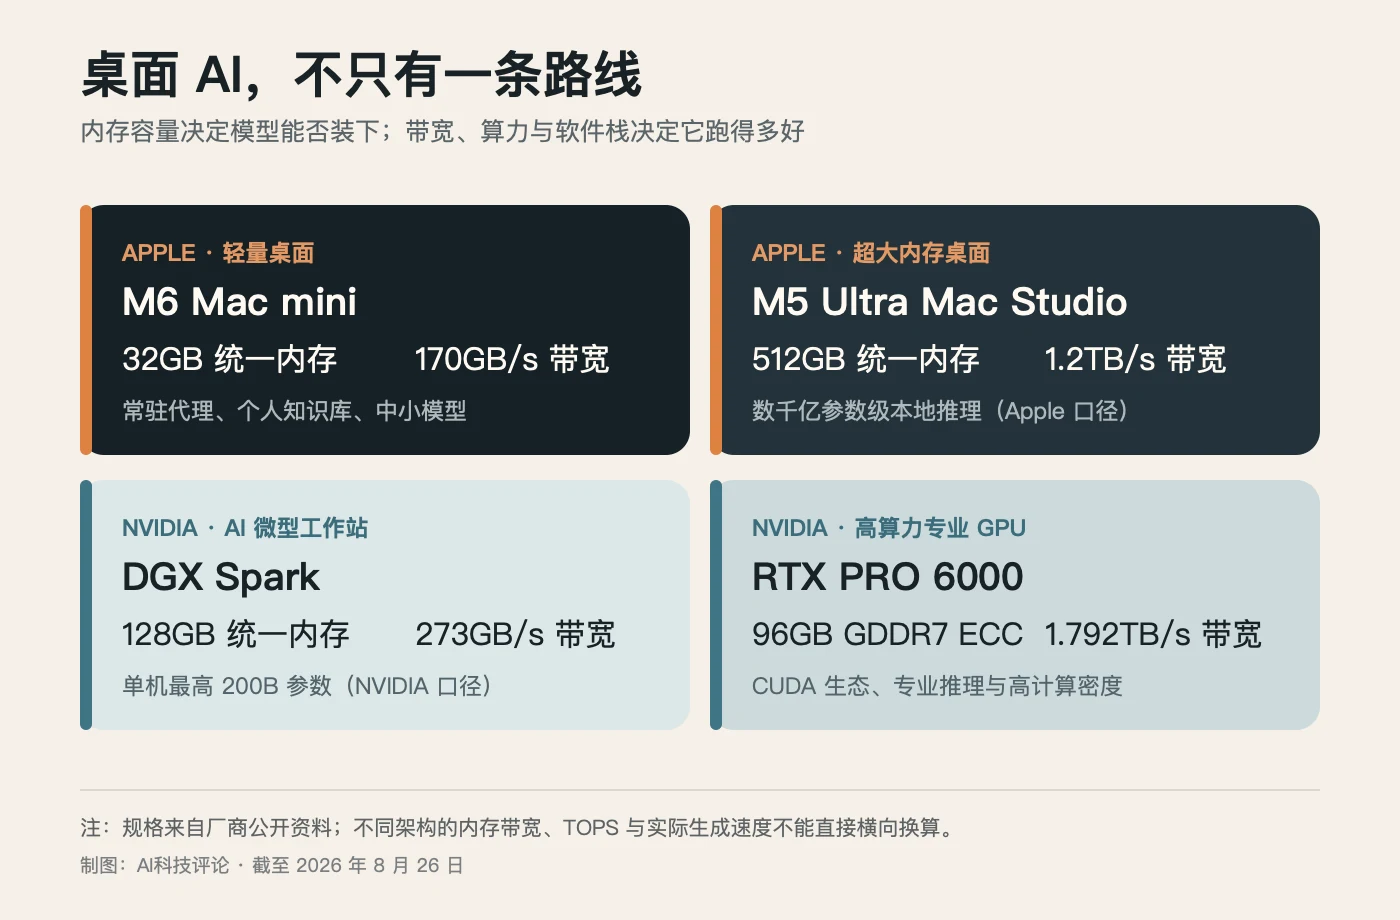
规格只回答“机器有什么”,不直接回答某个模型在真实任务里跑多快。
NVIDIA 并没有把本地 AI 让给 Apple
原帖最值得修正的一点,是把 NVIDIA 只放在“工业 AI”一侧。
NVIDIA 自己把 Local AI 作为完整产品线来经营。DGX Spark 配备 128GB 统一内存,官方称单机可运行最高 200B 参数模型;RTX PRO 6000 有 96GB GDDR7 ECC 显存和 1.792TB/s 带宽;再往上还有面向工作站的 DGX Station。
这些机器与 Mac Studio 的侧重点不同。Mac 的长板是大容量统一内存、低噪声、能效和软硬件一体化;NVIDIA 的长板是 CUDA 生态、成熟的推理库、计算密度,以及从桌面迁移到云端或多节点系统的连续性。
CUDA-X 里有 cuDNN、TensorRT-LLM、NCCL 等大量库。一个团队在 RTX 或 DGX Spark 上验证的模型,更容易沿同一工具链迁到 DGX SuperPOD 或云端 GPU。对需要持续训练、高并发服务和多节点通信的公司,这种迁移成本往往比单台机器的内存数字更重要。
反过来,Apple 的 Core ML、Metal 和 MLX 正在形成自己的闭环。对于只在 Mac 上运行的个人工具、研究原型和私有代理,它未必需要复制 CUDA 的全部能力,只要把本地体验做到足够顺滑,就能接住一批原本会购买中端显卡或调用云 API 的需求。
本地、混合还是云端,看四个问题
与其问“Apple 会不会打败 NVIDIA”,不如逐项判断工作负载:
数据能不能离开设备? 医疗、法务、财务和未公开代码更适合本地处理,至少要先在本地脱敏。
模型能不能装进单机? 能装下只是起点,还要检查目标上下文和并发下的实际速度。超出单机容量后,多节点 NVIDIA 系统通常有更成熟的路径。
负载是否稳定? 每天长期运行、利用率高的任务,购买本地设备可能更划算;偶发高峰更适合云端按需扩容。
需要多少并发和训练能力? 一个人与代理交互,重点是延迟、安静和隐私;为数万用户提供服务,重点会变成吞吐、调度、容错和集群效率。
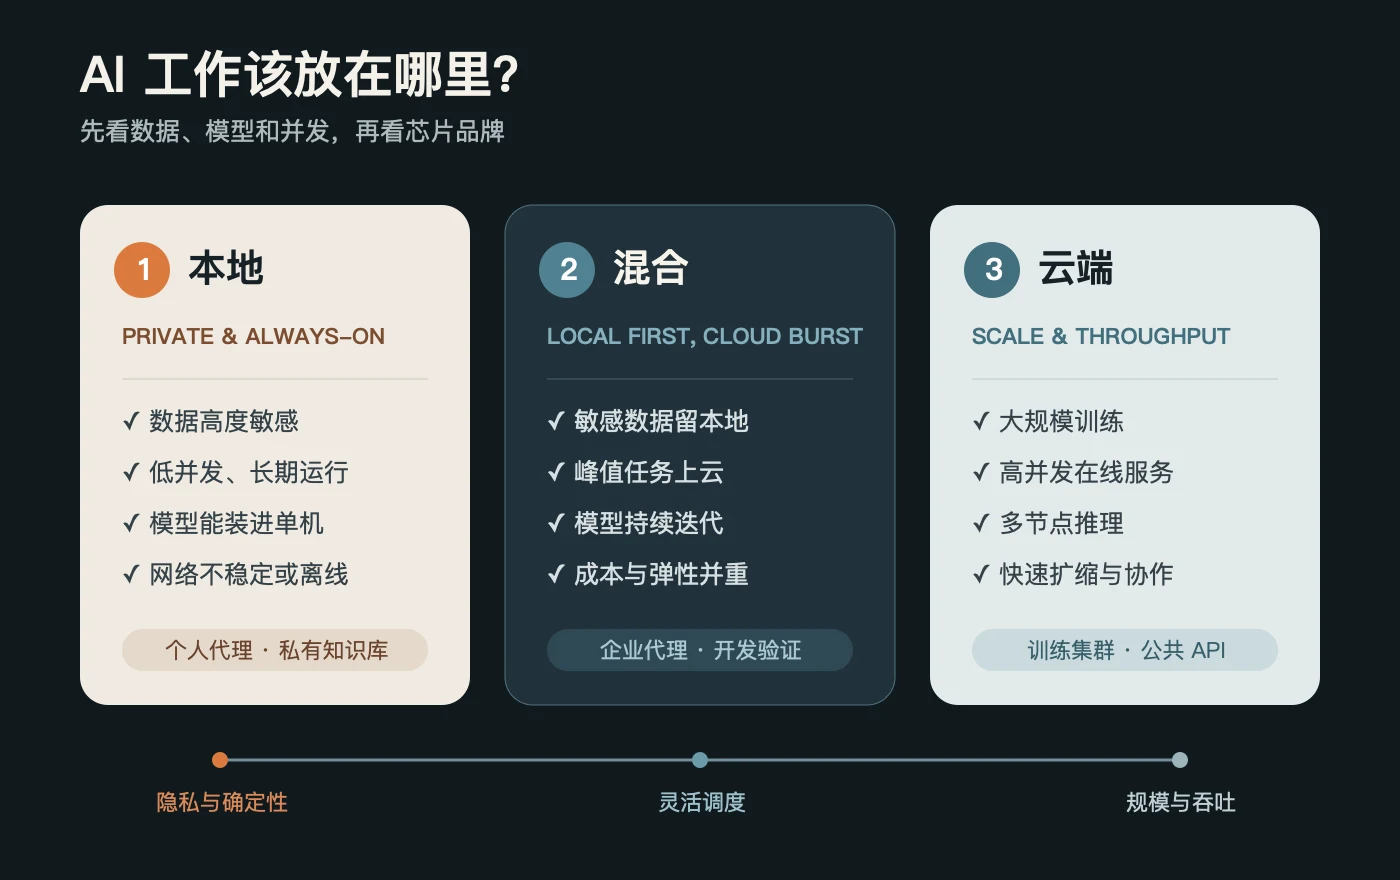
多数企业最终不会三选一,而是让敏感数据留在本地,把峰值推理和训练放到云端。
Apple 改变的是桌面 AI 的经济账
M5 Ultra Mac Studio 不会动摇 NVIDIA 在大规模训练和数据中心推理中的地位。Apple 没有对应 CUDA、NVLink、NCCL 和成熟集群运维体系的完整替代品,单台 512GB Mac 也不是数千张 GPU 集群的缩小版。
它带来的压力更细微:当一台桌面机器可以容纳更大的模型,企业会重新计算哪些推理请求还有必要离开办公室,开发者也会重新考虑是否要为每次实验付云端账单。
这不是 Apple 抢走整个 AI 基础设施市场,而是本地层变厚了。
与此同时,NVIDIA 的应对并非退守云端。DGX Spark、RTX PRO 和 DGX Station 都在争夺这张桌面;CUDA 又把本地开发和云端部署连成一条路。NVIDIA 想守住的,不只是 GPU 销量,而是工作负载无论最终落在哪里,都尽量沿着它的软件栈运行。
因此,原帖最后那个问题确实比“谁打败谁”更有价值:日常 AI 工作会有多少留在本地,又有多少继续向云端扩张?
答案不会是一个固定比例。模型变大,会把任务推向集群;压缩、量化和更大的统一内存,又会把任务拉回桌面。接下来真正值得观察的,也不是发布会上的峰值数字,而是新 Mac 发货后的真实生成速度、功耗、并发能力,以及开发者是否愿意把现有工作迁进 MLX 和 Metal。
芯片之争只是表面。更深的一层,是 AI 计算正在从“默认上云”,走向按数据、模型与成本重新分配。
参考资料
- Rise-Raise:Apple 与 NVIDIA 的本地/工业 AI 分层讨论
- Apple:M6 与 M5 Ultra 发布信息
- Apple:M6 与 M5 Pro Mac mini
- Apple:M5 Max 与 M5 Ultra Mac Studio
- NVIDIA:Local AI 产品与软件栈
- NVIDIA:DGX Spark 硬件规格
- NVIDIA:CUDA-X Libraries
- NVIDIA:DGX SuperPOD
- Silicon Showdown: Benchmarking LLM Inference Across NVIDIA RTX and Apple Silicon(预印本)
- Profiling LLM Inference on Apple Silicon(预印本)
