Concitech AI · 深度长文
2026/11/14 08:20
浏览器Agent的苦涩教训!一个for循环,挑战一年半的工具设计
Tabbit团队的工程复盘记录了浏览器Agent向代码执行的转向。模型获得循环、分支、持续状态与观察选择权,Playwright、CDP和视觉接口形成不同分工。本文介绍技术机制、公开评测的统计口径、测试边界与WebMCP方向。
200多条后台配置,成为一次浏览器Agent架构反思的转折点。
2026年11月10日的《浏览器操控的苦涩教训》,记录了Tabbit团队一年半的探索。其中一个场景,是Codex承担的重复配置任务:模型打通一条流程,代码中的循环承担其余重复步骤。[1]
这是作者的单次工作记录。它提出的工程问题具有普遍意义:任务重复部分的执行主体,是模型的一轮轮决策,还是程序?
这篇复盘的看点,是浏览器操作的组织方式发生了变化。模型编写代码,代码承担循环、条件与状态管理,浏览器接口提供操作能力。
固定动作菜单,规定了模型的表达方式
早期浏览器Agent的典型循环是:框架提取页面状态,模型选择动作,工具执行,框架返回新状态。
点击、输入、滚动、切换标签页,构成一张动作菜单。元素编号、DOM摘要和截图,构成模型的观察材料。
这套设计具有明确的接口,复杂网页暴露了接口的边界:画布中的内容缺少常规DOM语义,iframe和Shadow DOM增加了结构层次,状态裁剪存在信息遗漏。
Browser Use团队的2026年9月复盘举了一个例子:Cookie按钮出现在画面中,框架生成的状态列表缺少它。提取层限制了模型的观察。[3]
框架决定观察内容,模型继承了框架的信息边界。
代码执行提供了另一种任务表达方式。循环负责重复操作,分支处理条件,异常处理记录失败,变量保留中间结果。这条路线的动作空间包含可组合的程序,循环与分支获得了表达位置。
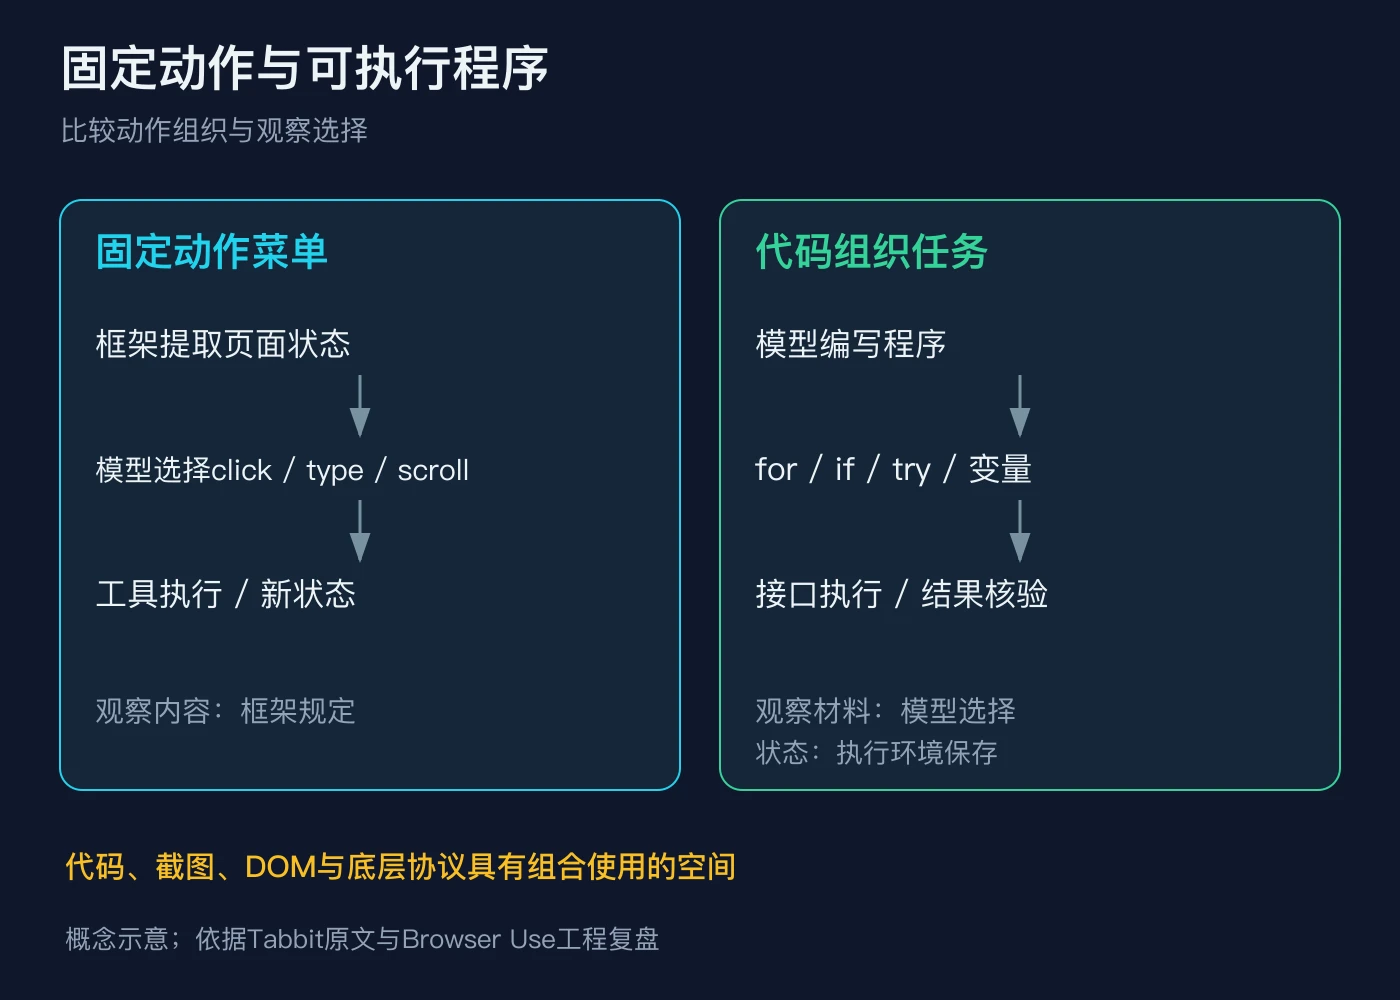
图:动作组织与观察选择的概念梳理;依据原文与Browser Use工程复盘制作。[1][3]
转折包含两件事:写动作,写观察
代码组织行动具有研究基础。2024年的CodeAct论文提出统一的Agent行动表达:可执行Python代码。解释器负责执行,多轮交互承担结果反馈与动作修订。[5]
Browser Use披露的演进包含两个阶段:模型编写操作程序;模型选择观察方式。后一个阶段允许模型决定读取DOM、获取截图,或检查某个frame。[3]
“选择观察”影响任务处理。结构化提取适合价格列表,视觉信息适合画布,控制台与执行结果帮助定位报错。任务不同,适合的观察材料不同。
持续执行环境保存变量、辅助函数与进度。模型拥有了复用中间成果的条件,截图、DOM和错误信息承担反馈职责。
代码路线的工程内涵包括可组合行动、持续状态、观察选择与结果验证。页面变化、异步加载和错误恢复,要求反馈与重试机制。
Playwright与CDP,承担不同层次的工作
Tabbit选择Playwright作为常规入口,Browser Use的复盘强调原始CDP访问。两者的共同点,是模型编写程序,程序控制浏览器;接口层的取舍具有不同侧重。[1][3]
Playwright提供定位器、自动等待与重试机制。角色、标签、文本和测试ID,是常见的定位依据。模型获得了一套成熟的浏览器编程接口。[4]
CDP是Chrome DevTools Protocol,提供浏览器调试与控制通道。Playwright的CDPSession支持发送原始协议命令、订阅协议事件;Playwright与CDP具备组合使用的接口基础。[4]
Shadow DOM是一个具体边界。Playwright文档说明,常规定位器支持开放的Shadow DOM,关闭模式的Shadow root属于支持例外。Browser Use列出的底层协议用途,包含此类结构的处理。[3][4]
视觉操作的职责来自页面表达。画布、图像化控件和缺少结构化语义的界面,需要截图与坐标等信息。代码负责组织行动,视觉负责提供一种观察渠道。
**代码执行、浏览器接口和观察渠道,是三个设计层次。**它们的组合决定任务处理方式。
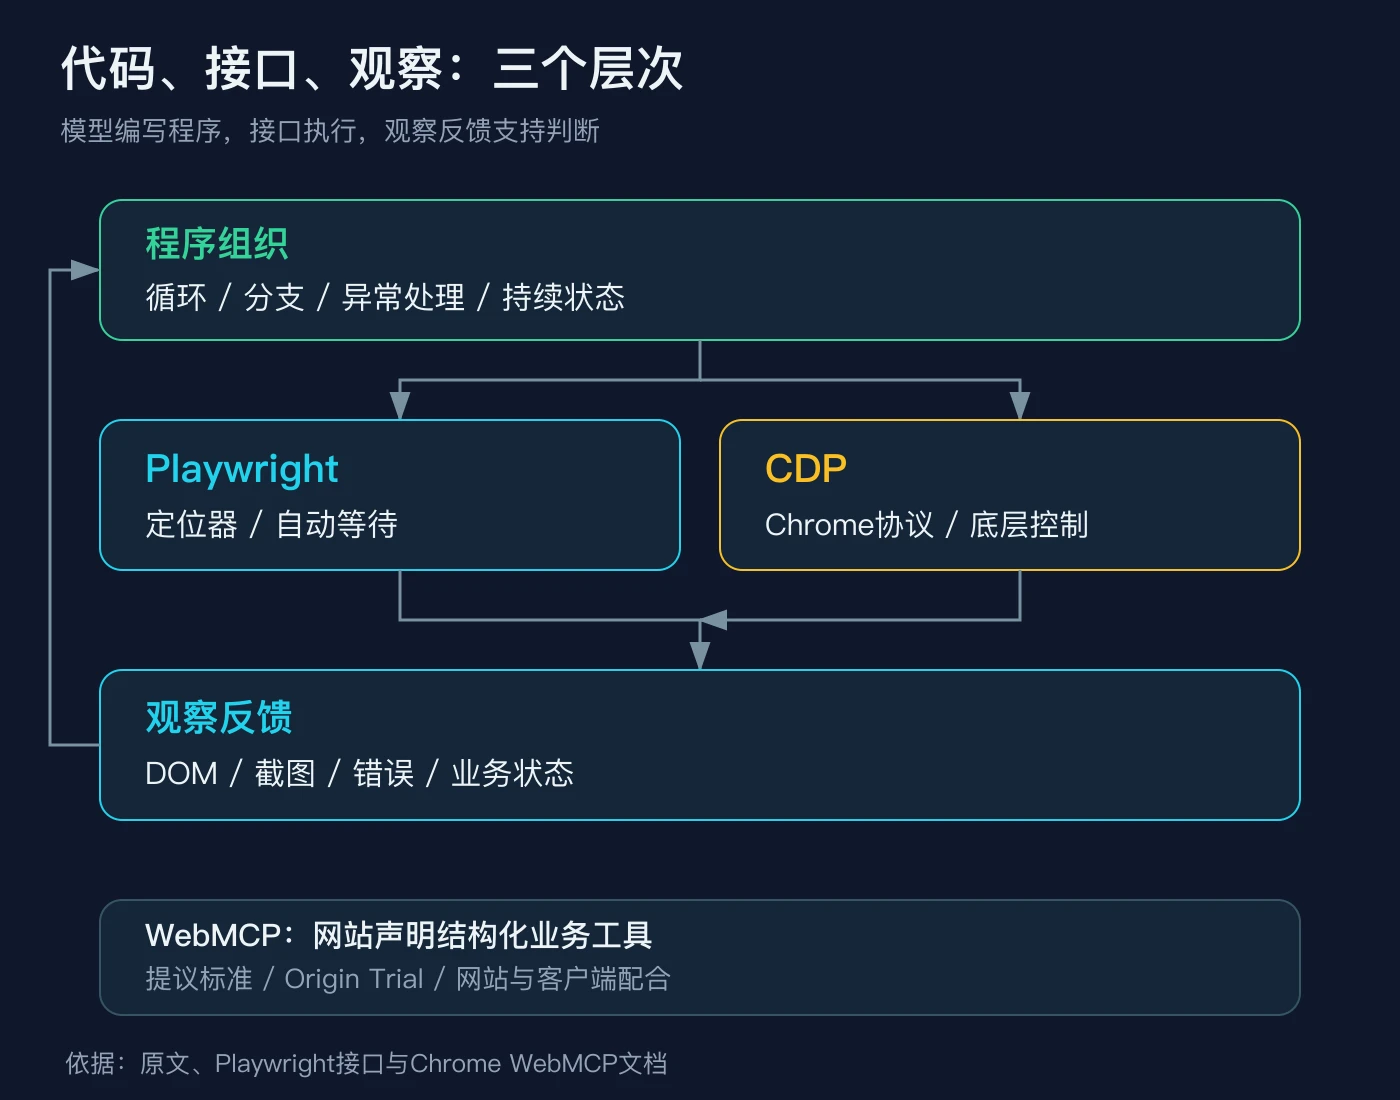
图:程序组织、接口执行与观察反馈的分层示意;依据原文和官方文档制作。[1][3][4]
公开评测显示成本差异,正确率差距有限
Tabbit公开报告使用BU Bench中的25个任务,每种方案包含3轮运行,运行总数为75次。报告标注的数据批次是2026年8月31日。执行模型是gpt-5.6-luna,思考强度为medium,每次运行的时间上限为30分钟。[2]
报告给出的结果如下:
| 方案 | 正确运行次数 | 每个正确答案的输入tokens |
|---|---|---|
| Tabbit CLI | 48/75 | 803,144 |
| Codex Chrome | 47/75 | 1,574,503 |
| Agent Browser | 45/75 | 2,057,883 |
这里的成本定义是:全部75次尝试的总消耗÷正确答案数。失败尝试的消耗包含其中;“成功任务的平均tokens”具有另一种统计口径。[2]
Tabbit与Codex Chrome相差一次正确运行。该样本对普遍正确率优势的证明能力有限,成本与完成时间的差异构成另一项观察。
报告的限制值得保留:Agent Browser来自后续单组实验,浏览器资料、缓存和实时网页状态具有差异。具体任务清单与详细运行记录缺席公开页面,评分模型检查最终状态、答案和引用来源,缺少浏览器回访与完整动作日志审阅。[2]
这些数字属于Tabbit团队的自测结果。它们提供了工程方向的证据,其他团队的真实工作负载需要自己的复现与验收。
小模型的局部提速,需要任务级验证
原文披露了一组Jev与Kimi K3的内部实验。状态识别测试的样本是165张截图,Jev的准确率为95.2%;中位延迟为0.76秒,K3为8.54秒。[1]
端到端结果呈现了另一种情况:10个BU Bench任务包含118步,Jev承担了其中2步决策。局部识别成绩和完整任务收益,属于不同层次的证据。
这组小样本支持一个谨慎的使用方向:目标固定、输入清楚的局部判断,适合专项验证。开放任务的规划、恢复与结果核验,需要任务级测试。
它和代码路线讨论的是同一个问题:完整工作流的收益,是组件优化的验收依据。
WebMCP补充了网站一侧的接口
原文的另一条支线是WebMCP。Chrome官方文档中的WebMCP,是一项提议中的Web标准。网站提供结构化工具、输入输出定义和页面状态,Agent获得业务动作的明确说明。[5]
普通网页要求Agent理解界面;WebMCP允许网站声明工具用途。查询订单、筛选结果等动作,拥有了业务层面的入口。
2026年11月14日的资料核查结果是:官方采用方式包含Origin Trial与本地开发标志。提议标准、客户端支持与网站改造,构成它的落地条件。[5]
代码路线覆盖既有网站的操作需求,网站声明的工具提供另一类合作接口。权限、页面状态与结果验收,构成共同的工程要求。
苦涩之处,是旧设计需要接受新模型检验
我的判断是,这篇复盘揭示了一项架构责任:模型能力变化,要求工具设计接受任务级复测。
固定工具、定位器、底层协议和视觉渠道,具有不同用途。工程价值来自一套组合:模型拥有合适的表达能力,执行环境保存状态,观察材料支持判断,结果验证承担验收。
一个for循环带来的反思,是重复步骤的归属发生了变化。浏览器Agent的竞争,涉及模型能力、执行接口与完整任务质量三者的配合。
