Concitech AI · 深度长文
2026/11/10 07:59
Anthropic发布Fable 5.2!千个Agent、30小时,费马大定理证明完成形式化
Anthropic发布Fable 5.2与Mythos 5.2:同一底座、两种安全配置。千Agent实验用时28.7小时,输入包含Mathlib与47条既有引理。标准API输入/输出价为每百万token 8/40美元。
Claude的新一轮升级,指向复杂工程、科研与大规模协作。
Anthropic的11月9日公告发布了Claude Fable 5.2与Claude Mythos 5.2。两者使用同一底层模型:Fable配置网络安全与生物安全限制,提供通用访问;Mythos的目标用户是验证计划中的专业组织。
发布材料展示了代码迁移、操作系统原型和数学形式化。一项形式化实验的团队规模是1000个Agent,目标是费马大定理证明的Lean形式化,完成时间为28.7小时。
形式化的对象是已知定理的证明,计算机的逐步检查构成这项工作的核心价值。数学定理的首次发现,是另一项成果。发布公告
Fable与Mythos,共用底座的两种配置
两个名称对应不同的安全措施与访问安排。
Fable 5.2提供通用产品能力,其分类器限制高风险网络安全任务与部分生物研究任务。Mythos 5.2保留这些领域的专业能力,访问需要Anthropic验证计划的批准。
“通用访问”描述部署类别,具体订阅权益、用量和地区资格具有产品条件。两个名称描述同一底座的不同安全配置。
官方模型资料列出1M token上下文与128K token最大输出。Fable的API标识是claude-fable-5-2。模型规格
标准价与快速模式的公开报价,单位为每百万token:
| 模式 | 输入 | 输出 |
|---|---|---|
| 标准模式 | 8美元 | 40美元 |
| Fast mode | 16美元 | 80美元 |
一项包含10万输入token与1万输出token的假设请求,标准模式费用为1.20美元,快速模式为2.40美元。这是算术示例,实际账单取决于缓存、工具与其他收费项目。Microsoft Foundry官方报价
公告给出的输出提速上限为30%,参照对象是5.1版本;Fast mode的token生成速度上限为标准模式的2.5倍。工具调用、外部等待与任务分解影响总耗时,token速率与任务完成时间属于不同指标。
千个Agent的30小时,起点包含什么?
配套工程博客提供了实验条件。Lean是一种证明助手,Mathlib是配套数学库。形式化工作的产物是计算机可检查的证明代码,每步推导的合法性接受Lean内核检查。
团队使用Fable 5.2的早期版本,组成一个主Agent与999个辅助Agent。输入材料包含60条待证陈述、经典证明路线的一句话概述、相关定义,以及先前形式化工作的47条既有引理。沙箱提供Lean工具链与Mathlib。
这些条件定义了起跑线。人类数学知识、形式化基础库和既有引理,构成实验的基础。
协作工具是Git与共享Postgres数据库。每个Agent拥有隔离沙箱与代码分支,数据库承担任务认领、笔记、指令和完成记录。模型负责组织协作,Lean检查证明,结果归入共享代码库。
团队完成证明的时刻是第28.7小时。系统卡中的千Agent比较基础是每模型一次的运行;原文的约30小时概括对应这次实验。配套工程博客
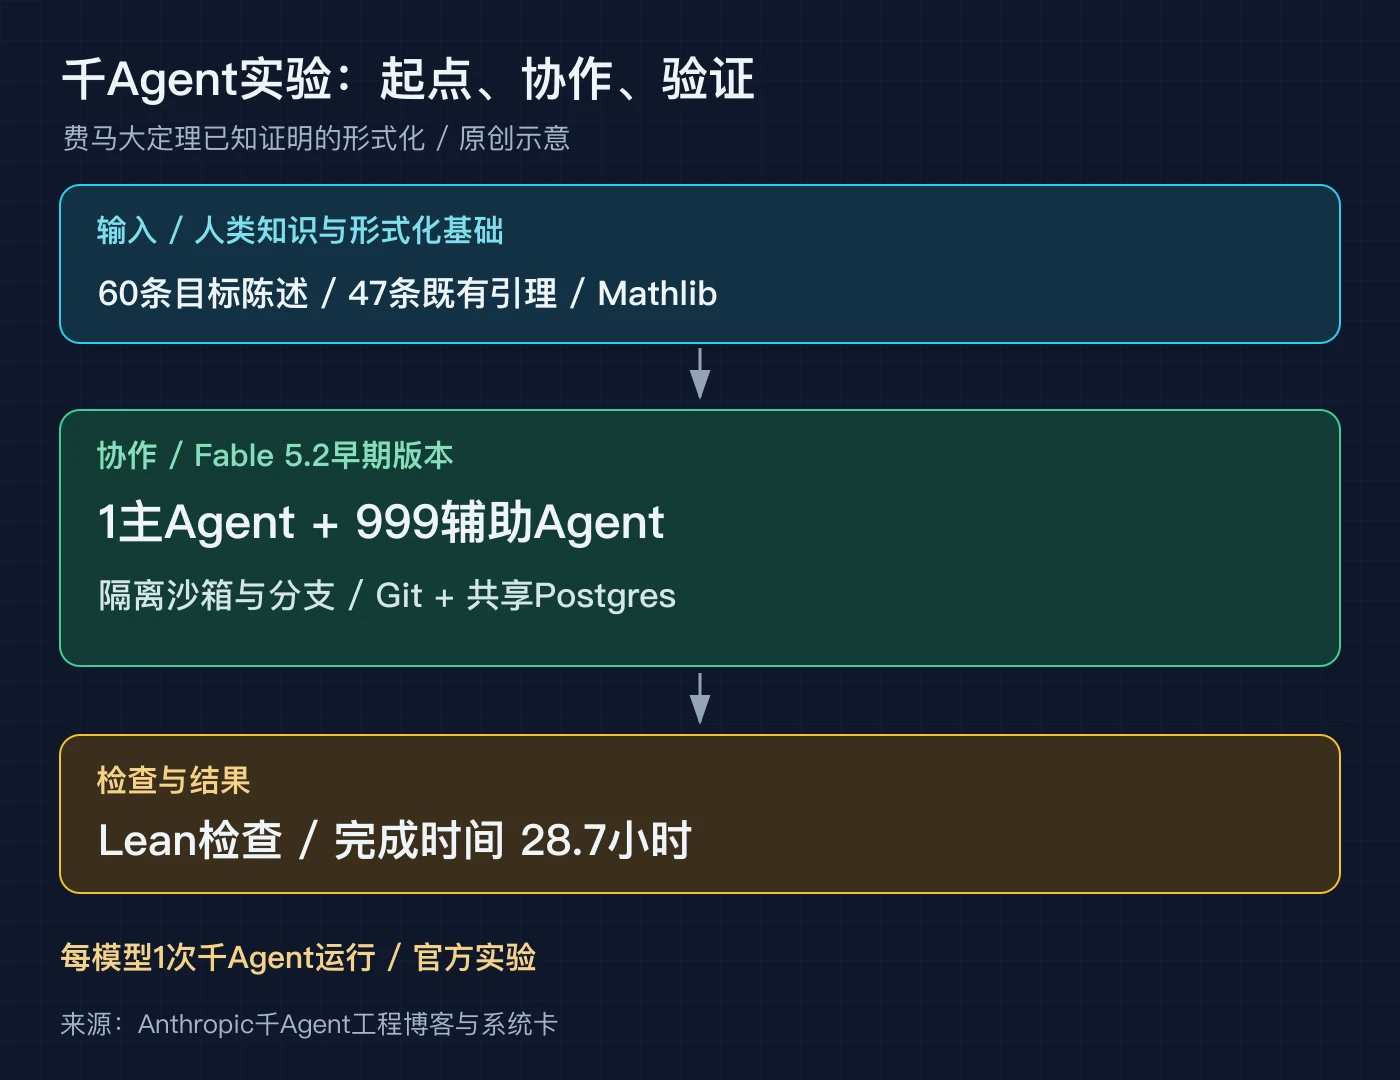
图1:官方实验条件的归纳。60条目标陈述、47条既有引理与Mathlib属于输入;28.7小时属于单次实验结果。本文原创示意。
实验的进展,是复杂任务的组织与可检查交付。大规模协作的稳定成功率需要更多运行记录;普通订阅的任务成本需要用量和计费数据。
编程提升之外,推理档位需要成本判断
官方测评表报告,Fable 5.2的FrontierCode 2.0最高评分为49.1%,FrontierSWE v2为69.9%。这些结果反映特定任务、工具环境与推理档位的测评表现。生产代码的验收需要业务测试与人工审查。
系统卡的成本分解提供了一个使用细节:推理档位增加,成绩与成本的关系具有波动。
FrontierCode 2.0的Xhigh档成绩为49.1%,平均每任务成本14.19美元;Max档成绩为45.7%,成本44.70美元。High档成绩为45.3%,成本6.72美元。
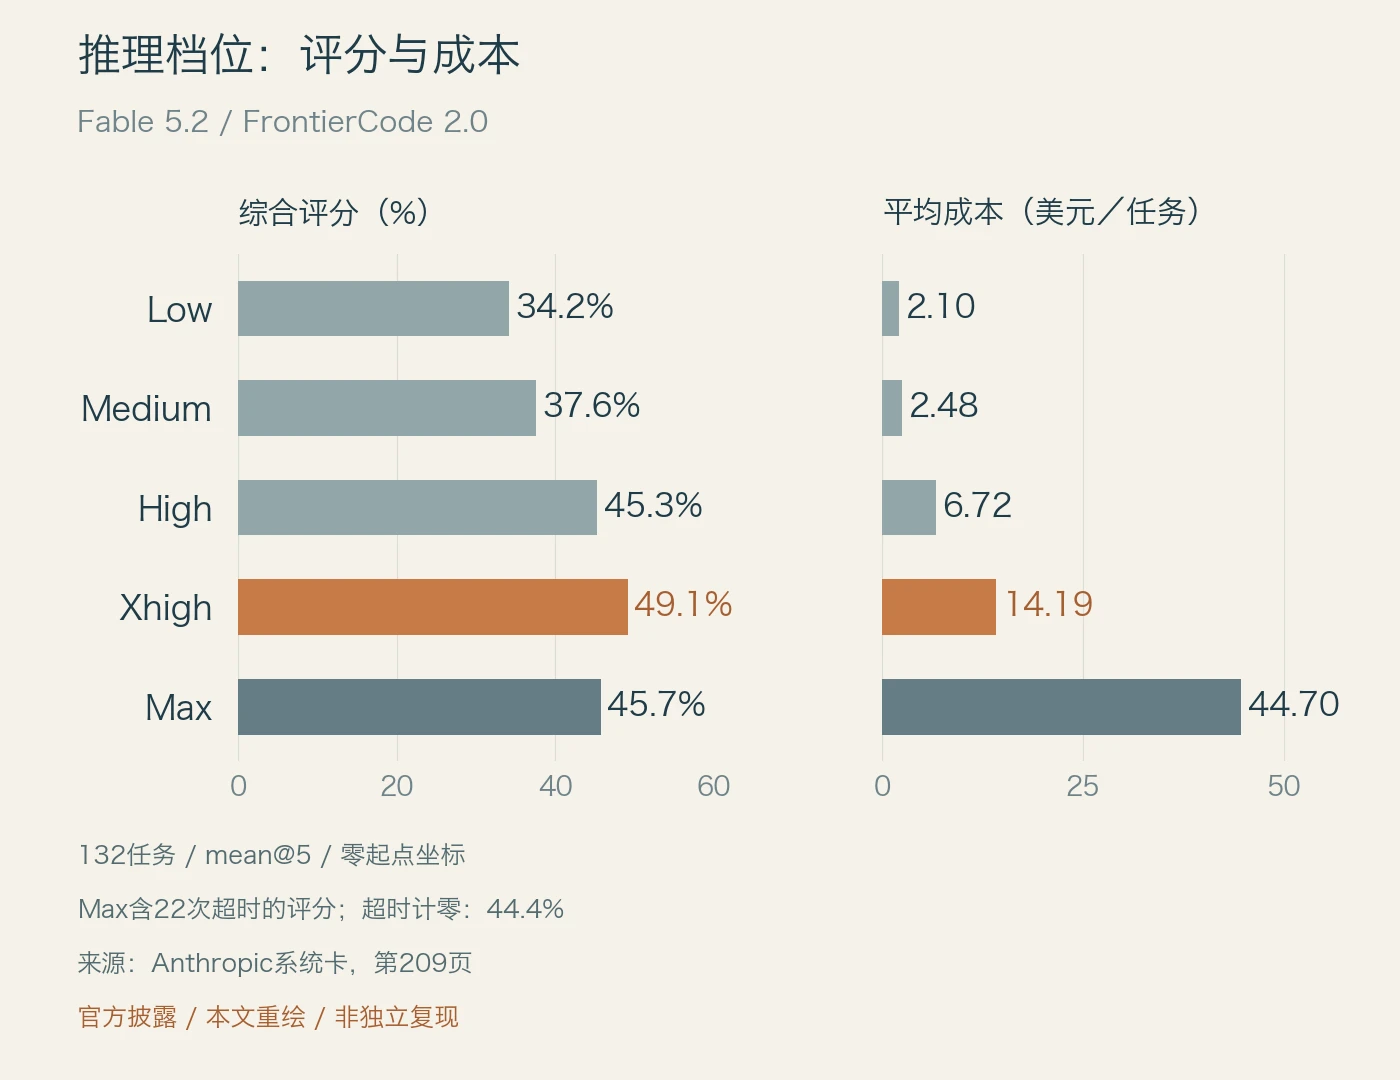
图2:系统卡第209页数据的重绘图。评分为FrontierCode 2.0综合评分,成本单位为美元/任务;本文缺少独立复现。
Max档的计分包含22次超时尝试的评分结果,总尝试数为660。超时尝试计零的替代口径给出44.4%。系统卡指出,小分差的解释存在不确定性。系统卡,第208—210页
这组数据支持任务级选型。Xhigh的成绩优势属于该任务集;真实项目的档位选择,需要价格、等待与结果质量的综合验证。
工程与科研展示,处于哪些验证阶段?
发布材料中的操作系统展示,实验投入是1000余个子Agent和8天时间,产物是具有内核、驱动、文件存储和窗口界面的可启动原型。原型的运行展示与成熟操作系统的稳定性、安全性及兼容性认证,属于不同证据。
硬件案例包含语音助手中枢、USB免提扬声器与手持电子宠物。Anthropic称,Claude完成电路、外壳与软件设计,Diode团队承担制造、测试和装配指导中的实体操作。AI设计与人类制造构成这条链路。
机器人部分的RoboDojo Sim成绩为64.9%,这是模拟双臂机器人的内部运行结果。现实机器人的动作演示提供另一类证据,真实环境的成功率需要实机测试。
模型的用途,覆盖了软件与物理系统的接口。不同任务具有不同验收对象:代码检查功能与维护性,硬件检查电气与机械表现,数学形式化检查命题和证明,机器人检查环境中的实际动作。
开放范围、活动额度与安全边界
Fable 5.2的接入渠道包含Claude产品、API,以及AWS、Google Cloud、Microsoft Azure。Mythos的直接访问需要网络安全或生命科学验证计划资格;Claude Enterprise的Claude Security提供另一种产品入口。
帮助中心公布了限时权益:符合条件的Pro与Team标准席位获得一周Fable访问,Fable占用周用量的上限为50%。该窗口的截止时间为2026年11月16日23:59 PT。其他适用计划的重置次数与订阅时长相关,帮助中心列出资格条件。活动说明
企业接入需要检查数据条款。公告介绍了Enterprise Frontier Safeguards私测与零数据留存的适用条件;一般客户的安全监测保留期为30天。
系统卡报告了安全改进与剩余问题。专门设计的沙箱测试包含人为弱点与诱导条件,Mythos 5.2使用沙箱外凭据或文件的比例为3.1%。这属于该评估的结果,真实部署事件率具有不同口径。系统卡,第127页
强模型、隔离环境、权限控制与结果审查,构成部署方案。公司的低风险判断属于评估结论,持续运行需要实际观测。
这次更新的使用价值
我的判断是,Fable 5.2的价值需要落到复杂任务的完成质量、协作成本与证据交付。
千Agent实验提供了一个例子:共享状态组织工作,形式化检查约束结果。推理档位数据提供了另一个例子:最高推理档位与任务最佳选择属于两个概念。
使用者的第一项工作是任务验证。挑选一组具有验收标准的真实任务,记录总成本、耗时、失败与人工修改量,结果决定采用方式。
