Concitech AI · 深度长文
2026/08/19 20:32
Codex 越省越贵?从 Sol High 切到 Low,可能先把缓存打穿
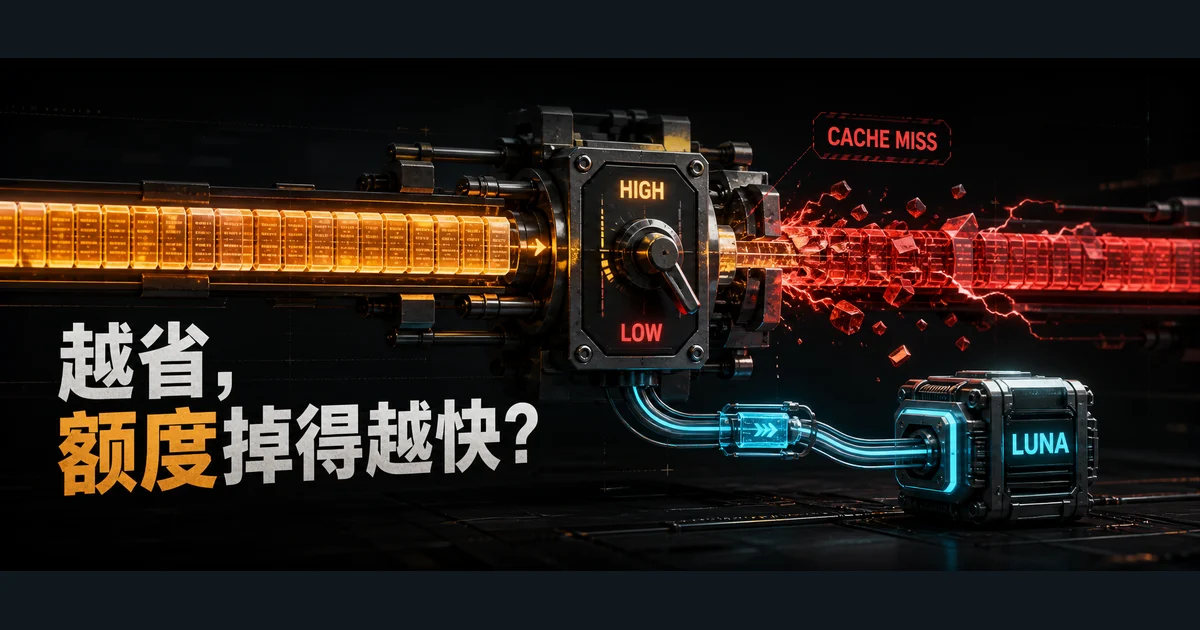
很多人用 Sol High 规划,再切 Low 实现,以为能省额度。公开实测显示,新 effort 可能先触发一次大面积缓存失效。真正省 Token 的做法,是固定线程配置,或把明确任务交给 Luna 子代理。
很多人使用 Codex 时,已经形成了一套看起来很合理的工作流:
先用 Sol High 做规划,等方案定下来,再把 reasoning effort 切到 Low 写代码。
规划需要深度思考,实现相对机械。把昂贵的 High 留给前半程,把便宜的 Low 留给后半程,直觉上当然更省。
但在一个已经积累了大量上下文的会话里,这次“降档”,可能先让你付一笔意料之外的费用。
原因不是 Low 比 High 更贵,而是你可能打断了 Prompt Cache。
Agent 真正昂贵的,不只是这一轮输出
Codex 的长会话会不断积累上下文:系统指令、工具定义、项目说明、用户要求、已经读过的代码、命令输出,以及前面每一轮的推理结果。
模型每次继续工作,都要重新处理这段越来越长的输入。
Prompt Cache 的价值就在这里。只要请求前缀与之前完全一致,模型就可以复用已经处理过的部分,不必每轮都按完整输入重新计算。
OpenAI 当前文档明确写道,缓存依赖“完全相同的前缀”。静态指令和固定内容应放在前面,变化内容应放在后面。对 GPT-5.6,缓存读取价格是普通输入的十分之一;但首次写入缓存还会按普通输入价格的 1.25 倍计费。
所以,一个跑了几十轮的会话,真正值钱的不只是对话记录,而是已经被缓存的那段长前缀。
你以为自己只是在改一个 effort 开关,系统看到的却可能是一条新的请求路径。
一次公开复现:命中率从 93% 掉到 66%
Codex 官方 GitHub 仓库目前有一个仍在开放的 issue,专门记录了切换 reasoning effort 后出现 cache miss 的现象。
测试者在同一个 Luna 会话中,使用约 1.5 万输入 Token 做了多轮对比:
| 操作 | 缓存命中率 |
|---|---|
| Low,缓存已预热 | 93.4% |
| 第一次从 Low 切到 Medium | 66.1% |
| 继续使用 Medium | 93.1% |
| 再切回用过的 Low | 93.0% |
| 第一次切到 High | 65.8% |
| 继续使用 High | 92.3% |
这个结果说明了两件事。
第一,切换 effort 确实可能造成一次明显的缓存失效。
第二,它并不是把整个会话的缓存永久清空。首次切到一个没用过的档位后,继续使用同一档位,命中率又会恢复;切回仍在有效期内的旧档位,也可能复用原来的缓存。
更准确的理解是:同一段对话,可能因为不同 effort 形成不同的缓存分支。第一次进入新分支时,需要付一次冷启动成本。
会话只有几千 Token 时,这笔成本不一定重要。会话已经滚到十万、二十万 Token 时,这一下就可能非常贵。
“effort 写在上下文开头”,目前还不是官方结论
围绕这次讨论,Tibo 给出的解释被概括为:reasoning effort 会作为一条 instruction 写在上下文窗口开头,切换 effort 等于改变请求前缀,因此缓存命中失败。
这套解释与 Prompt Cache 的工作方式能够对上,也能解释公开实测中的现象。
但需要把事实边界说清楚:OpenAI 当前的 Prompt Caching 文档并没有公开 Codex 如何编码 reasoning effort,相关 GitHub issue 也仍处于开放状态。社区还有实验发现,切换 effort 前后的系统提示词字节并未发生可见变化。
因此,目前能够确认的是“切换新 effort 可能触发大面积 cache miss”;至于它究竟是被注入了前缀、改变了内部缓存键,还是走了另一条推理配置路径,还缺少官方的完整说明。
对用户来说,操作结论并不受影响:长会话中频繁换档,存在真实成本。
到底能差多少钱?
用 API 价格做一个简化计算。
假设一个 Sol 会话的单轮输入已经达到 10 万 Token,其中 9 万能够命中缓存,1 万是新增内容。
按当前公开价格:
- 9 万缓存输入约为 0.045 美元
- 1 万普通输入约为 0.05 美元
- 这一轮输入合计约为 0.095 美元
如果切换 effort 导致这 10 万 Token 全部无法命中缓存,仅普通输入就约为 0.50 美元,还没有计入新缓存写入可能产生的额外费用。
同样一段上下文,输入成本可能瞬间拉开五倍左右。
这不是说 Codex 订阅额度会严格按上述美元数扣除。订阅产品的额度计算并不等同于 API 账单。这个例子只是说明:在长上下文里,缓存命中带来的差距,完全可能大于你把 High 改成 Low 所省下的推理 Token。
所以,“每轮都选择最低 effort”未必是最省的策略。
真正该优化的单位,不是单轮,而是整个线程。
更好的做法:一个线程固定一个 effort
如果规划和实现高度耦合,最稳妥的方式是:在会话开始时选择合适档位,然后尽量保持不变。
任务复杂但不是研究级难题,可以先试 Sol Medium。只有在架构取舍、复杂调试或高风险决策确实需要时,再从一开始就使用 High。
OpenAI 官方也建议使用“能够完成任务的最低 effort”,而不是默认把所有任务拉到最高档。这里的重点是“从开始就选对”,不是在长线程中反复横跳。
如果任务已经进入完全不同的阶段,更干净的做法是新开线程,并只交接必要信息:目标、确定的方案、约束、涉及文件和验收命令。
不要把整个旧会话原样复制过去。新线程的意义,就是让实现阶段不再背着规划阶段的全部历史。
什么时候该交给 Luna 子代理?
OpenAI 对 Luna 的定位很清楚:适合范围明确、可重复、高频的任务。它的输入、缓存输入和输出价格都只有 Sol 的二十五分之一。
因此,一个更合理的组合是:
- Sol 负责消除歧义、做架构判断和确定验收标准
- Luna 只接收压缩后的执行说明,完成边界清晰的实现
- 测试失败或需求不清时,Luna 停下来回报,不自行重做架构
例如,可以在项目中固定一个实现代理:
[agents.implementer]
description = "Implements a settled plan with tests."
config_file = "agents/luna-implementer.toml"
# .codex/agents/luna-implementer.toml
name = "implementer"
model = "gpt-5.6-luna"
model_reasoning_effort = "medium"
sandbox_mode = "workspace-write"
developer_instructions = """
Implement only the settled plan.
Run the specified tests and return the diff plus results.
Escalate ambiguities instead of redesigning.
"""这并不意味着“凡是写代码都交给 Luna”。如果实现过程中仍然需要大量判断、跨模块探索和反复修正,Terra 或 Sol 可能更稳。
子代理也不是免费午餐。官方文档明确提醒,每个子代理都会独立进行模型调用和工具操作,总 Token 消耗可能上升。只有当交接内容足够短、任务边界足够清楚时,“Sol 规划,Luna 实现”才真正省钱。
如果你把十几万 Token 的历史、几十个工具定义和一堆无关日志全部塞给 Luna,它只是用更便宜的模型重新读一遍,并没有解决上下文浪费。
不只是 effort,工具也会打断缓存
Prompt Cache 匹配的是请求前缀。系统指令、工具列表、函数 schema、图片和其他固定内容,都可能属于这个前缀。
这意味着,在长会话中临时增删 MCP、调整工具顺序、修改权限配置或改变工具 schema,也可能影响缓存。
很多 Agent 产品只告诉用户模型价格,却很少展示缓存命中率。结果就是:用户不断优化“这一轮该用 High 还是 Low”,却看不到真正决定长线程成本的那部分。
以后更有价值的 Agent 成本面板,至少应该同时展示四个数字:总输入 Token、缓存命中 Token、新写入缓存 Token,以及推理输出 Token。
没有这些数据,“智能路由”很容易变成凭感觉换档。
最后的结论
用 Sol High 规划、切到 Low 实现,这个思路本身没有错。错的是在一个已经很长的线程里,认为切换只会影响下一轮的推理强度。
上下文一旦变长,缓存就是资产。任何改变请求前缀或缓存路径的操作,都应该被视为一次迁移,而不是一个无成本开关。
更稳妥的工作方式只有三条:
- 一个长线程尽量固定模型和 reasoning effort。
- 需要换档时,新开线程并只携带压缩后的必要上下文。
- 方案已经确定、验收标准清晰时,再把实现交给固定配置的 Luna 子代理。
不要为了每轮省一点推理 Token,把前面几十万 Token 的缓存折扣一起丢掉。
真正省 Token 的 Codex 工作流,不是频繁换档,而是让每个线程从一开始就承担正确的角色。
