Concitech AI · 深度长文
2026/09/03 12:31
Gemini 3.8 Flash 上线:单价没涨,但 Google 提醒它会主动多用 Token
Google 在六周内第三次更新 Flash。Gemini 3.8 Flash 的促销单价维持不变,复杂任务却会增加推理步骤和工具调用。对 Agent 开发者来说,模型价格表已经不够用了,真正要测的是一次任务的完整成本。
Google 又更新了 Flash。
7 月 21 日是 Gemini 3.6 Flash,8 月 13 日是 3.7 Flash,9 月 2 日轮到 3.8 Flash。六周三次迭代,已经不像传统模型发布,更像一个高速滚动的软件版本。
这次有个容易被价格表遮住的变化。Gemini 3.8 Flash 的每百万 Token 单价和 3.7 相同,但 Google 主动提醒:新模型在复杂任务上会“更努力”,多走几步推理,多调用几次工具,有时也会使用更多 Token。
单价没有涨,一次任务的账单仍可能变化。
Flash 已经不再等于“少想一点”
Gemini 3.8 Flash 已正式 GA,面向长周期软件工程、自主 Agent 和复杂企业流程。它支持 100 万 Token 上下文、最高 6.4 万 Token 输出,以及 low、medium、high 三档 thinking level,默认是 medium。
Google 公布的 DeepSWE v1.1 结果中,3.8 Flash 得分 73.7%,3.7 Flash 为 65.3%;Claude Opus 5 是 74.0%。两者只差 0.3 个百分点,但输入和输出单价并不在同一档。
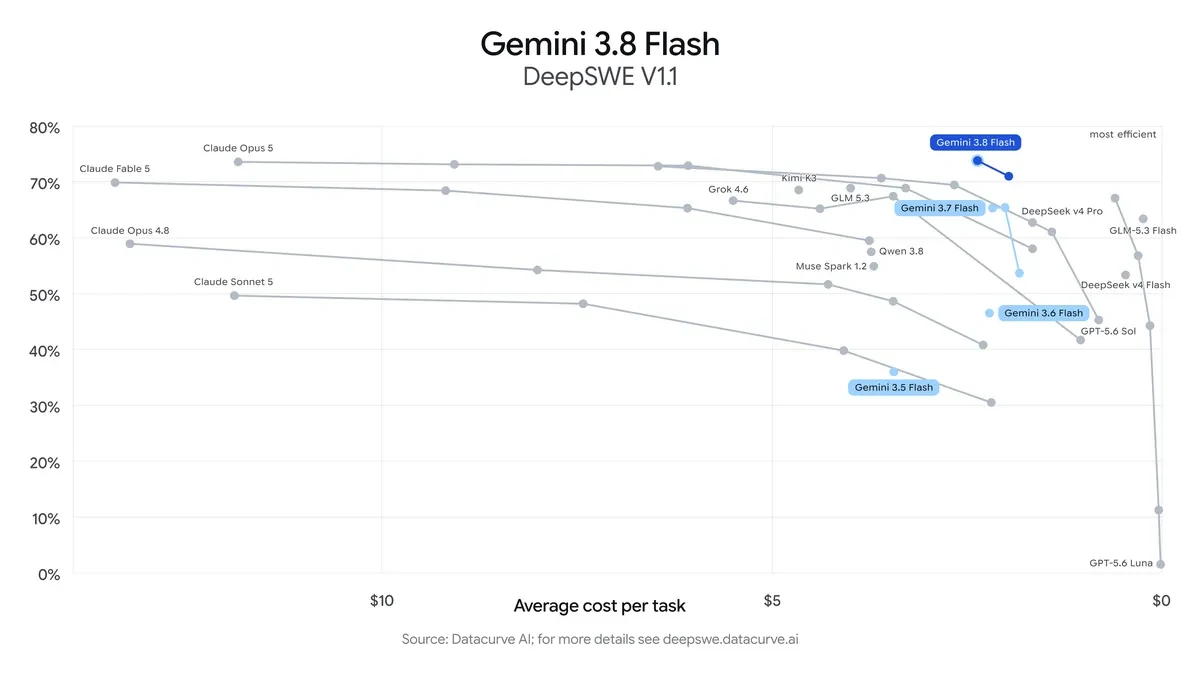
Google 的完整表格里,3.8 Flash 在 Vals Finance Agent v2、Harvey’s Legal Agent Benchmark、Terminal-bench 2.1 等多项测试中也高于 3.7。它并非处处第一:GDPVal-AA v2、Terminal-bench 4.0、OSWorld 2.0 和 BioMysteryBench 的部分设置中,其他模型仍然领先。
这些跨厂商对比由 Google 汇总,提示词、工具配置和推理强度都会影响结果。跑分可以用来决定哪些模型值得进入测试名单,不能替代团队在自家任务上的复现。
更有意思的是 Google 对进步原因的解释。3.8 Flash 会把困难目标拆成更小的推理步骤,反复调用工具,并在过程中检查结果。它不是用更少计算得到更高分,至少在部分任务上,是愿意花更多计算换成功率。
Flash 过去常被理解为低延迟、低价格的轻量选择。3.8 仍然便宜,但产品定位已经向 Agent 主力模型移动。便宜的是每个 Token,不一定是整次执行。
促销价只到 2026 年底
Gemini 3.8 Flash 当前的 API 价格是每百万输入 Token 0.75 美元、输出 Token 3.75 美元。这里的“当前”有明确期限:促销价在 2026 年 12 月 31 日结束,2027 年 1 月 1 日起将变成 1.50 美元和 7.50 美元,正好翻倍。
因此,今天做成本测算时,至少要保留两列数字:现在的促销成本,以及 2027 年标准价下的成本。只按眼前价格签长期商业模型,几个月后毛利率可能完全不同。
Agent 的账单还不能简单用输入单价加输出单价估算。一次任务会携带系统提示和历史上下文,调用搜索、代码执行或企业工具;失败后可能重试,工具结果又会进入下一轮上下文。
可以把它粗略理解成:
单任务成本 = Token 单价 × 实际用量 + 工具与基础设施成本 + 失败重试成本3.8 Flash 改变的是“实际用量”和“任务成功率”之间的取舍。多花 30% Token,如果让一次通过率从 60%升到 90%,总成本可能下降;如果一个原本简单的客服任务也开始反复思考,账单和延迟就会一起上升。
Google 给出的控制方式很直接。延迟敏感的聊天、告警和快速分析可以设为 low;复杂代码与多步 Agent 默认用 medium;确实需要深度推理时再开 high。3.8 不支持 minimal,如果计算效率比能力更重要,3.7 Flash 仍会继续提供。
因此,迁移评测不能只比回答质量。团队还要记录每次完成任务消耗的输入与输出 Token、工具调用轮数、耗时、失败率和人工接管率。最后看的是 100 个真实任务完成了多少、花了多少钱。
同一底座,另一扇门只向白名单开放
Google 同时发布了 Gemini 3.8 Flash Cyber。官方表示,两款模型来自同一套基础智能;区别在训练侧重点、安全措施与开放方式。
普通 3.8 Flash 带有针对网络攻击和 CBRN 风险的防护。Cyber 版为漏洞发现、补丁生成等专业工作放宽部分限制,因此不向普通开发者开放。申请者需要进入 Fairwind Program,主要面向政府与国家网络安全机构、关键基础设施运营商,以及维护广泛软件基础的核心技术平台。
Google DeepMind 称,Fairwind Program 目前在全球有 650 多个合作伙伴。这个数字指整个计划的合作网络,并不等于 650 家机构已经把 3.8 Flash Cyber 部署进生产。
项目的访问治理也比普通 API 严。参与机构需要启用用户级认证、抗钓鱼 MFA 和相应访问控制,只能把权限分配给内部安全、事件响应或渗透测试团队,还要追踪员工使用情况。模型访问不得转售、转发或共享。Google 会对申请机构做背景与安全记录审查。
Cyber 版的跑分很高,边界也要看清
在 CyberGym 的 C/C++ 漏洞发现任务中,3.8 Flash Cyber 的 Pass@1 是 86.2%,3.5 Flash Cyber 为 77.5%,GPT-5.5-Cyber 为 85.6%。
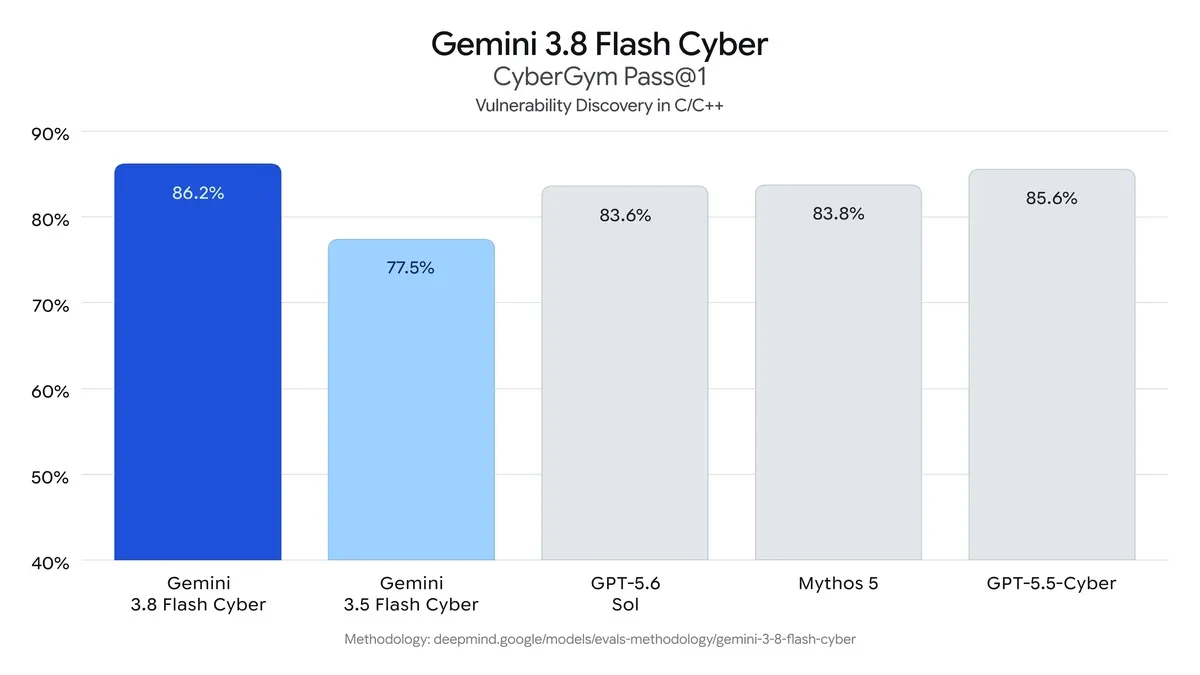
Google 还做了一套覆盖 20 种编程语言的内部漏洞发现评测,成功率超过 70%。在外部自动修补基准 CWE-Bench 上,3.8 Flash Cyber 的 Pass@1 为 47.2%,接近 Google 对照的前沿模型 47.8%,单次 Rollout 成本更低。
这些数字衡量的是规定环境下的发现或修补能力,并不直接等于真实系统中的漏洞检出率。CyberGym 主要覆盖 C/C++;20 种语言的测试是 Google 内部基准,外部尚无法完整复现。CWE-Bench 的结果还会受到 Agent Harness、工具和预算配置影响。
实际案例同样需要加上归因。Google 称,Chrome 安全团队使用该模型后,正确修复的漏洞数量是其对照中最佳商用大模型的 2.6 倍;Wiz 在内部渗透测试基准上报告召回率高 7.5至9.7 个百分点,成本低 2.3至5.2 倍;Google Cloud 漏洞研究团队则称,它在两小时内发现了一个通常需要数月研究的关键底层漏洞。
这些案例来自 Google 与合作伙伴,公开材料没有给出完整样本、对照模型名称和实验日志。它们说明模型已经进入真实安全流程,但还不足以独立验证普遍收益。
“提示词注入成功率 5.5%”不能直接外推
普通 Gemini 3.8 Flash 在 Gray Swan IPI 基准中的 ASR@15 为 5.5%,3.7 Flash 是 9.2%。图表里的数值越低越好。
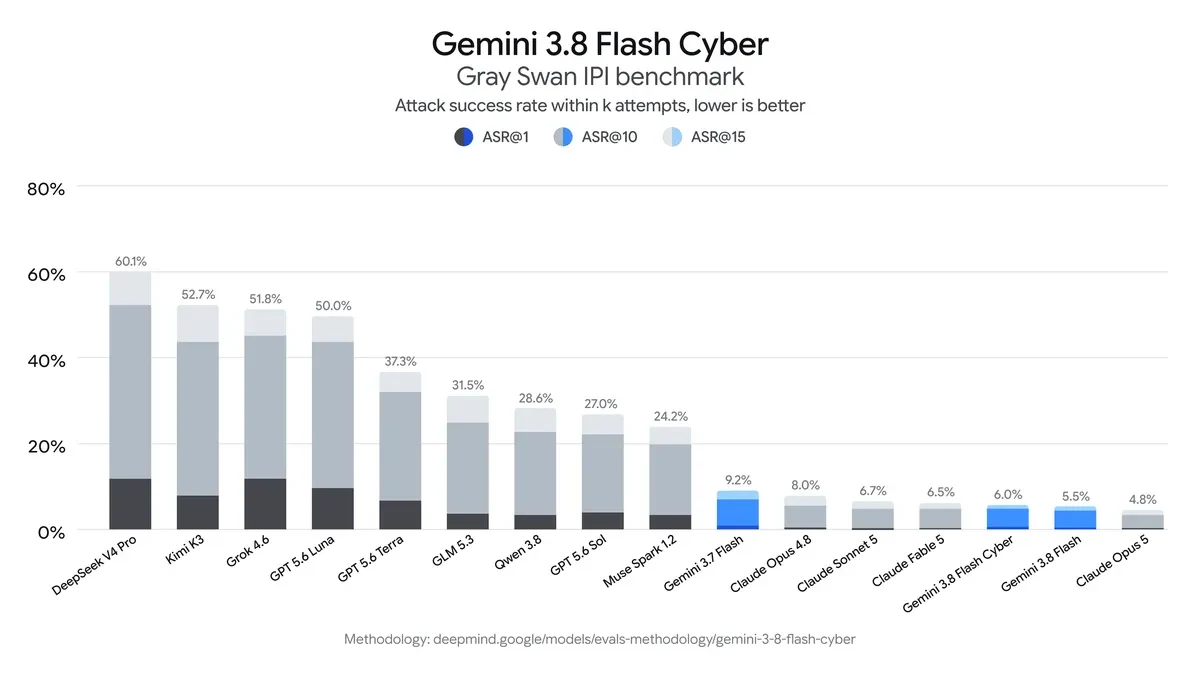
这项成绩对 Agent 很有价值。Agent 会读取网页、邮件、代码和工单,其中都可能夹带恶意指令。提示词注入一旦成功,模型可能泄露上下文,或调用不该调用的工具。
但 5.5% 是特定攻击集合、最多 15 次尝试条件下的基准结果,不能翻译成“真实世界只有 5.5% 的概率被攻破”。生产安全还取决于工具权限、数据隔离、审批、日志与检测。模型更不容易中招,只是防线中的一层。
模型卡里还有一条不那么漂亮的数据
Google 的模型卡显示,3.8 Flash 的多语言安全自动评测相对 3.7 回退了 5.4 个百分点。该指标越低越好,因此这是退步,不是提升。
Google 表示,人工复核发现其中绝大多数损失来自误报或不严重的问题,整体内容安全与人工红队结果和 3.7 相近或更好。即便如此,这条结果仍提醒开发者:能力升级可能伴随局部安全回归,尤其是非英语应用不能只看英文基准。
这也是版本升级前做本地 Eval 的理由。中文客服、中文工具描述和混合语言代码库需要单独测试;官方平均分无法替你覆盖自己的高风险输入。
该怎么判断要不要迁移
如果现有应用主要是短问答,3.8 的长周期推理未必带来足够收益,3.7 或低 thinking level 可能更省。如果任务包含多文件修改、连续工具调用或长报告生成,3.8 更值得测试。
测试时保持 Prompt、工具和数据集一致,分别跑 3.7 与 3.8 的 low、medium。记录成功率、P50/P95 延迟和单任务成本;只有高难任务再加入 high。成本预算还要按 2027 年标准价重算一次。
Gemini 3.8 Flash 已经从“快速回答模型”走向“可以长时间干活的便宜 Agent 模型”。它愿意多想,也会多花 Token。开发者最终需要判断的,是增加的计算有没有换来更高的任务完成率;这比价格表上的 0.75 美元更接近真实成本。
参考资料
- Google, Introducing Gemini 3.8 Flash and 3.8 Flash Cyber
- Google AI for Developers, What’s new in Gemini 3.8 Flash
- Google DeepMind, Gemini 3.8 Flash model card
- Google DeepMind, Fairwind Program
- Google DeepMind, Gemini 3.8 Flash
- 宝玉, 原始推文
