Concitech AI · 深度长文
2026/10/29 09:38
Gemini 4 Carbon 发布:Google 新旗舰的能力、价格与开放范围
Google 发布 Gemini 4 Carbon,重点涉及网络安全与长任务。Artificial Analysis 的综合指数给出 59 分、第一名的成绩,编程代理指数具有不同排名。本文介绍能力、评测口径、首发与常规定价,以及 Fairwind 的受控开放安排。开发者和消费者的全面开放日期待定。
Google 的新旗舰模型叫 Gemini 4 Carbon。发布日期是 2026 年 10 月 28 日,距离上一款 Gemini 4 Argon 的发布相隔两周。
这次升级的重点是网络安全与长周期工程任务。Carbon 的预定工作包含漏洞发现、风险验证、补丁生成,以及大型代码库的多步骤问题处理。
一个开放范围的区别需要说明:模型发布与大众可用,属于不同状态。Google 的发布公告提出了受控开放计划,初始对象是部分网络防御团队。开发者、企业和消费者的全面开放日期待定。
本文介绍这款模型的能力、评测口径、价格与使用资格。
1. 综合指数第一,意味着什么
Artificial Analysis 的指数页面给出了一项独立评测结果:Gemini 4 Carbon 的 High 配置获得 59 分,排名是 Intelligence Index v5.0 第一。
这是九项评测构成的综合指数,覆盖知识工作、编程、科学与通用知识。综合成绩衡量一组任务的表现,具体任务的选择需要单项评测。
Artificial Analysis 的发布分析提供了另一项结果:Carbon 搭配 Antigravity CLI 的 Coding Agent Index 得分为 59;Claude Opus 5.5 搭配 Claude Code 的对应成绩为 62。两个指数中的“59”,对应不同的任务集合。
综合指数第一与编程代理指数第一,具有不同含义。Agent 的比较对象包含模型、执行框架与推理配置。
同一份分析列出的规格是:100 万 Token 上下文,输入支持文本、图像、视频和语音,输出为文本。上下文容量说明输入空间,长材料中的准确检索与推理需要任务验证。
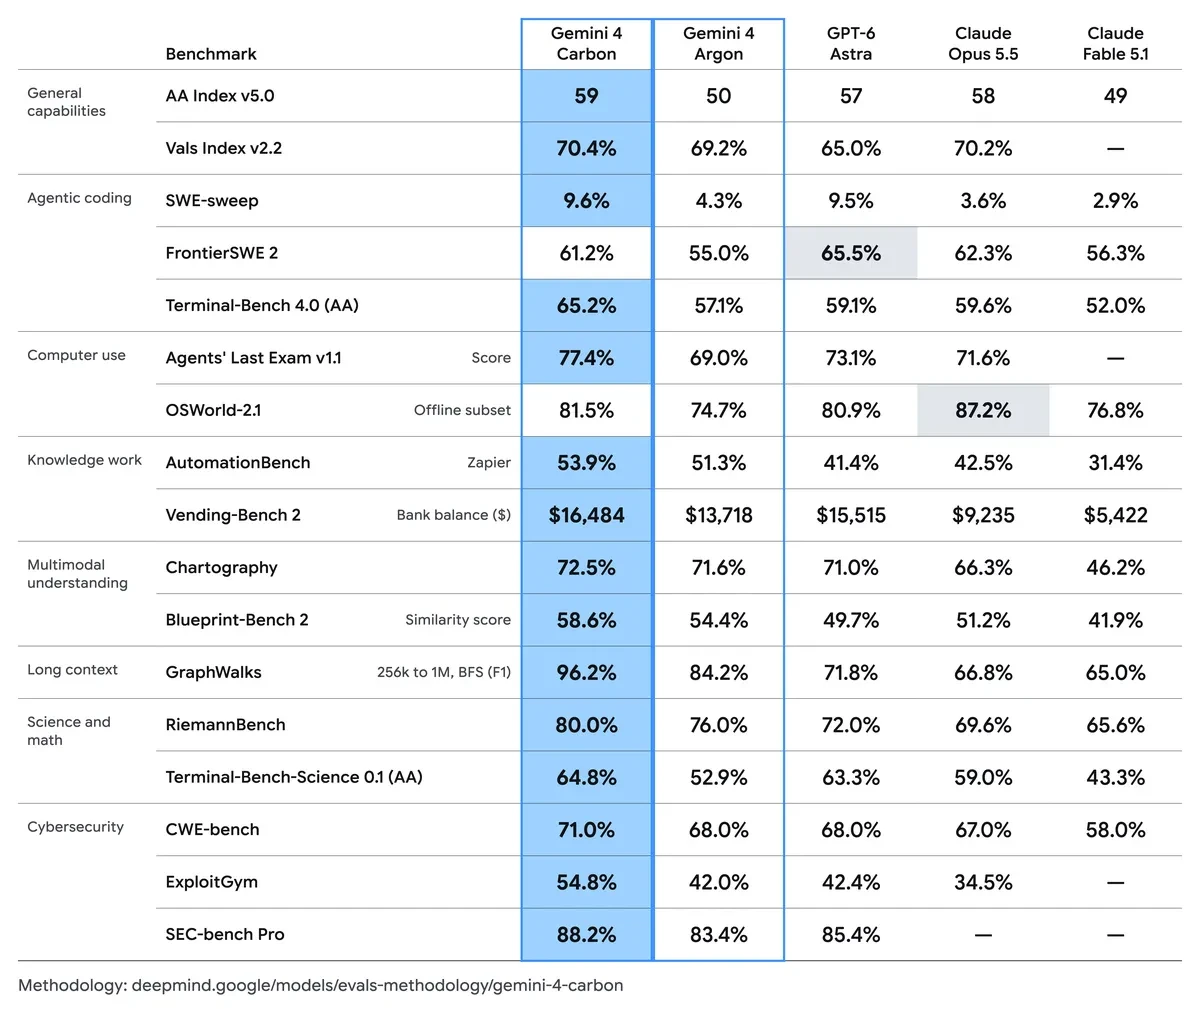
图:Google 官方评测汇总,保留原表与方法说明。发布方结果与独立机构结果具有各自的配置和口径。来源:Google 发布公告。
这张表呈现了不同任务的差异。Google 列出的 FrontierSWE 2 成绩,Carbon 为 61.2%,GPT-6 Astra 为 65.5%;综合优势与全部单项领先之间,存在范围区别。
2. 网络安全,覆盖三种任务
Carbon 的网络安全介绍涉及一条工作链:发现漏洞,验证风险,修复根因。三项分数对应三种任务,分数的相加或比值缺少可比口径。
| 评测 | 主要任务 | Carbon 成绩 |
|---|---|---|
| SEC-bench Pro | 复杂软件的漏洞发现与验证产物 | 88.2% |
| ExploitGym | 已知漏洞的利用可行性验证 | 54.8% |
| CWE-bench | 安全审计与补丁质量 | 71.0% |
前两项数值采用 Google 公告口径。CWE-bench 的公开 v1 榜单提供了 Carbon 的 71% 结果,配置为 Antigravity,指标是 programmatic pass@1。
SEC-bench Pro 的项目说明涉及 V8、Firefox 和 Linux 等目标,测试对象包含复杂软件系统的安全研究任务。本文查阅的公开榜单快照缺少 Carbon 条目,88.2% 的归属是 Google 的发布数据,独立复现属于另一项工作。
ExploitGym 项目使用真实漏洞构造任务,评估 Agent 的利用开发能力。它回答的是风险验证问题,生产系统测试需要授权记录和隔离环境。
CWE-bench要求 Agent 完成代码审计与补丁生成。验证器检查漏洞利用失效与既有功能的保持。分数的含义涉及补丁行为,超出了“模型写出一段解释”。
一项重要配置是:**Google 注明,公告中的网络安全外部评测采用关闭护栏的配置。**能力测量配置与用户产品的运行配置存在区别。这些分数缺少访问权限、授权范围或产品行为承诺的含义。
3. 长任务能力,关注工程过程
Google 报告了内部团队的使用观察:Carbon 承担持续数天的工程任务,工作涉及大型代码库与底层系统中的问题定位、补丁生成和多步骤处理。
这是一组内部使用观察,独立复现记录与通用成功率需要独立材料。持续运行的时长,缺少任务正确完成的单独证明能力。
长任务需要保存状态、解释失败、调整方案和检查修改结果。一项假设工作是跨模块的缺陷修复:日志提供线索,代码提供约束,测试检验行为,补丁需要审查。每个环节的输出构成后续行动的依据。
模型的价值,取决于这条证据链的质量。一次长时间运行的交付物,需要修改清单、验证结果和遗留问题。运行时长和生成代码数量,属于过程记录。
Google 的公告包含前端开发与多模态能力的改善描述。本文关注的是软件工程与网络防御,这些任务具有明确的验证对象,适合比较任务成功率、错误类型与人工复核成本。
4. 安全成绩中的“0%”,需要什么解释
Google 的安全介绍包含两项数值:Terminal-Bench 4.0 中的成功作弊率为 0.0%,作弊尝试率为 0.4%;Gray Swan 间接提示注入评测的攻击成功率为 0.0%。这些数值属于发布方报告。
作弊成功、作弊尝试与任务准确率,是三种指标。一次评测中的零成功攻击,与所有使用场景的安全保证,具有不同范围。
提示注入的风险来自指令与外部内容的混淆。网页、仓库和工具返回值包含信息,任务权限来自用户与系统约束。外部材料中的命令需要可信性检查,文件、凭据和外部写入需要权限边界。
我认为,这类安全改善的工程价值,需要真实项目的日志与复核记录检验。评测提供比较,最小权限、审计和回滚机制承担部署责任。
5. 价格、开放资格与接入预期
Google 公告给出了两组定价。单位是美元/每百万 Token,输入与输出采用不同单价。
| 价格阶段 | 输入 | 输出 |
|---|---|---|
| 首发优惠期 | 2 美元 | 10 美元 |
| 常规定价 | 4 美元 | 20 美元 |
缓存输入的价格折扣为 95%,即对应输入单价的 5%。常规价格下的缓存输入价格为每百万 Token 0.20 美元,这一数值获得 Artificial Analysis 分析的确认。优惠期结束时间缺少明确日期。
Token 单价与任务总成本属于不同指标。长任务的输出量、缓存命中、重试次数和工具开销,影响账单。模型之间的比较需要相同任务、相同成功标准与成本记录。
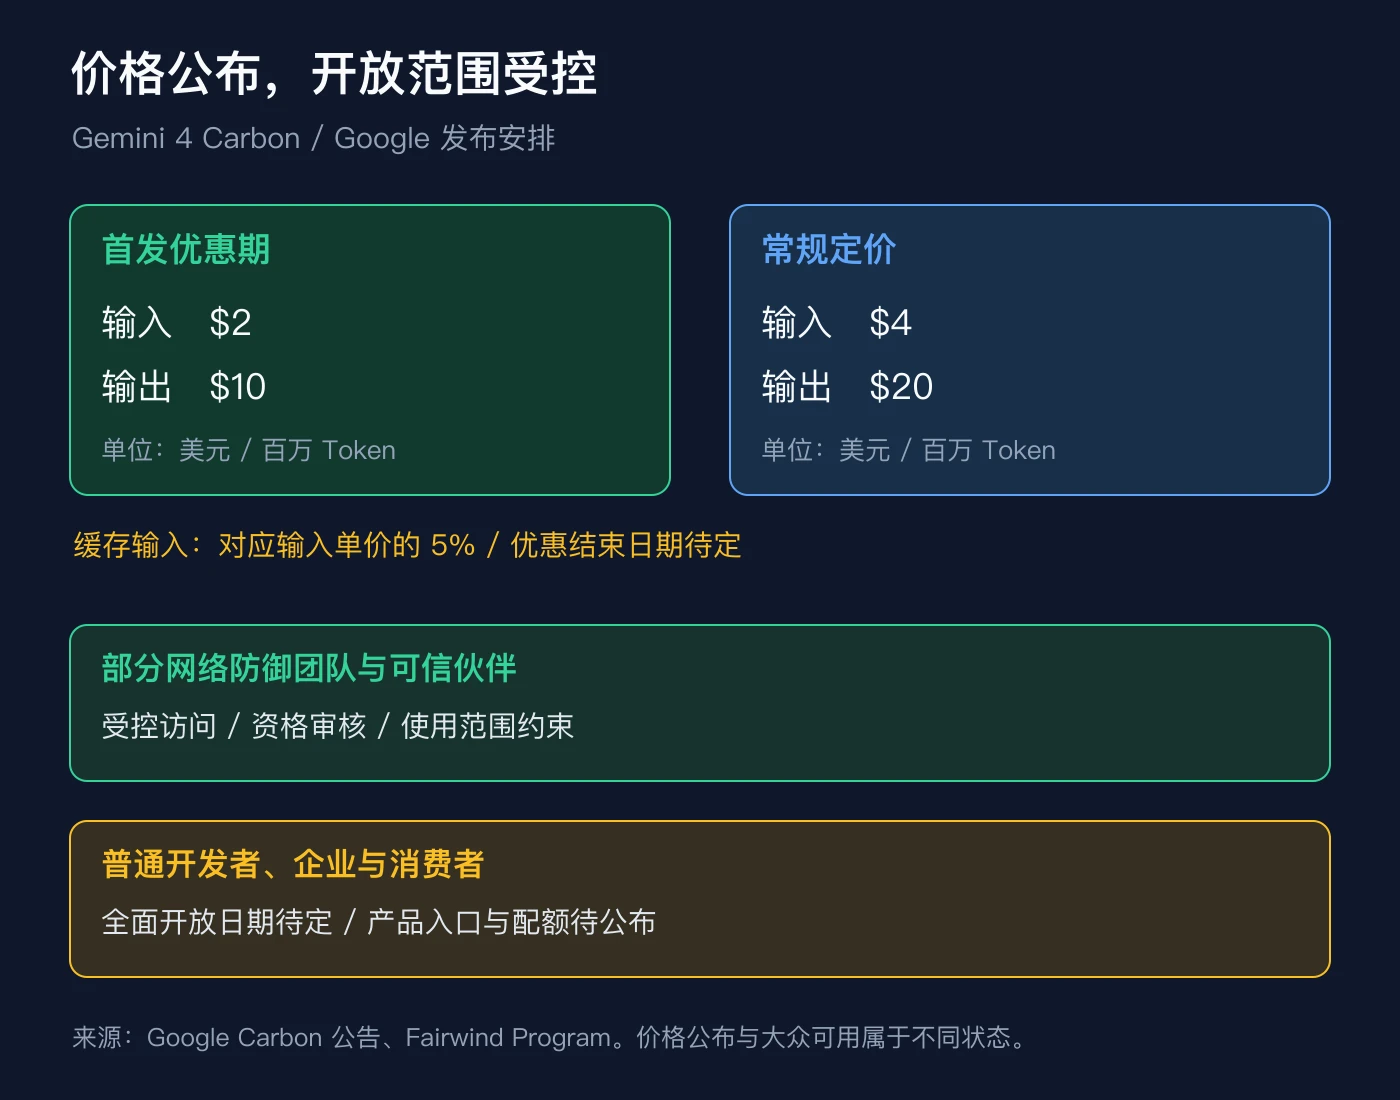
图:Google 公告中的预定开放安排与价格阶段。缓存输入价格为对应输入单价的 5%。优惠结束日期与全面开放日期待定。
开放资格对应 Fairwind Program。该计划面向经过审核的可信伙伴,关注政府、关键基础设施和核心技术平台等防御需求。项目具有背景审核、访问管理与使用范围要求。
Carbon 公告提出了部分网络防御团队的初始访问,以及可信伙伴范围的扩展。Fairwind 通用页面的部分产品说明指向 Argon;申请计划、获得 Carbon 权限与大众产品上线,是不同环节。
普通开发者需要等待具体产品入口、稳定的模型标识、API 文档、配额和地区说明。首发定价的公布,缺少公开 API 全面开放的证明含义。
Carbon 的发布呈现了两个方向:模型承担复杂工程任务,发布流程承担能力扩散的治理责任。可用入口、任务验证结果与真实成本,构成使用者的跟进重点。公开榜单提供选型起点。
