Concitech AI · 深度长文
2026/11/15 08:01
谷歌AI团队交卷!180万行Lean、80万行Rust,验证器决定成果去留
Google Research公布Antigravity Teamwork的科研与工程成果。韦伊猜想既有证明的形式化、Zircon迁移和TPU优化,呈现了不同的验收方式。本文介绍多Agent分工、代理评估器及产品开放范围。资料来源包含官方文档与原始论文。
180万行Lean,80万行Rust。两个数字,指向两种不同的工作。
2026年11月13日的Google Research文章,公布了Antigravity /teamwork 的科研与工程案例。参与者包含人类专家、Gemini 4系列模型和承担不同职责的Agent。[1]
谷歌报告的韦伊猜想形式化成果包含约180万行Lean;Zircon项目新增约80万行安全Rust。前者处理数学推导的机器核验,后者处理系统代码的迁移与运行。[1]
这组案例的共同机制,是候选方案接受验证。证明检查器、原始测试与硬件测量,承担不同类型的验收。
Teamwork的分工:提案需要质疑,交付需要证据
Teamwork是一套多Agent编排框架。官方文档中的工作流程包含需求界定、里程碑计划、实施和审查。用户定义目标与验收条件,Agent团队承担执行。[2]
Project Orchestrator负责项目拆分与交接。Explorers承担研究,Workers承担实现。审查侧具有不同职责:Critic检查正确性与接口,Challenger构造边界测试,Auditor核对测试证据,Success Auditor承担交付前的完整核验。[2]
一个Agent的“完成”陈述,需要命令输出、测试记录和验收结果的支撑。写代码与确认代码有效,属于两份工作。
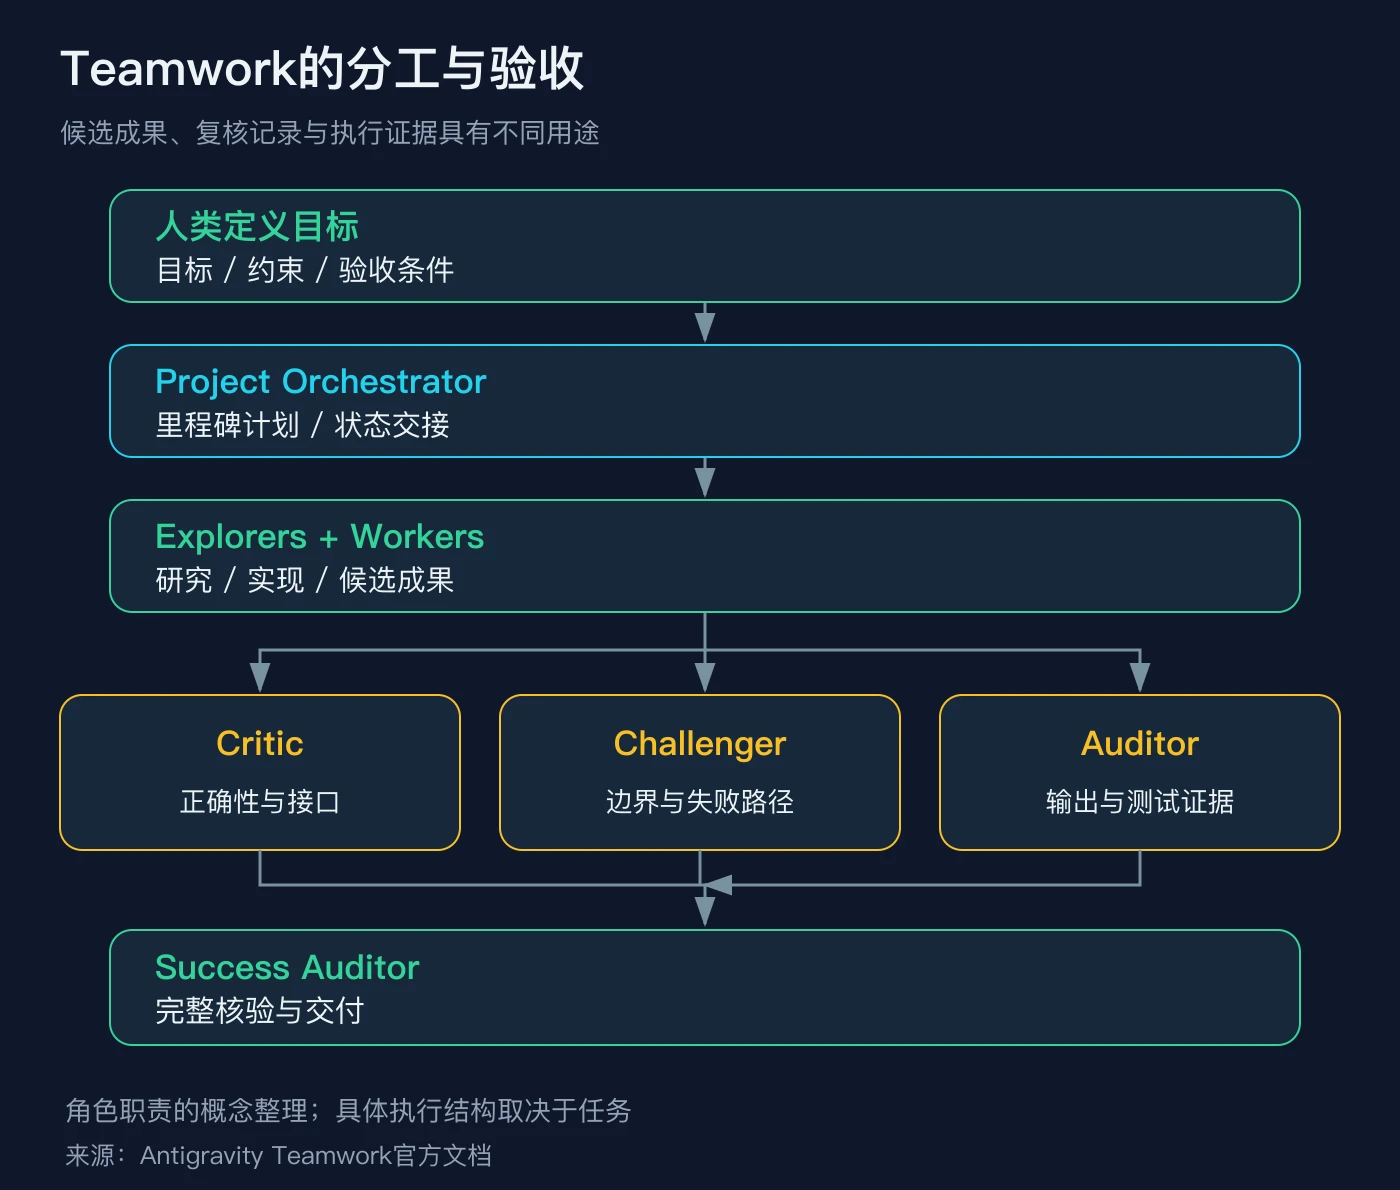
图:官方角色的职责示意。资料来源:Antigravity文档;图形性质:概念整理。[2]
上下文管理包含另一种分工。官方设计采用结构化交接,里程碑的继任者接收项目状态;隔离的执行轨道具有文件归属和工作记录。[2]
这类设计处理的是长期任务的状态维护问题。需求、完成项、失败证据和待解决问题,具有不同用途。交接材料的质量,影响后续工作。
数学案例包含两件事:发现证明,形式化证明
Courtade–Kumar猜想提供了新结果的例子。2026年9月的预印本《A Proof of the Most Informative Boolean Function Conjecture》,给出计算机辅助证明,提供端到端Lean验证材料。[3]
这个问题研究含噪通信中的信息保留:输入是一串随机比特,压缩结果是一个比特。猜想认为,复制某一个输入比特的“独裁者函数”,达到所讨论的信息上界。论文给出了对应的证明与计算验证记录。[3]
韦伊猜想的案例具有另一种性质。谷歌称,Teamwork-LEAP完成了既有证明的端到端形式化。相关数学成果的历史包含Deligne的1974年证明,约180万行Lean对应机器核验的形式化工程。[1]
**新数学结果、既有证明的形式化、形式化代码规模,是不同的信息。**行数描述工程体量,命题内容与核验方式描述数学意义。
机器检查器核验形式系统中的推导。数学家确认形式命题与原问题的对应关系。两者承担不同职责。[1]
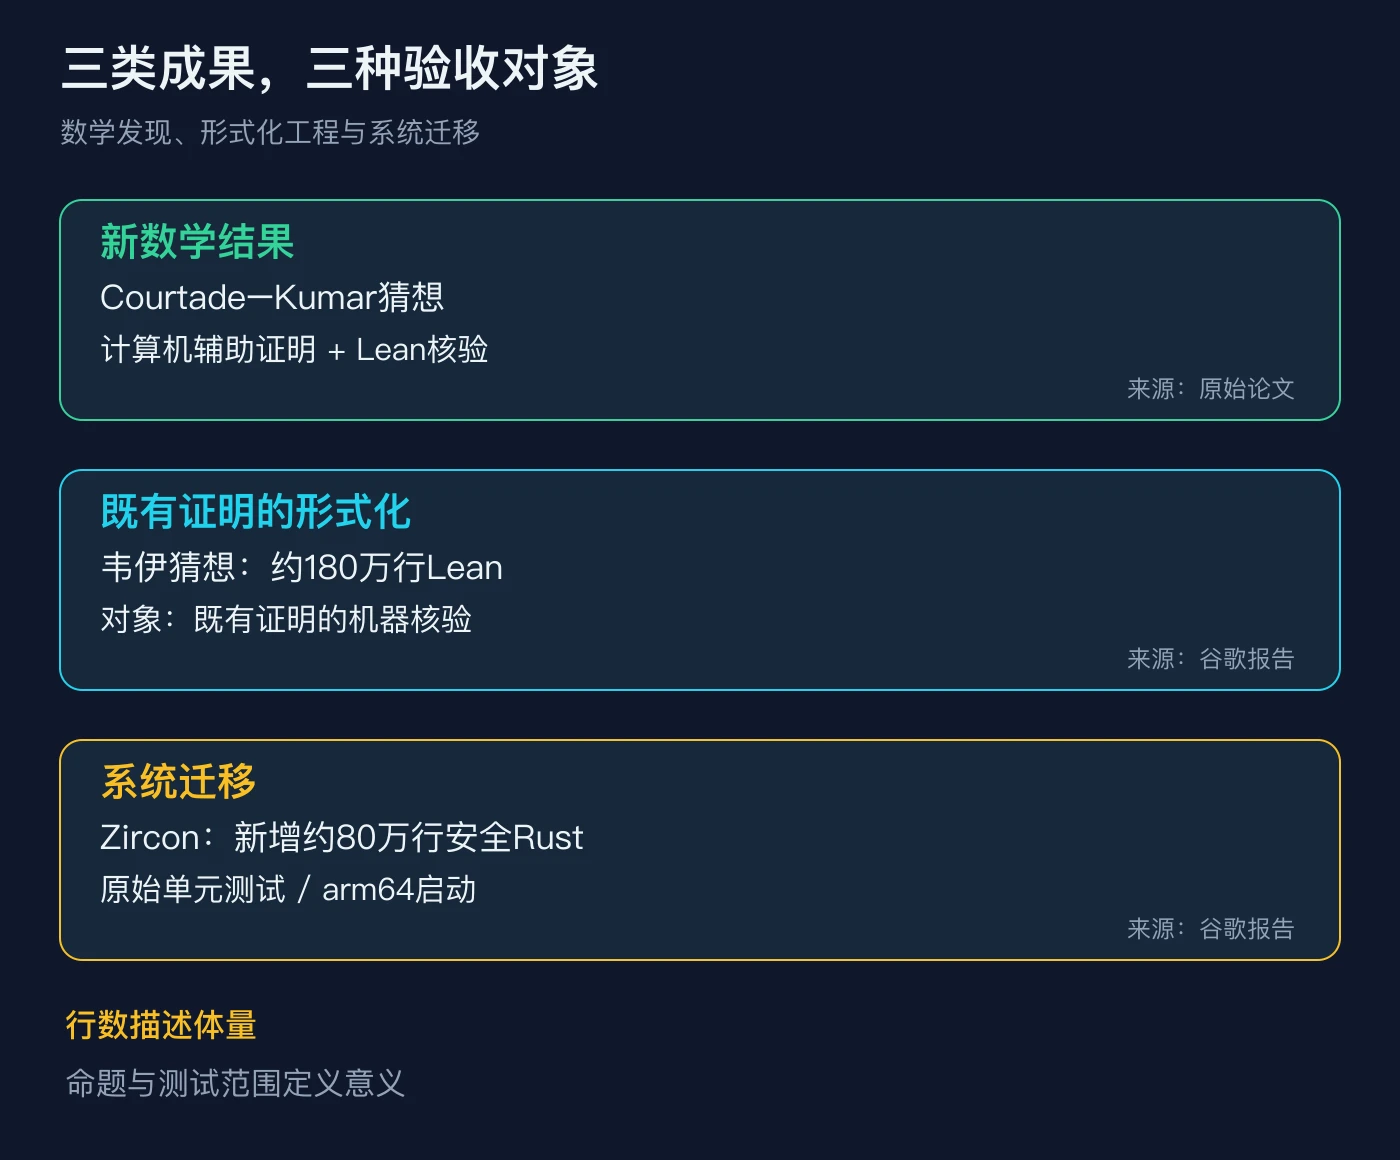
图:三类成果及其证据。资料来源:Google Research与Courtade–Kumar论文。[1][3]
Rust迁移的验收对象,是兼容性与运行结果
谷歌报告的Zircon案例,起点包含25%的已有迁移。两周的Argon工作新增约80万行安全Rust,原始内核单元测试通过,系统完成arm64硬件启动。[1]
这里的交付对象,是一个具有依赖关系的系统。模块的编译状态构成后续任务的前置条件,原始测试套件构成兼容性依据。[1]
编译通过、测试通过、硬件启动,检验不同的属性。完整产品的稳定性、性能与安全结论,需要对应测试范围的支撑。
这带来一个软件工程判断:迁移任务的难度,包含依赖组织与行为保持。生成代码的数量,需要配套的验证能力。
优化的另一个瓶颈,是评估本身的耗时
DuoDiscover研究处理了一类现实约束:完整评估成本高,候选方案的探索次数受到限制。它的Agent寻找优化目标,编写称为yardstick的快速代理评估器,执行候选搜索。[4]
DuoDiscover论文的评估对象,包含软件仓库与GPU、TPU内核。[4]
yardstick衡量局部改动的潜力,真实评估确认收益。保真测试检查代理排序与真实排序的一致性,系统淘汰失真的代理评估器。[4]
代理评估与完整评估具有不同职责:前者承担探索筛选,后者承担结果确认。搜索的速度与评估的可信程度,需要配套设计。[4]
这个机制处理了一个常见问题:分数提升与真实收益之间存在偏差。研究系统需要监测这个偏差,优化过程需要真实目标的约束。
我的判断是,科研Agent的工具建设包含两层工作:开发候选方案,建设可信的评估方法。评估器的质量,影响搜索方向。
工具入口开放,专项流程具有版本边界
2026年11月15日的官方文档核查结果是:付费套餐提供 /teamwork 与 /boost 的Antigravity App和CLI入口。Teamwork的目标任务是多里程碑项目,Boost的目标任务是复杂软件问题的迭代分析与验证。[2]
Deep Review提供文档审查入口。Google Research的2026年10月发布说明,列出了PDF与纯文本输入、每人每周两次免费审查。[5]
11月13日文章的后续开放清单,包含形式证明模式和新增Rust重写模式。[1] 研究团队采用的专项配置,与产品入口的默认能力,具有不同的覆盖范围。
工程团队的任务清单,包含定义目标、保存执行证据、建立结果判据和核对失败路径。模型能力决定候选方案的空间,验证体系决定成果的可信范围。
