Concitech AI · 深度长文
2026/10/10 08:25
Google 内测 Carbon:员工称编码体验接近 Opus 5.5
Google 内测 Carbon。员工称编码体验接近 Opus 5.5,公开性能结论缺少确认。文章介绍 Carbon 与 Argon 的关系、模型测评和发布边界。
Google 的 Gemini 4 Argon 有了公开公告,另一个内部名字进入新闻:Carbon。
Business Insider 的报道发布日期是 2026 年 10 月 9 日。记者 Hugh Langley 称,内部文件与截图显示,Google 员工测试了 Gemini 4 的新版本 Carbon,使用入口是内部编程平台 Jetski。
一位员工认为它的编码体验接近 Anthropic 的 Opus 5.5,提出了补充测试的需求。
这是一条有关模型迭代的消息,性能结论来自员工评价。Carbon 的公开评估报告、最终名称和发布日期属于报道缺失的信息。
新闻的焦点是编码任务。一个模型的能力包含代码生成、项目理解、工具使用和错误修复;一次令人满意的尝试,说明了一种体验,完整的性能判断需要任务记录。
Carbon、Barium-B、Argon,各是什么
公开产品名称与内部版本名称具有不同用途。内部团队需要区分训练结果、候选版本和实验对象,产品发布需要选择对外名称。
Business Insider 称,一份内部文件将 Barium-B 对应到公开名称 Gemini 4 Argon。Carbon 属于另一项内测版本,其对外名称与发布方式缺少确认。Google 拒绝评论这篇报道。
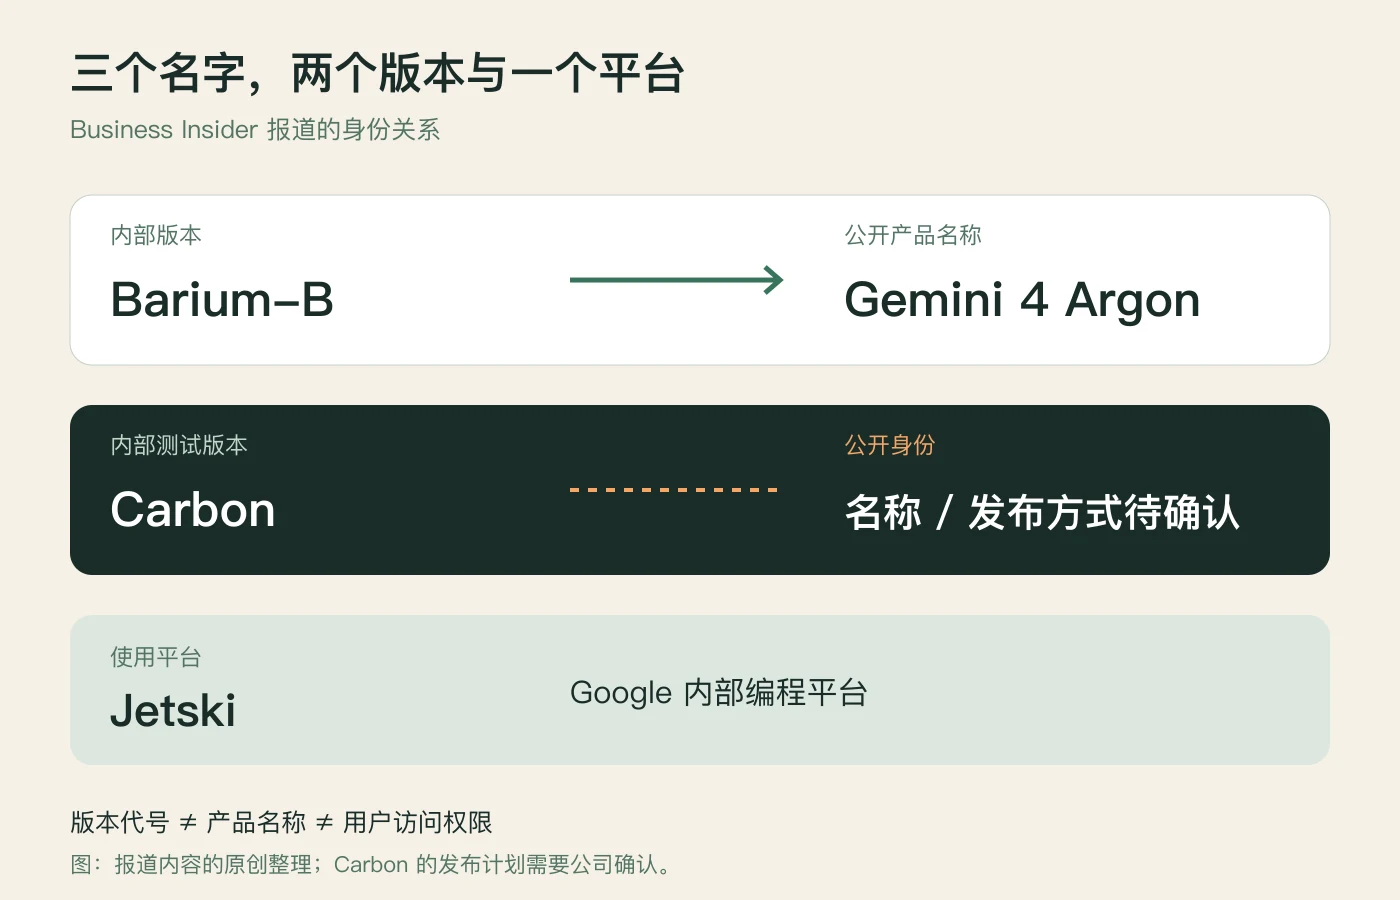
图:Business Insider 报道的名称关系整理。内部版本、产品名称与使用平台属于不同概念。
“Carbon 是 Argon 的升级产品”需要产品层面的确认。“Carbon 是一个内部测试版本”是这篇报道的描述。两个判断包含不同的信息量。
这一差别影响新闻阅读。内部测试说明候选模型进入了使用环节,发布说明用户获得某种访问权限。后者涉及产品接口、安全设置、资源调度与支持方案。
内部版本与公开版本的时间差具有工程原因。测试需要收集反馈,发布需要确定配置与边界。具体原因需要公司说明,版本名称缺少对发布策略的解释能力。
“接近 Opus 5.5”,描述了什么
员工评价提供了一条体验线索,比较对象是 Opus 5.5。评价的任务范围、样本数量和失败记录决定它的解释范围。
一个代码修改任务包含多个环节:理解需求、寻找相关文件、生成改动、执行测试、解释结果。体验评价需要说明哪个环节获得改善。
一个依赖升级任务的成功,涉及编译、行为兼容与回归测试。一个页面原型的成功,涉及界面和展示路径。两者的验收标准不同,“编码效果好”省略了任务类型。
这个例子属于评价方法的说明,缺少 Carbon 的实际测试含义。报道提供了员工感受,公开对比实验需要目标仓库、任务清单、预算与验收结果。
模型评价需要保留失败。错误定位、无效重试、无关文件修改和修复后的新故障,构成编程工具的使用成本。成功样例展示上限,失败记录揭示适用边界。
一次模型更新的实际价值,需要交付结果解释:用户获得的代码是否满足要求,维护者承担多少审查工作,错误恢复需要多少人工参与。
Argon 的成绩,属于 Argon
Google 的 Argon 公告发布日期是 2026 年 9 月 30 日。公告介绍了软件工程、企业知识工作和网络安全防御等用途。Google 报告的 DeepSWE v1.1 成绩为 77.9%。
DeepMind 的方法说明指出,该项 Argon 成绩来自 Google 测试,使用 mini-swe-agent;竞品成绩来自公开榜单或相应系统卡。成绩具有指定的测试设置与来源。
Artificial Analysis 的 Argon(High)页面显示,综合智能指数为 53。本文核对日期是 2026 年 10 月 10 日。这是包含多项评估的综合指标,纯编码能力排名属于另一种问题。
这些材料描述 Argon,缺少对 Carbon 成绩的证明。内部新版本的体验评价与旧版本的公开测试,属于两组对象。
一个性能比较需要模型版本、推理设置、工具环境和预算的对应关系。不同测试的分数具有不同分母,综合指数与任务通过率具有不同含义。
用户需要关注的,是任务适配。代码维护、终端操作、业务流程和长文档分析涉及不同能力。某项成绩领先,支持该项测试的结论,通用编程优劣需要其他证据。
模型与编程平台,构成一个系统
Carbon 的报道提到了 Jetski。这个名称提示了一层产品环境:员工体验的是模型与内部编程平台的组合。
编程平台决定模型获取哪些材料、调用哪些工具、执行哪些命令。仓库检索、测试环境与执行权限影响任务完成方式。模型的能力与平台的组织方式需要区分。
完整仓库与代码片段提供不同的信息。一个工具环境允许执行测试,另一个环境返回代码文本,它们提供的反馈不同。
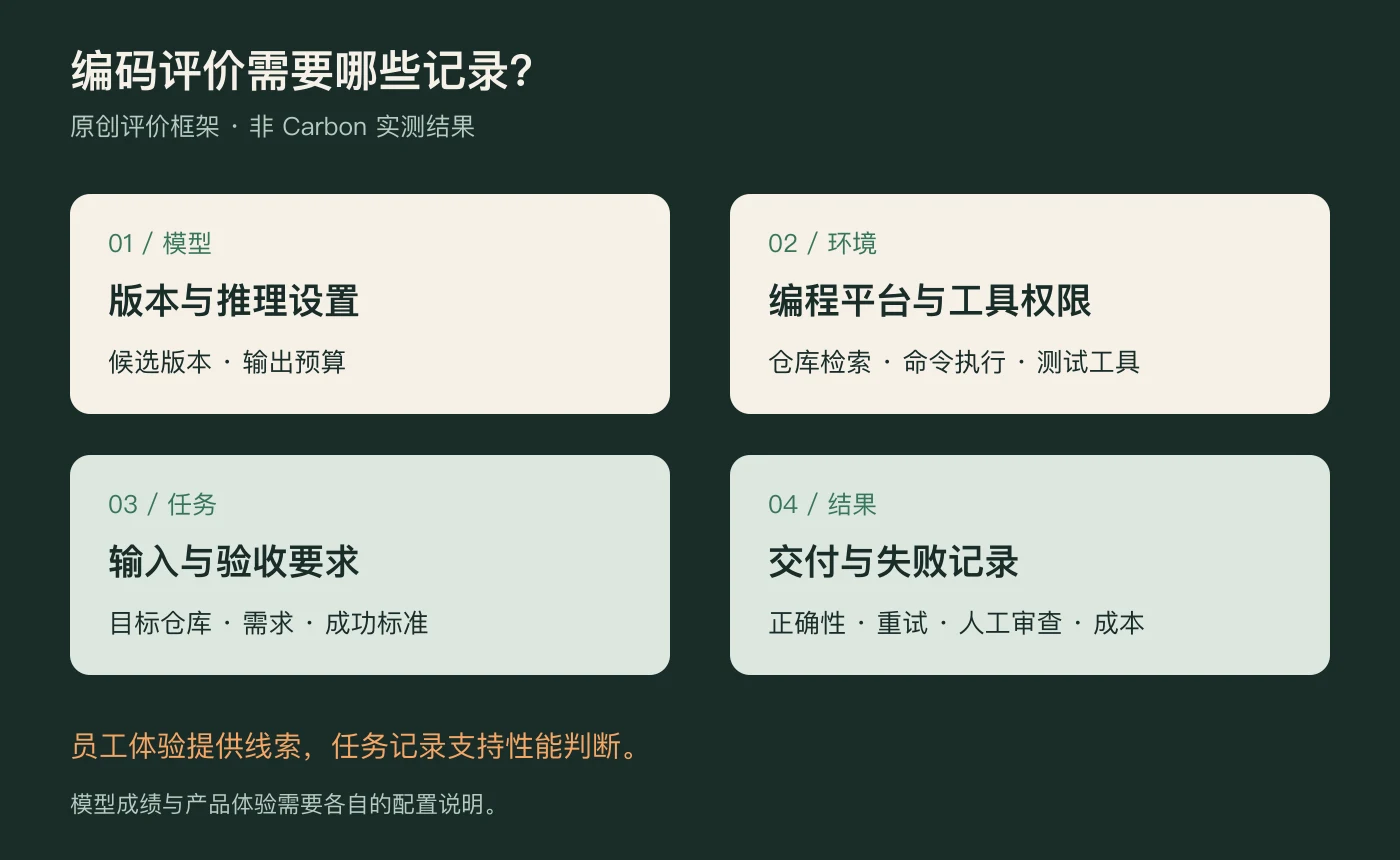
图:编码评价的检查对象。图示属于评价方法,Carbon 实测结果需要独立报告。
这解释了“模型跑分”和“编程助手体验”的区别。前者需要说明评估配置,后者需要说明完整产品环境。Carbon 的内测反馈提供了产品环境中的感受,公开比较需要明确环境差异。
开发者的评估任务需要对应真实工作。一个自有项目的缺陷修复、一次接口调整或一项依赖升级,提供具体的比较对象。相同输入、验收要求和资源预算帮助缩小评价的歧义。
代码通过现有测试是一份证据。需求满足情况、改动范围和回归风险需要其他检查。模型的解释与生成的测试具有相同的误解风险,验收需要需求和真实行为的支持。
发布公告、试用入口与交付质量
Google 的 Argon 公告描述了分阶段开放方案:初始对象是 Fairwind Program 的受信任网络安全防御者,后续计划涉及付费 API 客户与 Google AI Ultra 订阅者。公告缺少各阶段的具体日期。
这份公告描述的是 Argon 的发布安排,Carbon 的发布计划需要另一份确认。公开宣布模型、提供有限访问与提供普通用户的购买入口,是三种不同状态。
这条新闻提供的变化,是 Google 编码模型内测的新线索。匿名员工的积极评价值得记录,正式发布与公开测评需要独立的信息。
开发者关心的答案有四个:产品名称是什么,访问入口在哪里,任务表现如何,成功交付的成本是多少。内部代号回答了版本身份的一部分,完整答案需要发布资料和使用记录。
Carbon 的产品身份需要发布公告,编码表现需要任务记录。内部代号提供新闻线索,交付质量决定工具价值。
