Concitech AI · 深度长文
2026/09/23 09:11
GPT-6 Sol、Luna 登场:Agent 价格战进入 0.1 美元时代
OpenAI 发布 GPT-6 Sol 和 Luna。Sol 每百万输入 Token 价格为 2 美元,Luna 为 0.1 美元。1.05M 上下文与一折缓存定价改写 Agent 成本结构。
OpenAI 发布 GPT-6 Sol 和 GPT-6 Luna。两个模型继承 GPT-6 Astra 的训练路线,产品定位指向 Agent 与高频工作负载。
一组数字构成发布核心:Sol 的每百万输入 Token 价格是 2 美元,Luna 是 0.1 美元。Sol 的缓存输入价格是 0.2 美元,Luna 是 0.01 美元。
模型能力是故事的一半。成本结构是另一半。
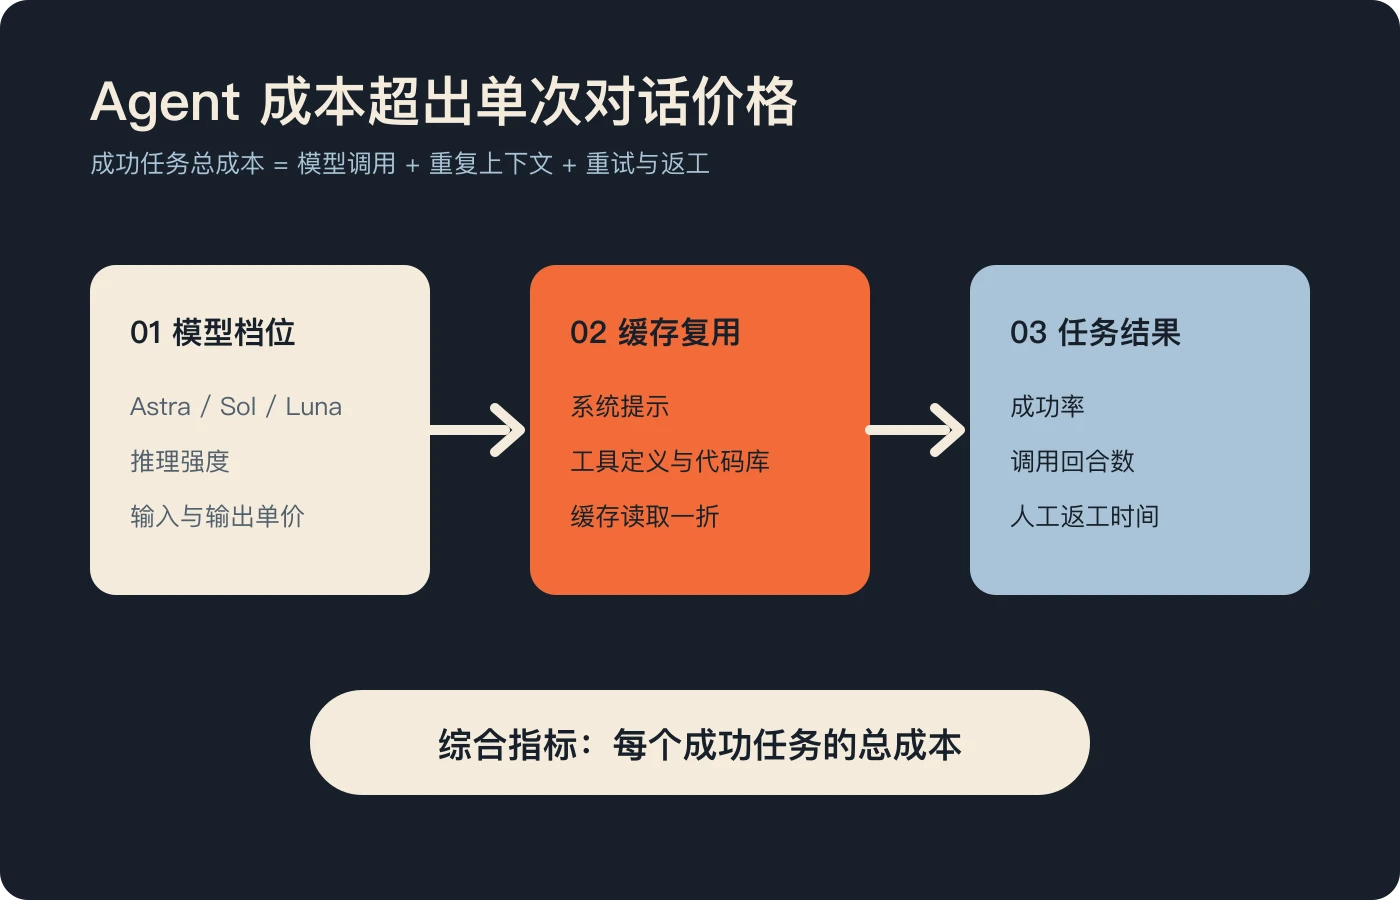
Agent 读取代码库、调用工具、检查结果、修复错误。一次任务包含多个模型回合。单次对话价格缺少完整解释力。Token 单价、缓存命中率和任务成功率是账单的三个变量。
GPT-6 Sol 与 Luna 的目标是 Agent 任务的规模化经济条件。
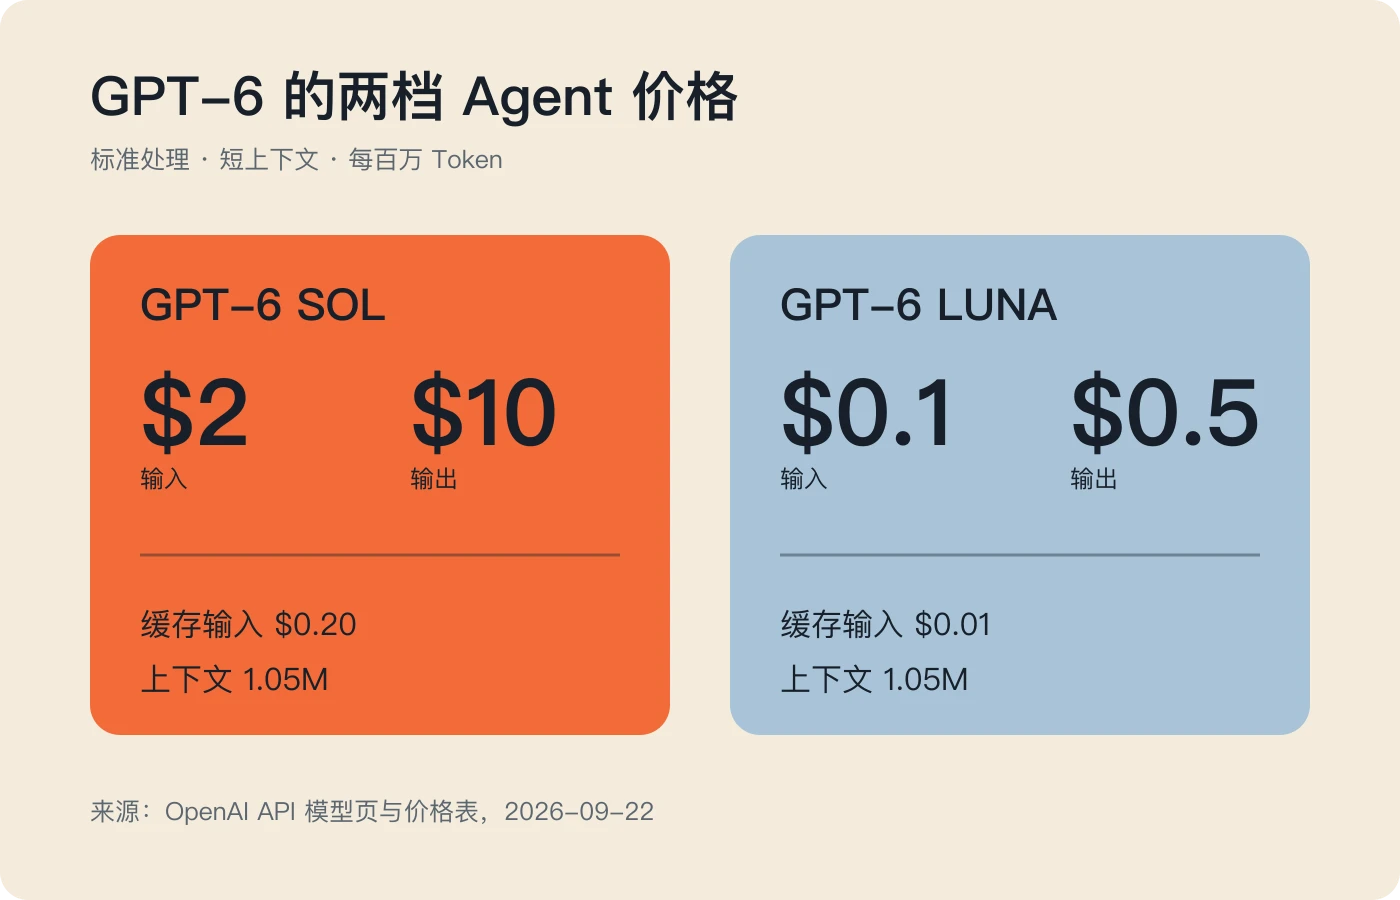
两档模型,两种预算
GPT-6 Sol 面向复杂编程与 Agent 工作流。官方模型页给出的标准价格如下:
| 项目 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| 输入 / 百万 Token | 2 美元 | 0.1 美元 |
| 缓存输入 / 百万 Token | 0.2 美元 | 0.01 美元 |
| 缓存写入 / 百万 Token | 2.5 美元 | 0.125 美元 |
| 输出 / 百万 Token | 10 美元 | 0.5 美元 |
| 上下文窗口 | 105 万 Token | 105 万 Token |
| 最大输出 | 12.8 万 Token | 12.8 万 Token |
两档模型的价格比例接近 20 倍。产品分工超出“强模型”和“弱模型”的简单切割。
Sol 承担高价值决策、复杂代码修改和长链路操作。Luna 承担分类、抽取、路由、检查和批量处理。Agent 系统把任务拆成不同层级。模型选择成为系统设计的一部分。
价格表含有一个限制。272K 输入 Token 构成长上下文计费分界线。272K 以上输入请求采用另一档价格。Sol 的长上下文输入价格是 4 美元,输出价格是 15 美元;Luna 的对应价格是 0.2 美元与 0.75 美元。
百万上下文与百万 Token 固定低价属于两个概念。
缓存改变 Agent 账单
代码 Agent 的输入具有大量重复内容。多个请求共享系统提示、工具定义、仓库说明、代码文件和对话前缀。
GPT-6 的缓存读取价格是普通输入价格的十分之一。OpenAI 调整了缓存规则。推理强度变更与工具开关变更保留前缀缓存。开发者设置缓存断点。
这项改动贴近 Agent 的工程现实。
一个长任务包含十次模型调用。八次调用复用大段上下文。缓存命中率决定重复输入成本。缓存失效吞掉模型降价收益。
GitHub 数据报告称,相关缓存改进令 Copilot 的新处理提示 Token 占比下降超过 50%。合作方报告是这个数字的来源,独立审计结果缺席。
官方评测给出的能力边界
OpenAI 公布了几组 Agent 评测。
AutomationBench 覆盖销售、营销、运营、客服、财务和人力资源流程。GPT-6 Sol 的 xhigh 档得分是 33.2%,单任务成本是 0.27 美元。Claude Opus 5 的 max 档得分是 26.9%,成本倍数是 11.1。
DeepSWE 1.1 使用真实代码库的长程软件工程任务。GPT-6 Sol 的 max 档得分是 68.8%,Claude Fable 5 的 xhigh 档得分是 69.9%。OpenAI 给出的 Sol 单任务成本差距为 80%。GPT-6 Luna 的 max 档得分是 66.6%。
OSWorld 2.0 测试计算机操作。Sol 的 xhigh 档得分是 60.5%,Claude Opus 5 的 medium 档得分是 60.3%。OpenAI 给出的成本差距为 80%。
OpenAI 发布材料是这些数字的来源。评测环境、系统提示、工具配置与生产版本存在差异。公开报告是竞争模型数据的来源。第三方复现结果是必要补充。
一个有限结论成立:Sol 的官方数据展示了能力与成本的组合优势。“Sol 胜过 Claude 各项能力”的结论缺乏支撑。
模型选择表
GPT-6 Astra 适合失败成本高、推理难度高的任务。GPT-6 Sol 适合主力编程 Agent、跨应用流程和复杂工具调用。GPT-6 Luna 适合大批量子任务与低成本检查环节。
企业选型指标包含任务成功率、单任务 Token、缓存命中率、人工返工时间。
单项 Benchmark 缺少业务代表性。便宜模型的重试次数改变成本。昂贵模型的高成功率缩短任务链。综合指标是“每个成功任务的总成本”。
可用范围
Plus、Pro、Business、Enterprise 与 Edu 用户拥有 ChatGPT Work 和 Codex 使用资格。Free 与 Go 用户拥有桌面端 Luna 使用资格。普通 Chat 界面的模型入口缺席。
API 模型名是 gpt-6-sol 与 gpt-6-luna。两者支持 Responses API、Chat Completions、函数调用、结构化输出、Web Search、File Search、Hosted Shell、Computer Use 和 MCP。
Chat Completions 的函数调用存在条件:reasoning_effort 的值是 none。复杂工具工作流适合 Responses API。
Agent 竞争的新单位
模型发布的旧单位是 Benchmark 分数。Agent 市场增加了三个单位:单任务成本、缓存复用率和成功任务吞吐量。
GPT-6 Sol 与 Luna 把竞争焦点推向工程账本。0.1 美元的 Luna 是 Agent 流水线的低价执行层。2 美元的 Sol 占据主力档位。Astra 保留高难任务位置。
这套分层给开发团队带来一个新问题:模型选型由全局配置转向节点配置。每个任务节点包含模型、推理强度和缓存策略。
大规模 Agent 系统是这轮价格战的核心客户。
