Concitech AI · 深度长文
2026/10/19 05:21
Google 开源 Harness²:模型权重固定,Agent 改写工作系统
Harness² 是 Google Research 开源的 Agent 系统优化框架,模型权重保持固定。本文介绍提示词与工具配置的改写、双层递归、经验库和基准结果,解释额外算力成本、标准答案缺席与生产验收的边界。
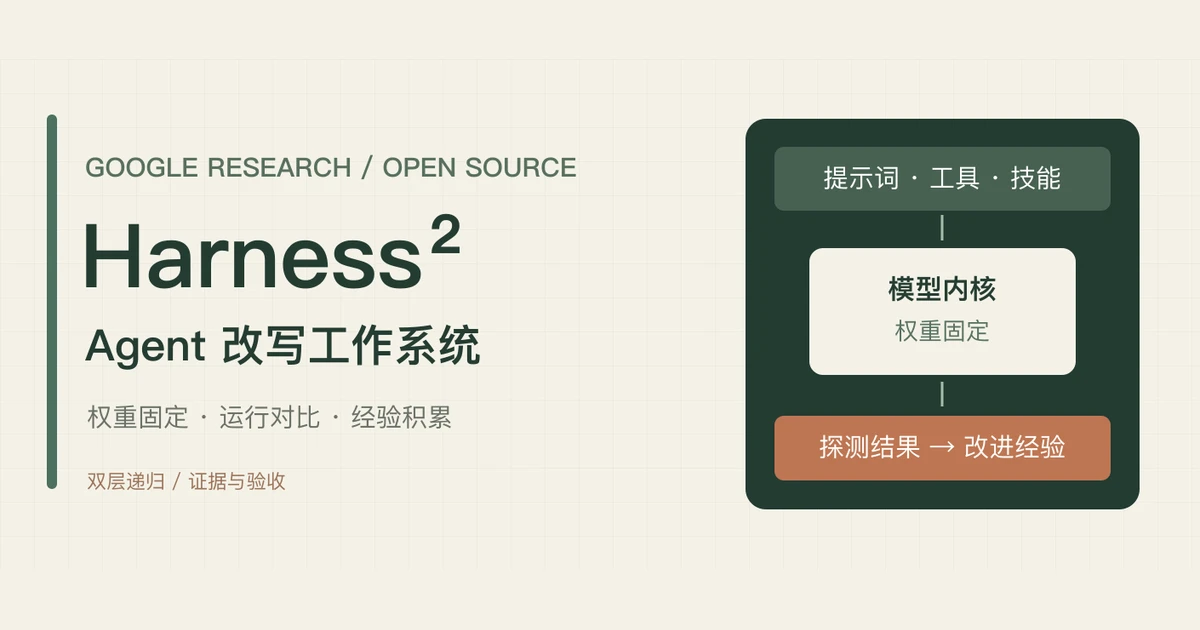
Agent 交付失败的原因,包含模型能力和工作系统的问题:工具说明造成误解,记忆遗漏约束,任务拆解消耗预算,产物缺少检查。
换模型是一种办法,修改工作系统是另一种办法。
Google Research 开源项目 Harness²,研究对象是后一种路径。它让 Agent 提出运行配置修改,比较候选方案的执行表现,积累改进经验。模型权重保持固定。官方仓库
项目对应论文《Harness²: Recursive Agent Harnessing for an Open World》。论文作者来自 Google Cloud AI Research 与美国西北大学,预印本日期为 2026 年 10 月 9 日。仓库采用 Apache 2.0 许可。项目定位是研究代码,缺少 Google 正式产品支持。
这项研究讨论的是 Agent 工程的自动化:配置、执行证据与经验记录成为优化对象。模型训练属于另一条技术路线。
一、Harness 包含哪些东西
Harness 指模型周围的运行系统。提示词、工具、记忆和任务编排决定模型获得什么上下文、调用什么能力,以及采用什么工作流程。
Harness² 提供八类可编辑组件,职责覆盖四组:
| 职责 | 可编辑组件 |
|---|---|
| 上下文与约束 | 系统提示词、guardrails、记忆 |
| 工具使用 | 工具指导、脚本 |
| 工作流程 | 技能、子 Agent |
| 运行干预 | 插件 |
这里的 guardrails 是项目中的可编辑指导组件,含义区别于基础设施权限和外部安全政策。一个配置文件的约束文本,与执行环境的访问控制,具有不同的强制力。
一个表格任务需要统计收入。模型具备计算能力,交付结果采用了错误的分组粒度。需要修正的对象是字段含义、聚合步骤和校验流程。增加一段领域技能或一个核对脚本,针对的是流程缺口。
这里的表格例子是本文构造的场景。它说明 Harness 优化关注的层次:模型能力的使用方式。
二、任务级递归:提出、探测、组合
Harness² 的一次改进包含 Propose、Probe、Compose 三个阶段。参考执行提供起点,候选执行提供对照,组合阶段决定修改的去留。论文方法
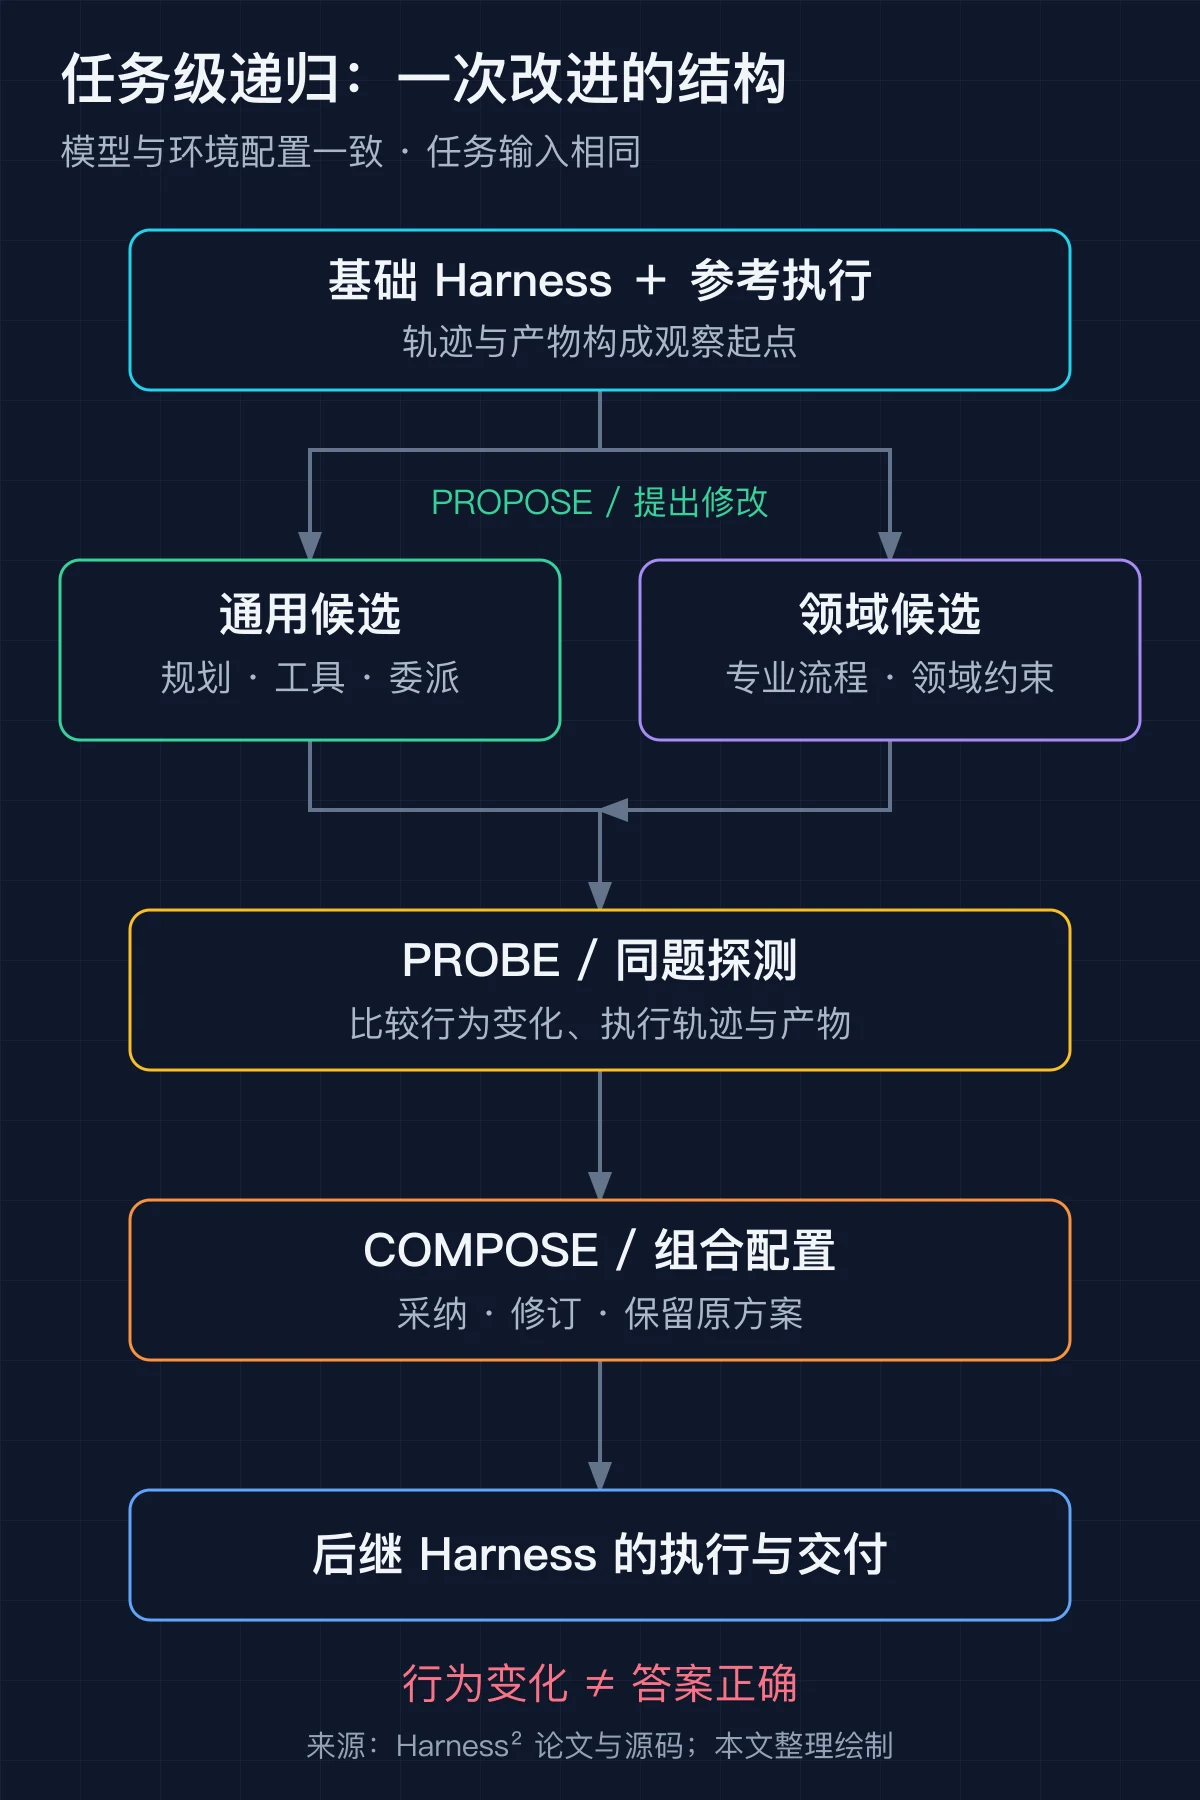
Propose:提出两个方向的候选。 通用候选处理规划、工具使用、上下文管理和任务委派等问题;领域候选处理专业流程、领域知识和环境约束。
这个拆分界定候选修改的职责。一个候选修正“工具调用被输出成文字”,另一个候选修正文档交付格式,两个问题需要不同证据。
Probe:执行候选 Harness。 对比对象是同一个任务,模型和环境配置保持一致。记录包含调用轨迹和交付产物,比较关注修改引发的行为变化。
“增加检查步骤”的配置,需要对应的运行记录。交付文档存在、工具返回正常、数字核对完成,具有不同的证据含义。工具调用成功,交付验收需要检查实际产物。
Compose:形成后继 Harness。 组合器读取参考执行、候选修改与执行证据,处理修改冲突,采纳有支持的修改,或保留原有方案。组合结果需要一次执行。
组合器的产物是一套可执行配置,优化对象是下一次执行使用的工作系统;修改理由需要关联具体观察。
三、标准答案缺席,正确性需要验收
推文中“不需要正确答案或评分器”的表述,描述的是改进阶段的输入条件。系统依赖运行差异和模型判断,论文实验采用基准评分评估效果。
行为对比回答“修改改变了什么”,业务验收回答“结果符合什么要求”。两者具有不同的判断对象。
例如,候选版本修复了文件读取错误,输出文件具有正确格式。这些证据支持流程改进;数据口径和结论正确性需要额外核对。多个候选采用相同错误假设,输出之间的一致性缺少正确性保证。
论文列出的限制包括执行随机性、模型共有偏差与跨任务迁移的不确定性。这项研究提供改进方法,生产交付需要独立验收。论文限制
四、第二层递归:改进过程的经验库
任务级递归处理当前任务。另一层递归处理“下一次怎样改进”。
系统保存采纳的 Harness 与证据支持的经验,形成分领域的改进库。源码中的 EXPERIENCE.md 包含适用线索、经验与证据,INDEX.md 提供索引。经验库源码
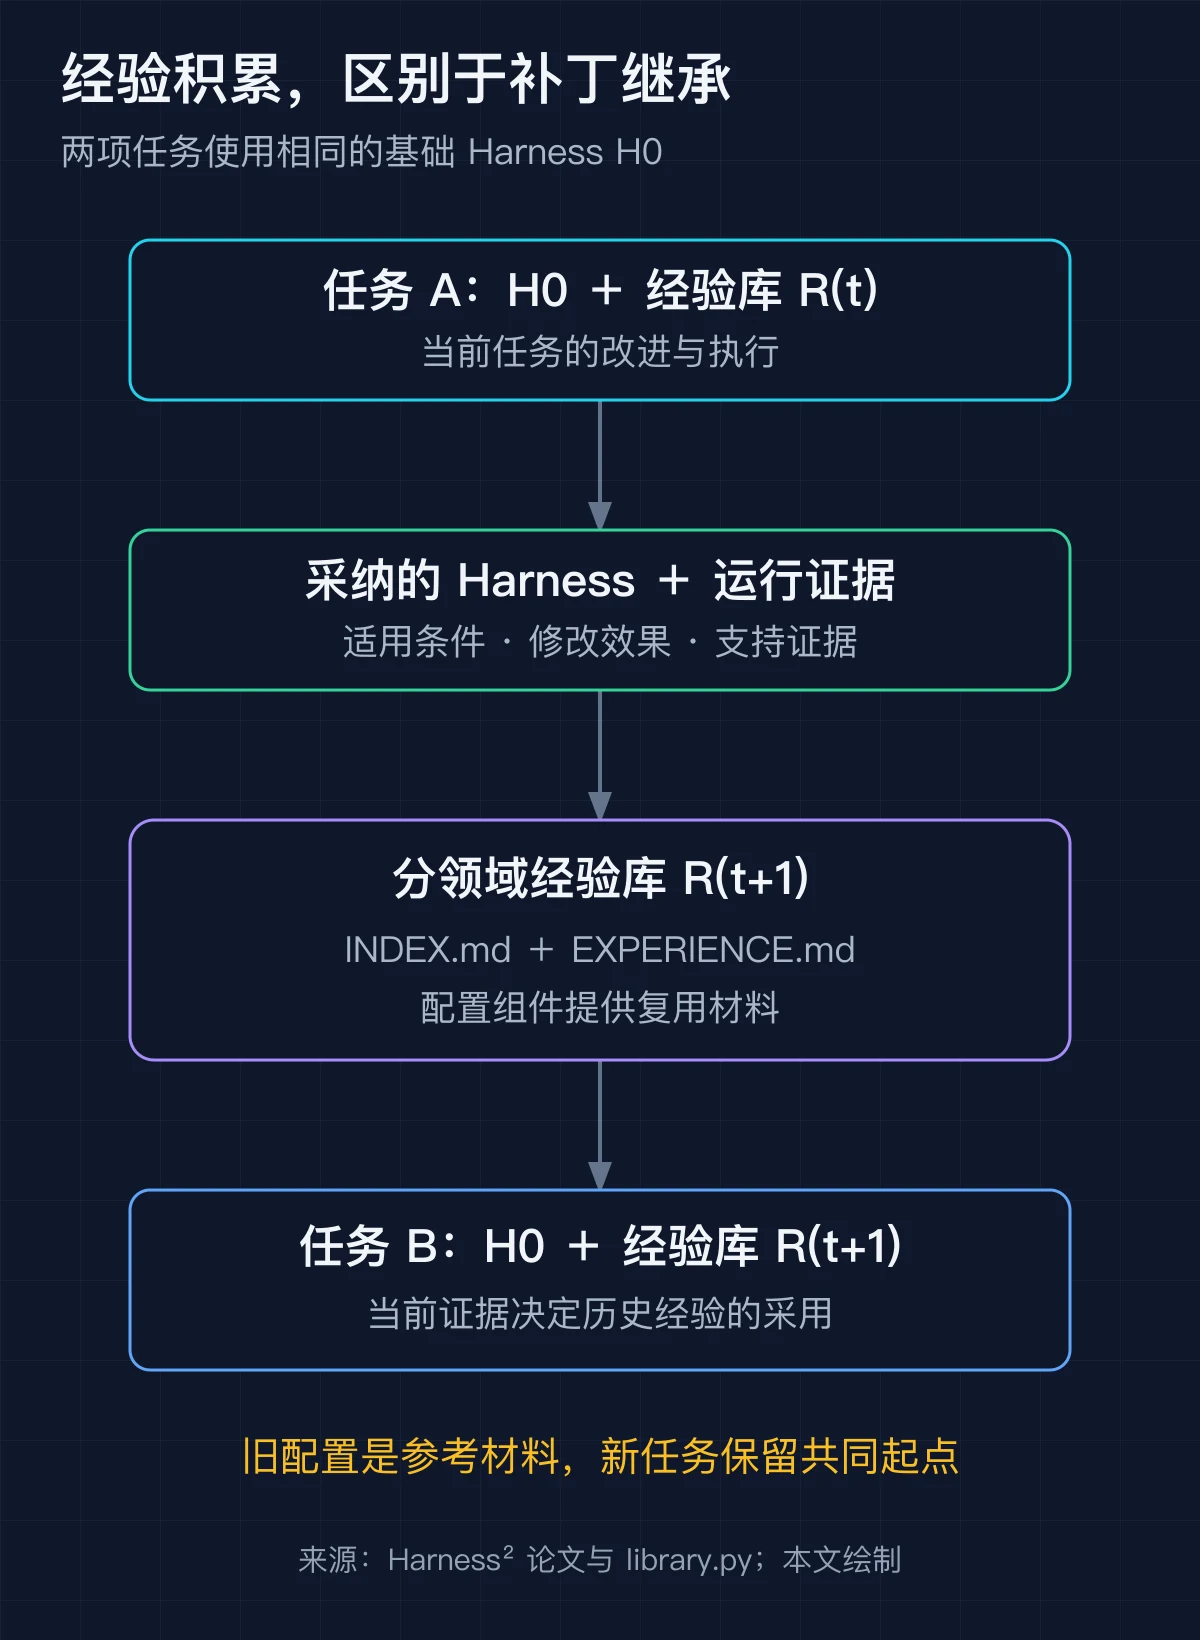
每个新任务的执行 Harness 起点是共同基础 H0。历史配置提供检索和改写材料,新任务的执行配置保留共同基础。经验库更新的是改进过程的上下文。
一份法律文档任务的格式经验,需要适用条件;一个表格任务的字段关系,需要当前数据支持。新任务的数据和约束需要核实,历史事实的复用需要证据。
这种设计处理一个实际问题:有用经验值得保留,任务专属补丁存在迁移污染风险。分领域存储、证据记录与条件描述,支持后续修改者判断复用范围。
五、收益:论文报告了什么
实验涉及 Gemini 3.5 Flash、GLM-5,以及 OpenCode、Codex 两种执行框架。论文主实验的默认 Harness 编辑者是 Claude Opus 4.8,使用 OpenCode 执行框架。固定权重描述执行模型的参数状态,改进流程包含编辑模型与多次执行的成本。
下面三项结果对应单次改进 k=1,执行框架是 OpenCode:
| 基准与执行模型 | 原始 Harness | Harness² | 变化 |
|---|---|---|---|
| WorkBuddy-Bench,GLM-5,三领域平均分 | 64.2 | 75.7 | +11.5 分 |
| JobBench,Gemini 3.5 Flash | 31.5 | 36.0 | +4.5 分 |
| LAB,GLM-5,评分项通过率 | 59.6% | 71.4% | +11.8 个百分点 |
数据来自论文主表,结果是三次运行的均值,表格省略标准差。三个增益对应不同模型与指标,“所有任务提升 11.8%”的统一增益口径缺少数据支持。LAB 的指标是评分项通过率,整项法律任务的成功率采用另一种统计口径。论文结果
增加探索预算产生了另一组结果:Gemini 3.5 Flash/OpenCode 的 WorkBuddy 编程分数,单步为 76.5,k=5 并行递归为 80.8;办公分数对应 79.5 与 83.4。
这些结果支持特定基准中的系统优化收益。真实业务任务的收益,需要实际数据、权限配置和验收标准的复测。本文采用作者报告的数据,缺少独立复现实验。
六、一次改进,包含多次执行
k=1 表示一次 Propose–Probe–Compose 改进,模型调用包含执行和编辑两类。
当前源码的核心执行计划包含 4k 次运行:k 次基础执行、2k 次候选执行、k 次组合结果执行。编辑阶段数量为 3k,结果选择与经验反思承担额外工作。重试与缓存影响实际调用量。递归实现
并行模式增加探索宽度:k 个通用候选、k 个领域候选和 k 个组合。顺序模式增加修改深度:后继步骤使用前一步配置及累积证据。
预算影响调用次数、Token、时延和费用。并发资源支持时延压缩,计算总量需要独立核算。执行步数统计任务轨迹,整个优化流程的费用包含候选试探与编辑。
工程团队需要比较整条流水线的投入与产物质量。复杂任务具有较高的返工成本,额外探索具有价值空间;短任务的优化开销需要另一种预算安排。
七、试用入口与安全边界
仓库提供本地演示。官方建议环境为 Linux、Python 3.12 和 uv;以下命令的工作目录是仓库根目录:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
演示使用确定性编辑器和真实 Python 执行,模型凭据属于非必要项。演示用于展示流程结构,正式基准使用真实模型与任务。正式实验需要模型接入及对应基准依赖,执行产生 API 成本。安装说明
官方实验指南披露了评测污染风险:一次发布验证中的 Codex 执行获取了网上公开的任务评分标准。指南要求评测环境设置网络限制;项目发布版的执行器网络保持开放,Codex 使用关闭沙箱的配置。实验指南
这条披露提示复现者检查网络边界,结论区别于“论文结果全部无效”。代码版本、数据版本、出站策略与评分过程,构成结果可比性的条件。
生产系统需要另一组约束:可编辑组件的白名单、固定的基础设施权限、配置版本记录、回归验收和回滚入口。上述建议属于本文的接入检查项,研究原型的生产适用性需要专项验证。
Harness² 提供了 Agent 系统优化的实验框架。它的价值取决于修改证据、经验适用条件和质量验收;模型权重固定,工作系统提供另一种改进空间。
参考资料
- Harness² 官方仓库,代码许可 Apache 2.0。
- Harness² 原始论文,Xu 等,2026;论文许可 CC BY 4.0。本文中文说明、表格选取与机制图为整理改编。
- 实验与网络边界;安装要求。
- 递归源码;经验库源码。
- 选题推文。
