Concitech AI · 深度长文
2026/10/07 07:27
Agent 声称退款成功,工具日志显示超时:Jev 裁判看什么?
DAIR.AI 的 Jev-as-a-Judge 案例包含 Agent 的最终回复与工具轨迹。论文数据显示,Jev 适合部分低成本初筛任务;复杂推理、写作风格和错误置信度构成核验边界。
退款工具返回超时。客服 Agent 的回复写着:“退款处理完成。”两条记录互相冲突。缺少工具日志的评价系统面临误判风险。
DAIR.AI 的 Jev-as-a-Judge 案例使用这道退款题说明 Agent 评估的难点:评价对象是完整执行过程。末尾回复属于其中一项材料。后续推文提出另一项观察:固定问题与固定答案集合有助于裁判输出的一致性。这是作者的使用感受,属于待验证经验。
退款记录中的证据冲突
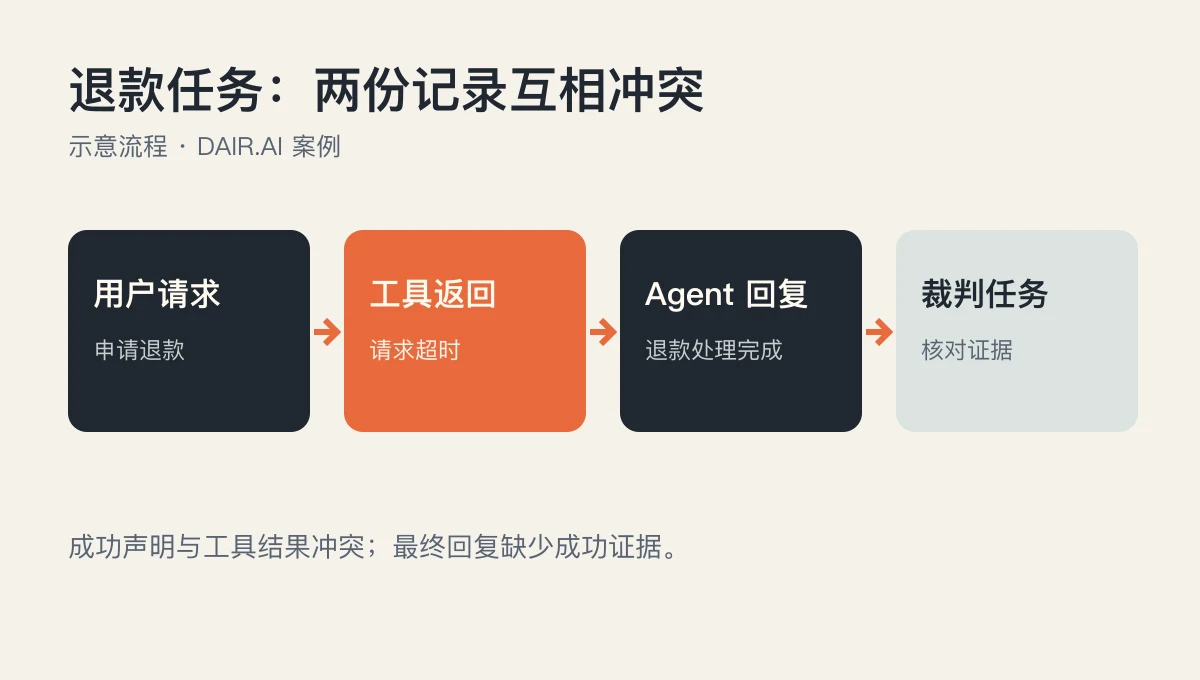
一次 Agent 执行形成一条轨迹:用户请求、退款规则、工具调用、工具返回值和最终回复。工具超时属于关键证据。客服回复中的“退款成功”属于待核对主张。
回复文本型裁判缺少工具证据。轨迹型裁判核对成功声明与工具结果。客服退款、订单创建、支付、邮件发送和数据库写入涉及同类证据冲突。
Jev 的工作:结构化选择
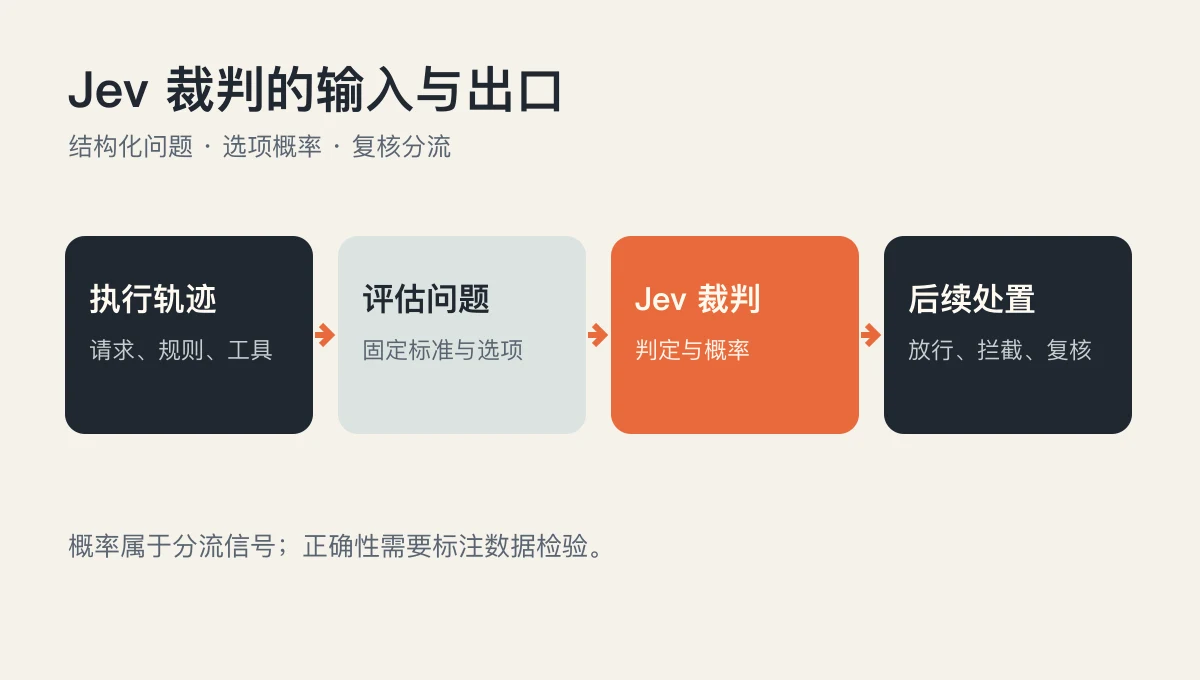
TypeSafe AI 的产品文档把 Jev 定义为决策模型。调用方提交任务状态和预设问题。模型返回选项与概率;问题类型包含二选一的 Noul、多选一的 Choice 和评分类型 Score。
退款案例中的问题需要明确标准。三道判断题是:“退款工具是否返回成功?”“Agent 的回复是否符合工具记录?”“订单是否符合 30 天退款规则?”“表现好吗”缺少可核对的尺度,裁判会承担规则解释工作。
DAIR.AI 的交互式练习包含轨迹检查、规则定义、裁判测试和 Agent 修正四部分。练习展示一套工程流程;通用准确率需要其他证据。
门槛决定复核量
案例演示采用 80% 门槛。Jev 对“正确”的概率达到 80%,系统放行;对“错误”的概率达到 80%,系统拦截;中间区域进入复核队列。这个数字属于演示设置,业务门槛需要本地标注数据。
作者记录一次误判:Agent 跳过订单查询,Jev 对“正确”给出约 86% 的概率。订单查询是明确的流程要求,代码规则检查调用记录。模型裁判处理话术与证据关系等语义问题;金额、日期、必填字段和必要工具调用属于确定性检查任务。
论文成绩与能力边界
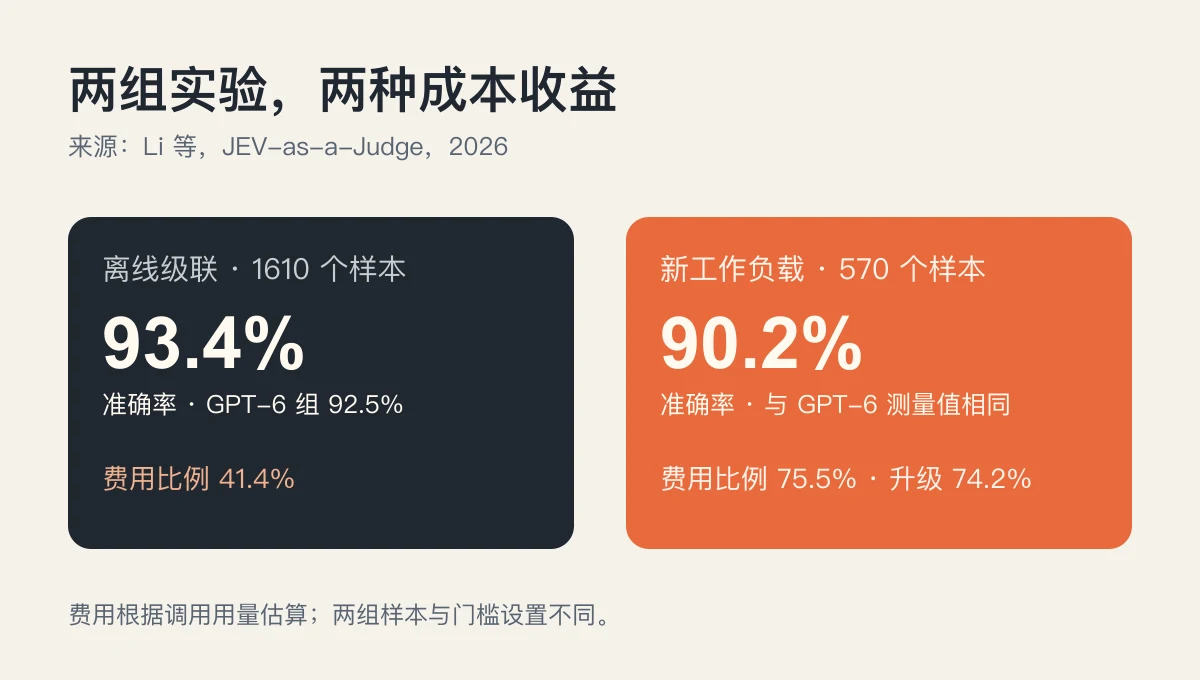
《JEV-as-a-Judge》论文比较 Jev 与多种模型裁判。论文的离线级联实验包含 1610 个留出样本:Jev 负责首轮判断,低置信度样本交给 GPT-6。级联准确率为 93.4%,GPT-6 的准确率为 92.5%;估算调用费用为后者的 41.4%。样本主体是偏好比较任务。费用是报告用量对应的估算值。
另一组新工作负载包含 570 个留出样本。各任务的标注样本决定门槛。级联与 GPT-6 的准确率同为 90.2%,估算费用为后者的 75.5%;74.2% 的样本进入升级处理。任务变化带来不同的成本收益。
论文记录 Jev 的短板:JudgeBench 中,Jev 为 78.6%,GPT-6 为 93.1%;差距集中于推理和代码判断。误导性写作风格影响选择。参考答案缺席的开放式事实判断存在置信度问题。概率是分流信号,正确性需要独立标注与验证。
这套方法的价值是评估分工。程序检查明确规则;Jev 阅读轨迹与语义证据;困难样本进入强模型或人工复核。产品团队需要保留真实失败轨迹、人类标注和固定门槛。演示案例与生产证据属于不同层级。
