Concitech AI · 深度长文
2026/10/12 05:40
卡神的 AI 认知漏斗:有人看见聊天框,有人看见工程队
卡帕西提出四层 AI 认知漏斗:低接触人群、聊天产品用户、技术专业用户和内部系统使用者。人数属于作者的粗略估计。本文解释任务规模、可验证反馈与访问权限造成的体验差异,讨论工程验收和生产率测量的边界。
一个人说,AI 是个有出错记录的聊天机器人。另一个人说,AI 改变了自己的工作方式。
两个人的经验存在差异。他们接触的系统、交付的任务、结果的验收方式存在差异。
卡帕西的一条新推文讨论了这件事。他引用自己的四月旧帖,提出一个新描述:AI 能力的认知分布形成了一个漏斗。推文的北京时间是 2026 年 10 月 12 日。
他关注的矛盾是:同一个技术时代包含数种体验。聊天框里的失误和技术工作里的突破,构成了人们关于 AI 的不同证据。卡帕西的本次推文
这个漏斗的价值是解释体验差异。它的人数需要一个醒目的标注:卡帕西的粗略估计。
原帖使用了 “napkin math” 这个说法,意思是草算。原帖缺少人口抽样、用户去重和统计方法。下面的人数属于作者的估算,区别于全球采用率调查结果。
一、四层漏斗,四种 AI 经验
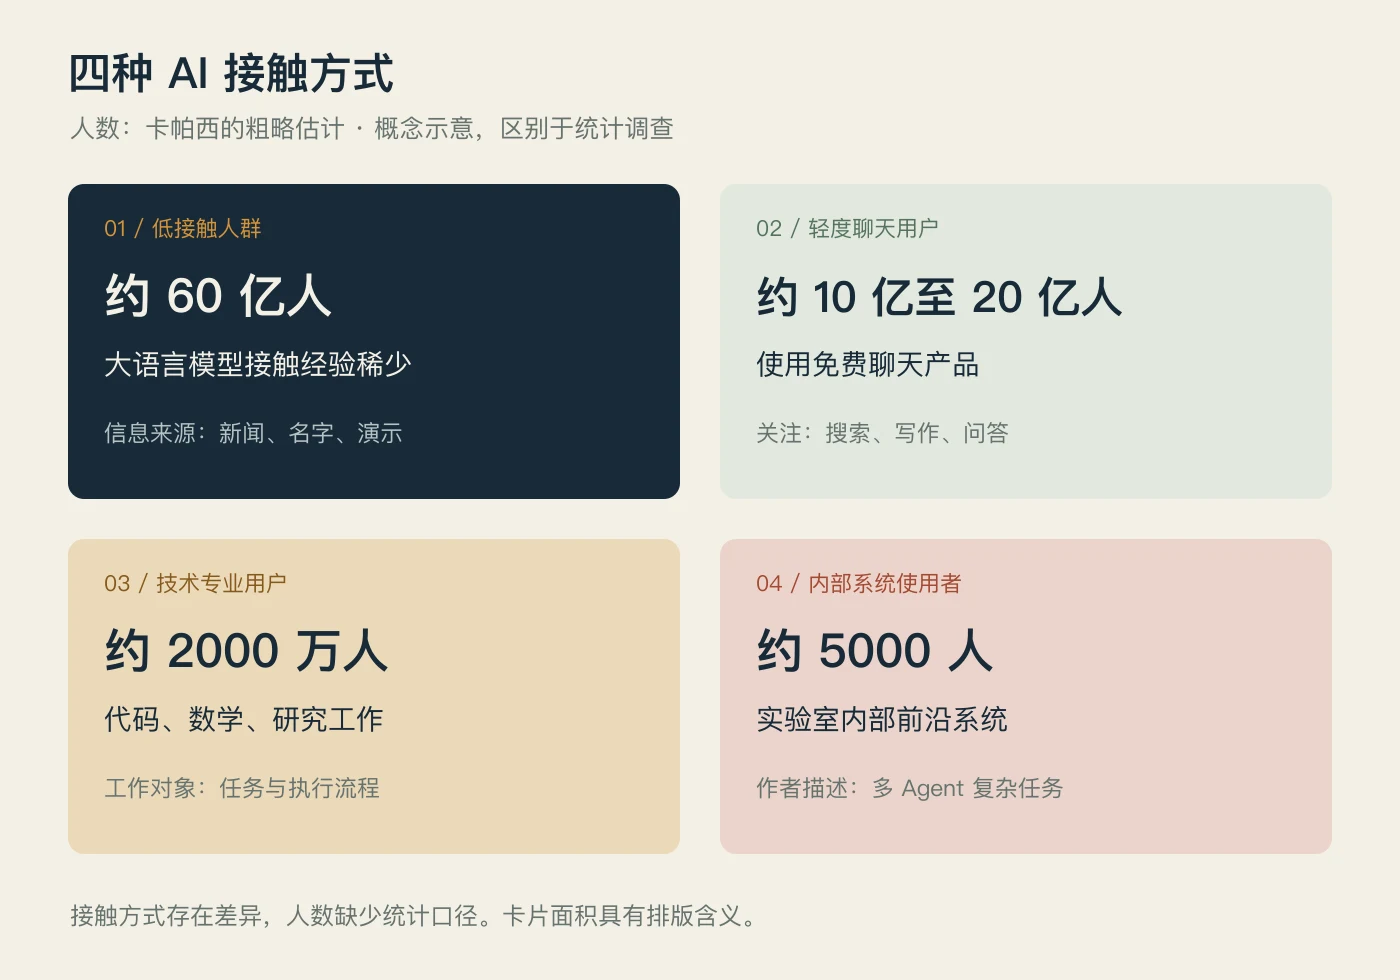
低接触人群:约 60 亿人
这一层的特征是大语言模型接触经验稀少。AI 新闻、聊天产品的名字、社交媒体的演示,构成他们的信息来源。
知道一个产品,与拥有一个产品的使用经验,是两件事。一个人关于 AI 的判断,涉及自己的工作需求、可用设备和语言环境。漏斗的宽度包含这些接触条件。
轻度聊天用户:约 10 亿至 20 亿人
这一层使用免费聊天产品,主要用途包括搜索辅助、写作和问答。
他们关注回答的准确性、表达质量和便利程度。一次胡编的答案、一次常识失误,构成产品质量的具体证据。
卡帕西承认,一些非技术朋友认为 AI 的用途有限。他认为这种判断有其合理性。一个人的主要工作是沟通、协调或建立信任,聊天框的帮助有自己的边界。文字产量与工作价值是不同指标。
技术专业用户:约 2000 万人
这一层使用前沿模型,工作对象包括代码、数学和研究问题。
卡帕西描述的变化涉及完整任务:应用开发、应用迁移、代码理解,以及复杂项目的执行。代码补全提供一段文字,Agent 接触文件、工具和测试,执行一个工作流程。
这是卡帕西的观察。它缺少统一项目样本和成功率定义。一个演示的成功,与各类商业项目的交付能力,存在证据距离。
开发者关心的对象有一个明确变化:AI 的产物包含代码改动、运行记录和测试结果。它的价值涉及项目进度,超出了聊天答案的质量。
内部系统使用者:约 5000 人
这一层接触实验室内部的前沿系统。
卡帕西描述了多 Agent 协作、复杂软件工程和研究探索。他的担忧是人类审查与理解的速度:系统产生的工作量增加,核查者承担的工作量增加。
这些描述属于作者关于内部前沿能力的观察。原帖缺少完整实验设置和逐项验收材料。公众产品的可用功能、独立验证的结果和内部系统的能力描述,需要各自的证据。
这四层具有概念示意性质。作者缺少互斥分组和去重口径,人数之和缺乏总体统计含义。它们解释的是接触方式,区别于人的智力等级或职业价值排名。
二、造成差异的,是任务、领域和权限
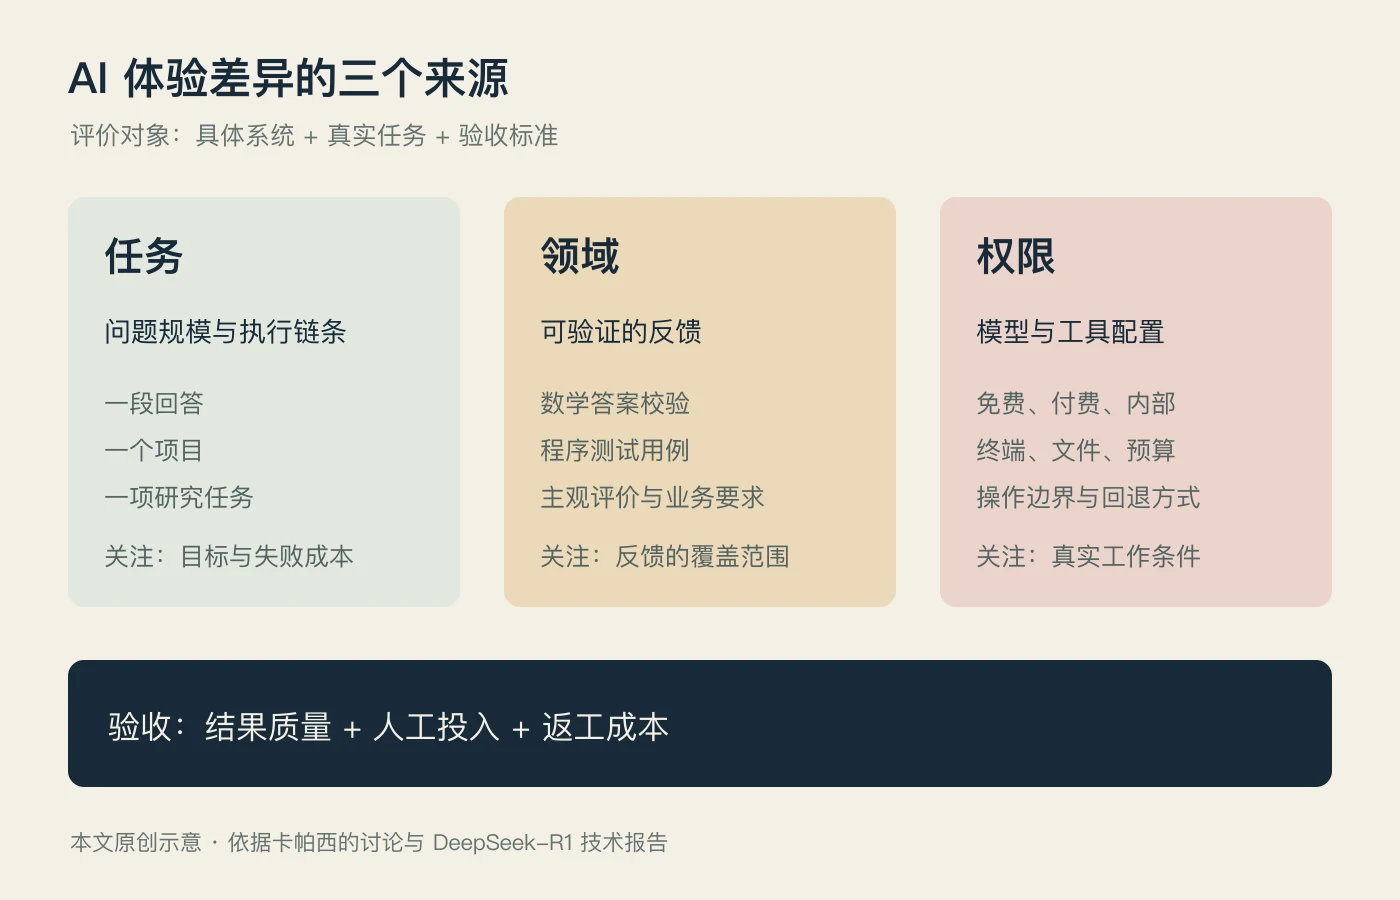
卡帕西提出了三个因素。我认为,它们适合解释“同一个模型”的不同使用结果。
任务规模决定了系统需要承担什么。
“写一段介绍”需要一段输出。“修复一个项目的问题”需要理解文件、寻找原因、修改实现和检查结果。前者考察回答质量,后者考察执行链条。任务中的工具、环境和验收步骤,改变了能力表现的空间。
大任务具有价值放大的机会,具有失败累积的风险。一次错误的文件改动产生后续影响;缺少边界的需求扩大无效工作。卡帕西强调的问题规模,包含了机会;工程实践需要考虑失败成本。
领域反馈决定了训练与验收的条件。
数学题的确定答案、程序的测试用例,提供了明确的反馈。DeepSeek-R1 的技术报告介绍了规则奖励:确定结果的数学问题使用答案校验,编程问题使用预设测试用例提供反馈。这是可验证奖励的一项具体技术例子。DeepSeek-R1 技术报告,奖励建模部分
一篇文章的好坏涉及品味、读者和表达目标。一次商务沟通的成败涉及关系、利益和执行。这些任务的评价标准包含主观性和环境差异,训练信号与代码测试的信号存在区别。
卡帕西认为,商业回报影响了模型公司的训练重点。这是他的产业判断。一个技术报告能够证明某种奖励机制的存在;各家公司的资源分配需要各家的证据。两者具有不同的证明范围。
系统访问决定了使用者接触什么。
模型版本、工具配置、运行预算和权限边界,影响任务的结果。一个聊天界面与一个拥有终端、项目文件和测试环境的 Agent,具有不同的工作条件。
付费层级属于访问条件之一。费用与生产率之间缺少自动等号。用户的任务、配置和验收方法需要检验。内部系统的演示能力与公开产品的日常可靠性,涉及不同的评估对象。
三、能力的参差,解释了争论的错位
卡帕西使用了 “jaggedness” 这个概念。中文里的“参差”适合描述它:AI 的能力轮廓存在高峰和低谷。
一个系统解决了复杂代码问题,回答错了一个常识问题。这两项结果评价了不同能力。简单问题的失败,证明该问题的可靠性不足;复杂问题的成功,证明该任务的某次执行成功。两项结果之间缺少全局替代关系。
讨论的困难来自评价对象的省略。
“AI 价值有限”省略了模型、任务和失败条件。“AI 改变了一切”省略了成功率、人工投入和适用范围。漏斗帮助我们找回这些变量。
一次有效的交流需要一个共同对象:某个版本的系统、某项任务、某种预算、某个验收标准。聊天下一句漂亮回答,与代码仓库的一次可接受改动,属于不同结果。
代码测试提供反馈,测试覆盖率决定反馈的范围。测试通过证明了测试用例覆盖的行为,业务需求、安全性和长期维护需要各自的检查。可验证领域具有明确的优势,具有明确的验证边界。
四、生产率证据,需要处理测量问题
卡帕西的观察有解释力。生产率的判断需要测量。
METR 的早期实验涉及 2025 年工具、16 位有经验的开源开发者和 246 项任务。结果显示,允许 AI 的任务耗时增加了 19%。这个数字对应那次实验的工具、人员和项目,区别于 2026 年前沿 Agent 的效果结论。METR 原始研究
METR 的 2026 年 2 月更新讨论了后续测量的困难:一些开发者拒绝参与禁用 AI 的实验,一些人选择省略预期 AI 收益高的任务。研究团队认为选择效应削弱了新数据的解释力,真实收益幅度存在测量不确定性。METR 后续实验说明
这两项研究提醒我们,任务选择影响结果。一个团队选择 AI 擅长的工作,另一个团队处理熟悉仓库里的复杂维护任务,两者具有不同的效率基线。
产出数量是一个指标。可接受结果数量、审查时间、返工成本和失败损失,是另一组指标。模型生成速度的提高,缺少整个工作流程提速的必然性。
卡帕西关于审查速度的担忧,涉及这个问题。一个 Agent 生成十份方案,人类需要识别假设、检查依据和决定采用。输出的增加消耗审查者的时间,交付的质量需要责任人承担。
五、一次有价值的试验,长什么样
我认为,这条推文给普通使用者的启发,是选择一项真实任务,而非追逐漏斗尖端的身份。
任务应当有明确目标、必要材料和一个验收标准。一个开发任务的目标是修复具体错误;一个研究任务的目标是整理来源与证据;一个写作任务的目标是交付满足读者需求的文章。
试验记录四项信息:完成质量、人工投入时间、返工次数、失败原因。这些信息帮助使用者判断工具的适用范围。一次成功提供扩展试验的理由,一次失败提供调整任务和环境的依据。
团队需要规定操作权限。读文件、改文件、执行命令和提交结果,具有不同风险。审查记录和回退方式属于交付条件,区别于附加装饰。
卡帕西的漏斗描绘了一个认知差异。我关心的落点是体验的可比较性:讨论一个真实任务,展示它的结果,说明人类付出了什么。
聊天框里的回答和工程队式的执行,代表了 AI 的不同使用形态。能力争论需要任务语境,采用决策需要交付证据。
