Concitech AI · 深度长文
2026/09/08 21:16
Kimi Linear 最多砍掉 75% KV Cache:全注意力真要退场了吗?
Kimi 团队用三层 KDA 搭配一层全注意力,在百万 Token 上下文中减少最多 75% KV Cache,并报告最高 6.3 倍吞吐提升。论文最有价值的地方,不是宣布 Transformer 过时,而是给出一套更务实的混合架构。
大模型读得越多,通常记得越重。
标准 Transformer 在生成每一个新 Token 时,都要回看此前保存的 Key 和 Value。上下文从 4K 拉到 128K、再到 1M,KV Cache 会跟着增长。模型或许装得进显存,缓存却可能先把显存吃完。
Kimi 团队的论文《Kimi Linear》想改掉这笔账。论文报告称,在百万 Token 上下文中,新架构最多减少 75% KV Cache,并在特定吞吐测试下达到 6.3 倍加速;同等训练配方下,它在多数短上下文、长上下文和强化学习评测中也胜过全注意力基线。
乍看像是“线性注意力终于打败 Transformer”。论文真正做的事克制得多,也更有参考价值:
它没有抛弃全注意力,而是把全注意力从每层必备,改成每四层出现一次。
这是一篇关于取舍的论文,不是旧架构的讣告。
KV Cache 为什么会成为长上下文的账单
全注意力的强项是查找。
当模型处理新 Token 时,Query 可以与历史中每个位置的 Key 比较,再取回对应的 Value。无论某条信息藏在开头、中间还是结尾,模型理论上都有一条直接访问路径。代码仓库分析、长文档问答和多轮 Agent 轨迹都需要这种能力。
代价是,历史 Key 和 Value 要保留下来。序列越长,KV Cache 越大;预填充阶段的注意力计算还会随序列长度呈平方增长。Multi-Head Latent Attention(MLA)能压缩缓存,但没有改变“上下文继续增长,缓存也继续增长”的基本关系。
线性注意力走了另一条路:不保存所有历史 Token 的 KV,而是把历史持续写入一个固定大小的状态。生成下一个 Token 时,模型读取这块状态,不必重新扫描完整历史。
速度和内存问题缓解了,麻烦转移到了记忆质量。有限状态像一块白板:新内容不断写入,旧内容可能互相干扰。全注意力可以翻回原页,纯线性注意力更像凭压缩笔记回答问题,精确复制和远距离检索一直是它的弱项。
KDA 的办法:每个通道自己决定忘多少
Kimi Linear 的核心模块叫 Kimi Delta Attention,简称 KDA。
它在 Gated DeltaNet 的基础上做了两处调整。
一处是更细的遗忘门。Gated DeltaNet 给一个注意力头设置共同的遗忘率,KDA 让每个特征通道拥有独立遗忘率。模型可以让某些通道快速清理,让另一些通道保存更久。论文把这称为 channel-wise gating。
另一处是 delta rule。新信息进入状态前,系统会先检查当前记忆对这个 Key 会给出什么答案,再用预测误差修正状态。它不只是往白板上叠加内容,也会擦掉冲突的旧关联。
KDA 的固定状态在论文设置中是每个头一个 128×128 的矩阵,大小不随上下文长度增长。团队又为它设计了 chunkwise 并行内核,让训练阶段仍能利用矩阵乘法,而不是逐 Token 串行运行 RNN。
这些设计解决了“怎么压缩”,但没有完全解决“怎么精确翻旧账”。所以 Kimi Linear 留下了全注意力。
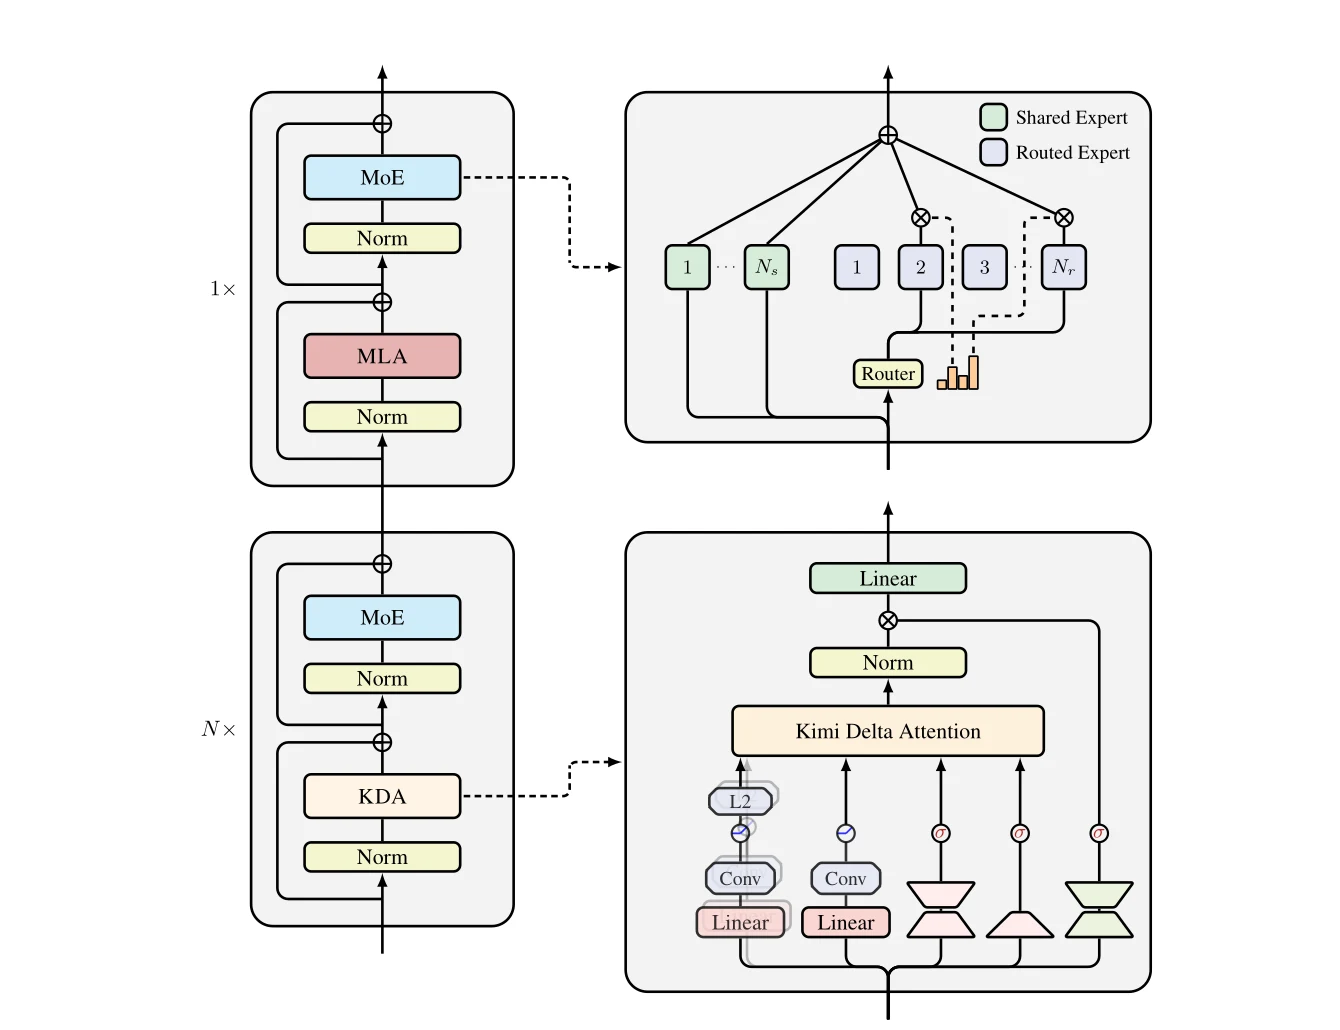
Kimi Linear 以 3 层 KDA 搭配 1 层 MLA,每层后方都是 MoE。图片来源:论文 Figure 3。
3:1,才是这篇论文最重要的数字
最终架构重复同一个节奏:三层 KDA,一层 MLA。
KDA 负责把大部分历史压进固定状态,MLA 层定期提供全局访问。按照这个比例,只有约四分之一的注意力层需要保存随上下文增长的 KV Cache,于是得到“最多减少 75%”的结果。
论文做了比例消融。3:1 的验证集困惑度是 5.65;改成 7:1 后升到 5.70,15:1 升到 5.82。线性层越多并非越好。另一端,1:1 的验证困惑度接近,却要付出更多推理开销。
这组结果说得很直白:KDA 擅长压缩,全注意力擅长检索。两者拼在一起,比要求其中一种机制包办所有任务更有效。
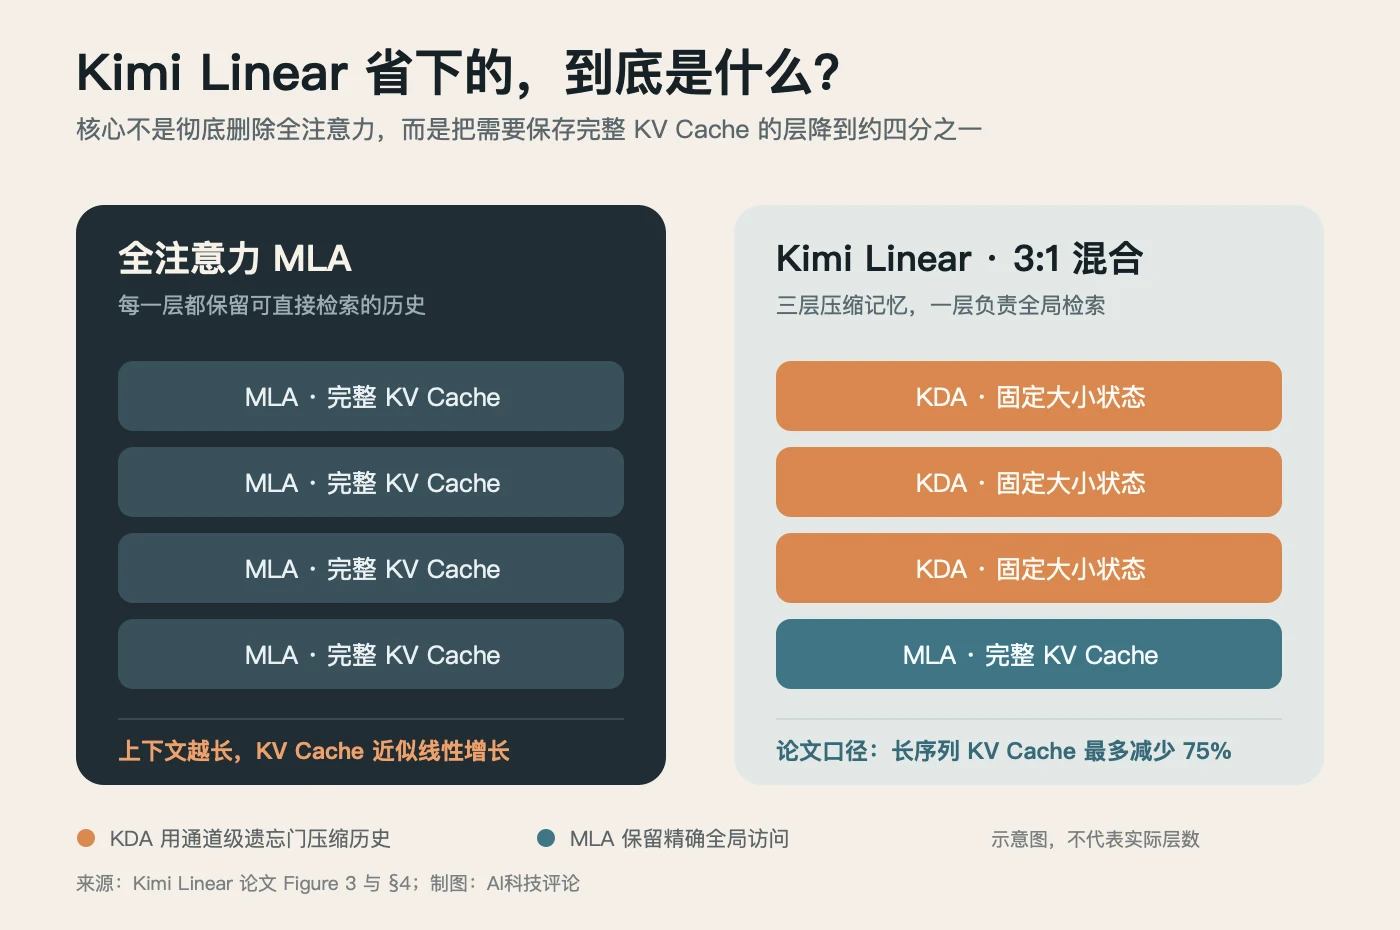
75% 是论文在长序列下的最高 KV Cache 降幅,并非所有部署环境都能固定省下四分之三总显存。
它真的超过了全注意力吗?
在论文最有可比性的实验中,Kimi Linear、全注意力 MLA 和混合 Gated DeltaNet 使用相同架构规模、训练配方与 1.4 万亿 Token 数据。三者都是 480 亿总参数、每次前向激活 30 亿参数的 MoE 模型。
Kimi Linear 的结果相当扎实。
短上下文 MMLU-Pro 上,它得到 51.0,MLA 是 47.2;128K 的 RULER 上是 84.3,MLA 是 81.3;七组长上下文评测的平均分是 54.5,MLA 是 52.2。数学强化学习阶段,论文给出的训练与测试曲线也持续高于 MLA。
但“全面超过”说得太满。Kimi Linear 在 LongBench V2、Frames 和 Long Code Arena 的部分子项上仍低于 MLA;指令微调后,它在 LiveBench、MATH500 和 EvalPlus 等评测也没有拿到最高分。更合适的结论是:在这组同配方实验里,混合线性注意力的综合表现超过了 MLA,单项结果仍有输赢。
附录中的 5.7 万亿 Token 版本则要分开看。发布模型是 480 亿总参数、30 亿激活参数,Moonlight 对照模型是 160 亿总参数、30 亿激活参数。两者训练 Token 和激活参数相同,总参数并不相同,不能把分数差全部归因于注意力架构。
“6.3 倍加速”不能脱离测试口径
这篇论文最容易被误读的是速度数字。
Figure 7 使用 batch size = 1。到 1M 上下文时,Kimi Linear 的预填充延迟约为 MLA 的 1/2.9,每个输出 Token 的时间约为 MLA 的 1/2.2。短上下文 4K 到 16K 时,差距很小;从 128K 开始,曲线才明显拉开。
摘要和 Figure 1 的 6.3 倍来自另一种吞吐口径:KV Cache 变小后,空出的显存可以放入更大的 batch,因此单位时间处理的 Token 更多。论文给出 1.84ms 对 11.48ms 的结果,但没有在正文中完整披露硬件型号和所有部署参数。
所以,6.3 倍不是“同一个请求必然快 6.3 倍”。更稳妥的阅读方式是:单请求长上下文延迟已有约 2 倍优势;当服务器把节省的显存换成更大批量时,总吞吐还有继续上升的空间。
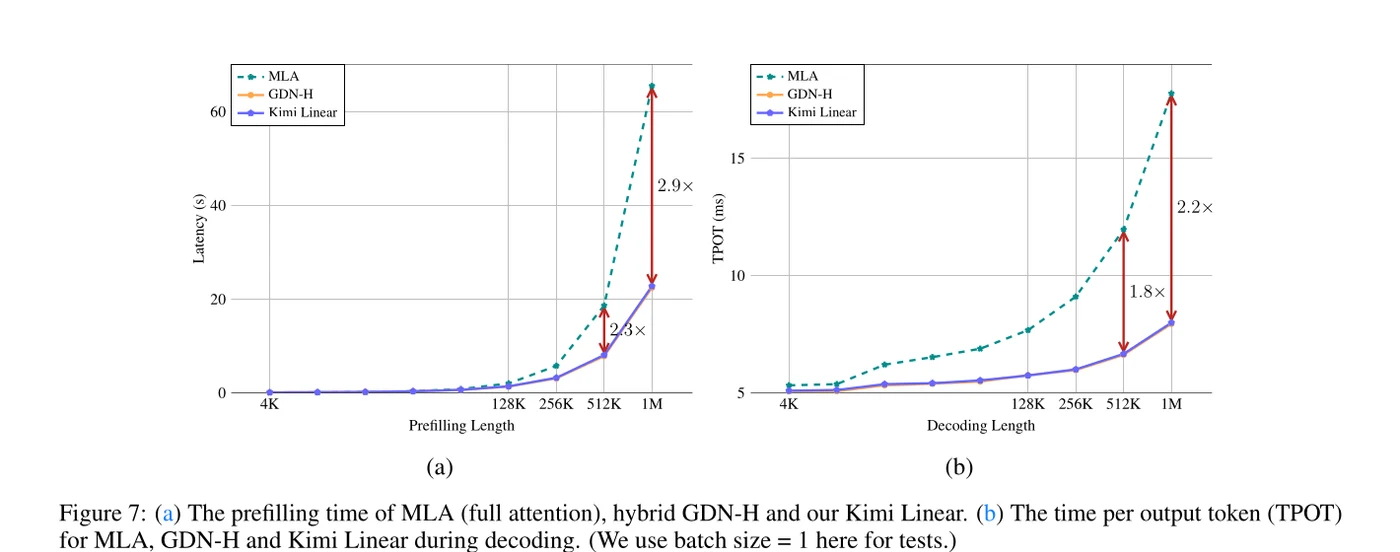
论文 Figure 7,batch size = 1。左图是预填充延迟,右图是每个输出 Token 的时间;优势主要在 128K 之后出现。
为什么 Agent 比聊天机器人更需要它
普通聊天的输入不会每次都长到百万 Token。Agent 不一样。
它会读取代码库、调用工具、保存中间结果,再把执行日志继续塞回上下文。强化学习阶段还会生成更长的推理轨迹。计算重心逐渐从“一次性读完提示词”,转向在长历史上持续解码。
此时,全注意力最昂贵的部分会反复发生。Kimi Linear 的收益也随输出长度增加:固定状态替代大部分 KV Cache,让单机容纳更长轨迹或更大 batch,而周期性的 MLA 层仍能查找原始历史。
论文已经开放 KDA 内核、vLLM 实现,以及 480 亿总参数、30 亿激活参数的 Base 和 Instruct 权重,官方模型卡标称支持 1M 上下文。这比只公布一组内部曲线更有价值,第三方至少可以检查实现并复现实验。
复现仍有两道门槛。第一,这是 Kimi 团队自己的技术报告,核心基准尚缺少跨硬件、跨框架的独立验证。第二,48B MoE 模型并不轻,真正跑到 1M 上下文需要的设备、并行策略和工程调优,不能从论文里的“30 亿激活参数”直接推算。
全注意力不会退场,但会从默认配置变成稀缺资源
Kimi Linear 没有证明纯线性注意力已经解决精确检索,也没有证明所有 Transformer 都该换掉。它证明了另一件更具体的事:在同一个大模型里,全注意力不必层层出现。
过去,注意力层像每层楼都配一座完整档案馆。KDA 把三层改成会更新的工作记忆,只在第四层保留档案馆。模型大部分时间处理摘要,需要时再重新查原文。
这套安排可能比“全注意力对线性注意力”的二选一更接近下一代架构。稀疏注意力负责挑选,线性状态负责压缩,少量全注意力负责兜底。未来的竞争点,不是谁拥有唯一正确的注意力,而是谁能把昂贵的精确检索放在最有用的位置。
Kimi Linear 已经给出一个可运行的答案:3:1。
