Concitech AI · 深度长文
2026/11/03 08:32
MIT团队让GPT改写千问权重!0.016%参数改动,数学得分变成6.1倍
MIT CSAIL 团队报告权重空间编程实验。GPT-6 Astra 编辑 Qwen3.5-0.8B 的少量权重,MATH-500 原始得分7.9%,编辑后得分48.1%。文章解释循环修复机制、实验预算、公开复跑与失败案例。
一个大模型,开始修改另一个模型的“内部线路”。
MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 发布了一组实验:GPT-6 Astra 读取、分析并修改神经网络权重,目标是识别行为、修复故障或构造网络。
一项关键实验的对象是 Qwen3.5-0.8B。作者报告:一次权重编辑覆盖的参数位置比例为 0.016%,MATH-500 原始得分 7.9%,编辑后得分 48.1%,比值的四舍五入结果为 6.1。
这些成绩属于特定实验设置。它的关键发现是重复推理循环的修复,数学能力增长的通用结论需要其他证据。
这条路径的名字是 Weight-Space Programming,权重空间编程。原始研究的发布形式是博客,日期是 2026 年 11 月 2 日;实验日志、编辑补丁和模型检查点构成公开材料。研究原文
一、权重,成了模型的编辑对象
神经网络的权重是一组数值,数值及其连接结构决定模型的信息处理方式。训练过程的常见做法,是误差计算、梯度求解和优化器更新。
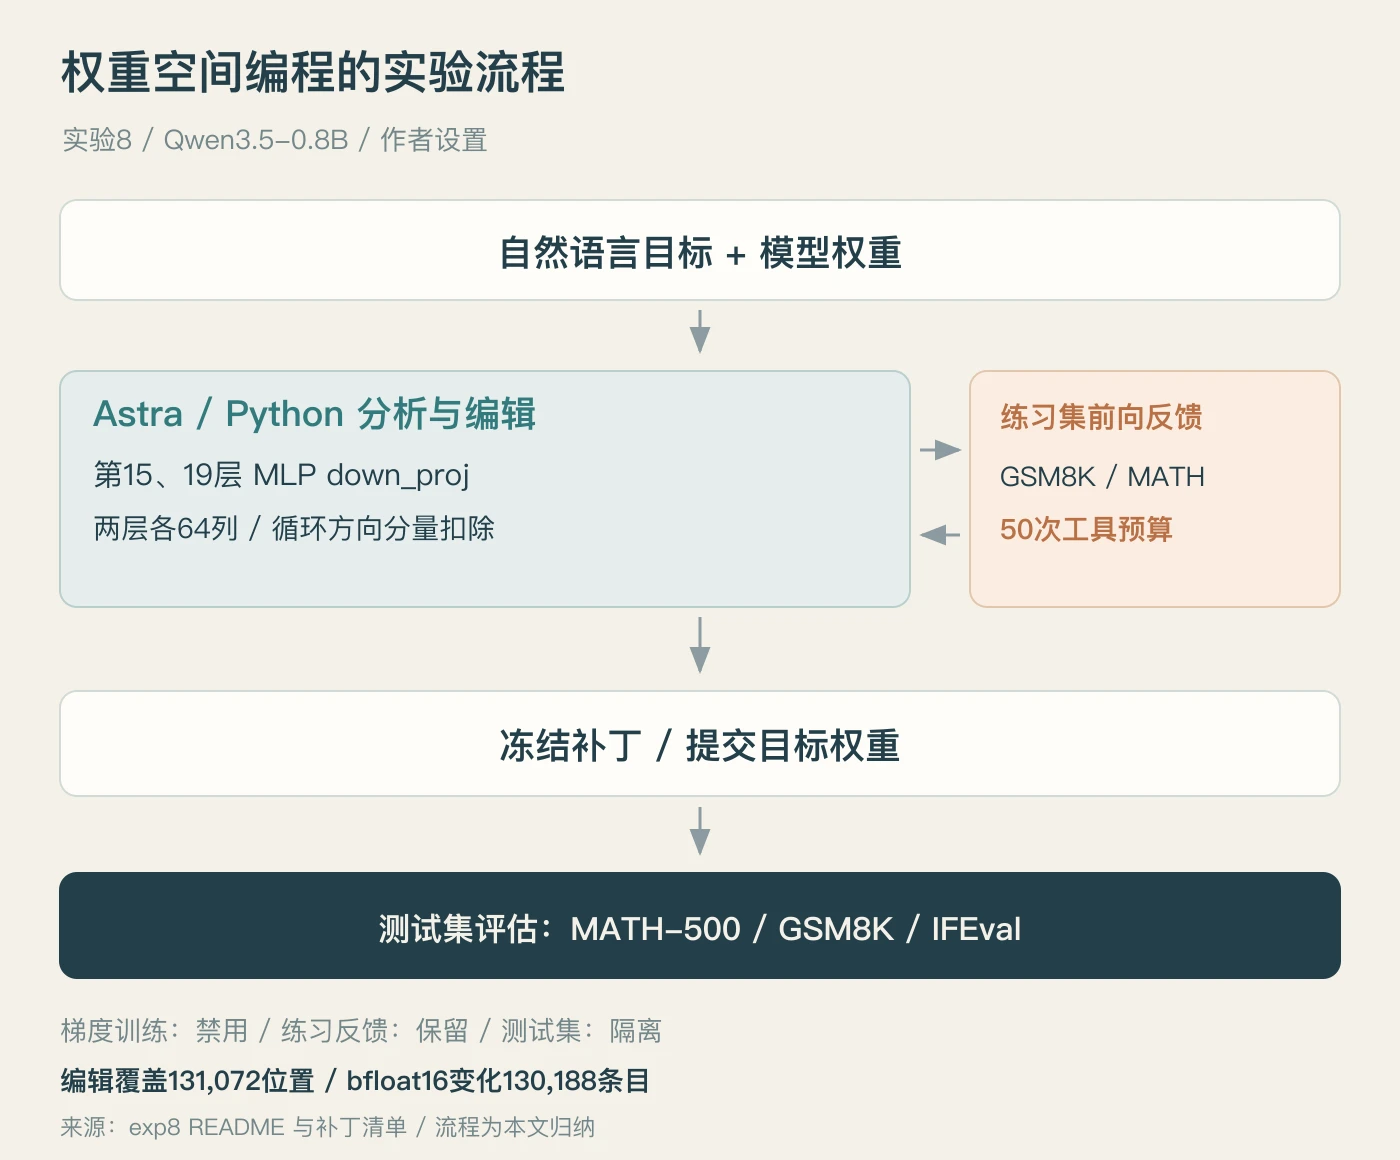
这项工作的编辑流程采用另一种接口:研究者提出目标,Astra 分析权重与实验反馈,编写修改数值的代码,提交新的权重。
作者禁止了本次编辑中的梯度下降、反向传播和训练循环。Qwen 的预训练、Astra 的原有训练,以及其他对照网络的训练,属于这项约束之外的历史过程。实验与运行说明
它像一次针对程序内部状态的调试:目标是问题定位和补丁,参数是编辑材料,评估结果承担检查职责。
大模型的输入方式存在规模差异。小型网络的数值写入提示词;Qwen 的参数规模超出完整上下文承载范围,作者提供了持久化 Python 环境和权重读取接口。目标张量和统计信息,构成8亿参数模型的分析材料。模型推理与代码操作,构成“读写权重”的实现过程。
二、0.016%的改动,修了什么
Qwen3.5-0.8B 的原始模型卡注明,思考模式存在进入重复推理循环的风险。重复内容消耗输出预算,模型缺少最终答案,评分系统判错。千问官方模型卡
本实验启用了思考模式,输出上限是 32,768 Tokens。原始模型的 MATH-500 输出触及长度上限的比例为 93.0%。
作者的解释是:第 15、19层 MLP 的某个输出方向参与了循环行为。最终补丁扣除了两层各 64列 输出权重中的该方向分量,目标张量名包含 mlp.down_proj.weight。
编辑覆盖位置的算式是 2 × 64 × 1024 = 131,072。公开补丁清单给出的 bfloat16 数值变化条目为 130,188,两者的差异来自数值舍入。标题中的 0.016%是约数,描述编辑规模。补丁清单
循环减少,模型获得了完成答案的机会。这与注入一套新的数学知识,属于不同解释。
作者的结果支持一个具体发现:模型的某种行为障碍,存在少量权重补丁的修复入口。
三、6.1倍,比较的是哪组成绩
作者提供了 10、25、50次前向评估 三种预算。50次预算对应的结果是:
| 指标 | 原始模型 | 编辑后模型 |
|---|---|---|
| MATH-500 得分 | 7.9% | 48.1% |
| GSM8K 得分 | 13.8% | 67.1% |
| IFEval 指令遵循得分 | 21.0% | 62.3% |
| MATH-500 输出触及长度上限的比例 | 93.0% | 33.1% |
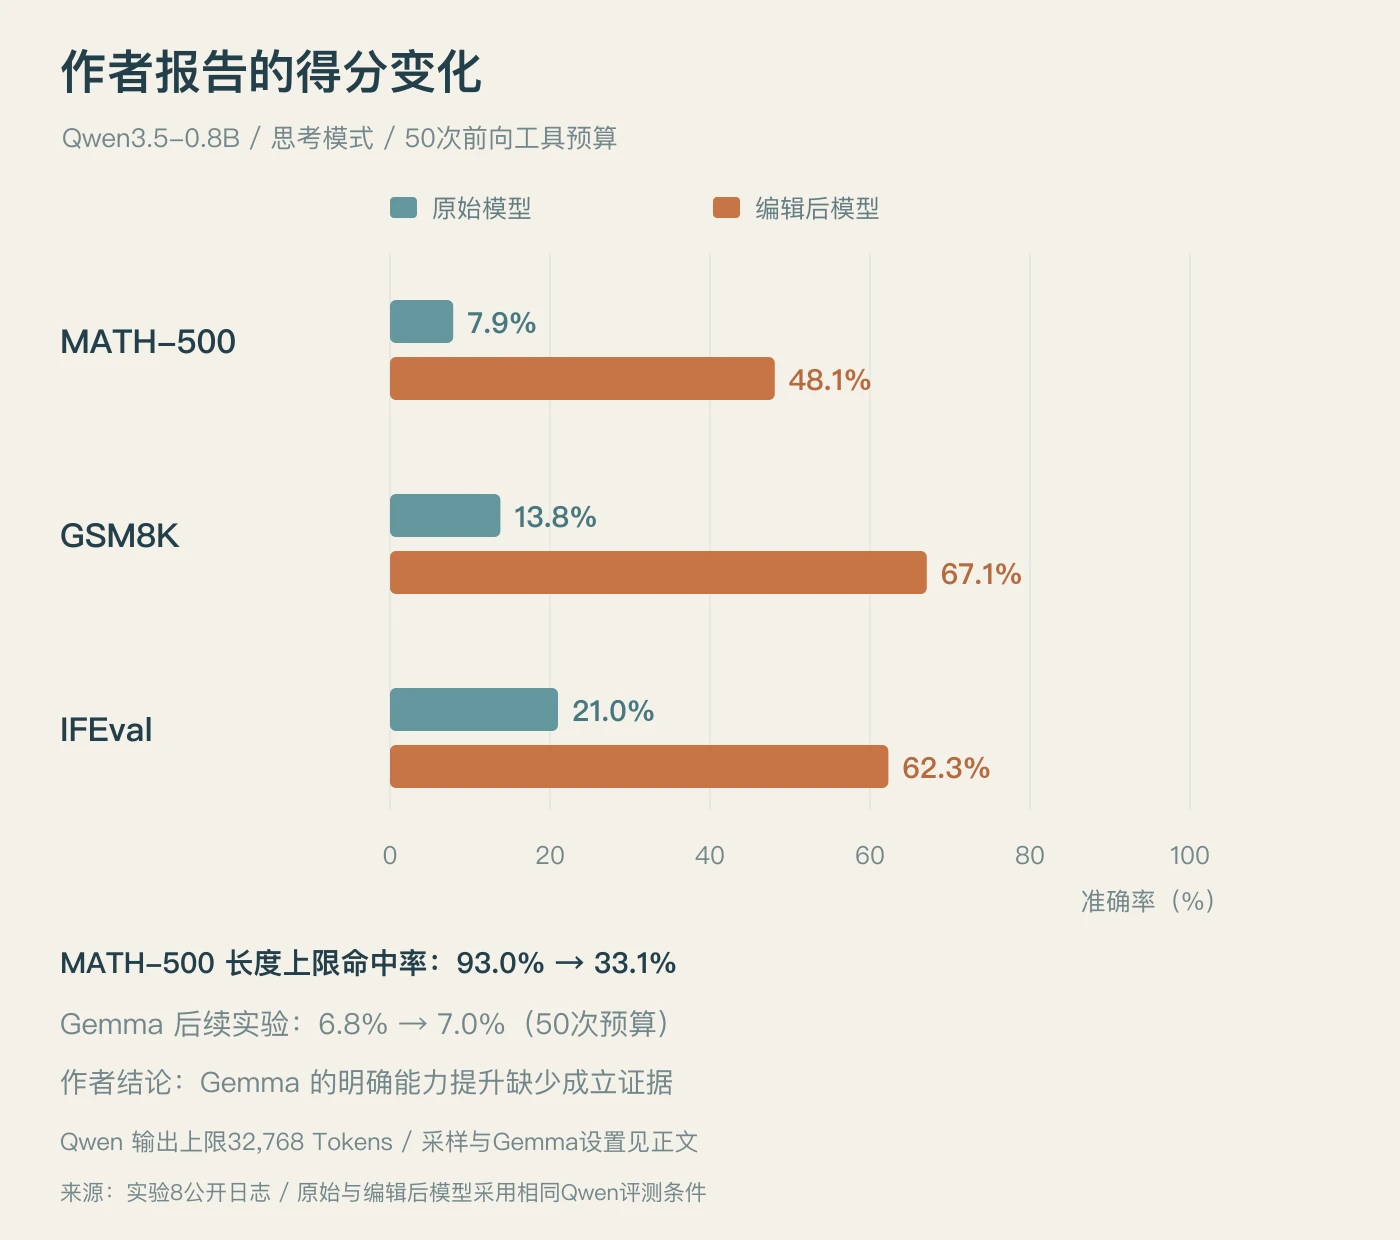
MATH-500 的比值算式是 48.1 ÷ 7.9 ≈ 6.1,绝对变化是 40.2个百分点。“得分变成6.1倍”与“增加6.1倍”,含义存在区别。
评测参数是 temperature=0.6、top_p=0.95、top_k=20、presence_penalty=1.5,思考模式开启。MATH-500 的题目数为500,单题采样数为4,成绩是全部样本的平均准确率。GSM8K 和 IFEval 的单题采样数为2。实验8设置与结果出处
这组基线的解释对象,是本实验的思考模式与采样条件,缺少代表千问所有配置、所有任务的效力。编辑后 33.1% 的输出触及上限,循环问题保留了残余。
10次与25次预算的 MATH-500 成绩是 12.3%和14.1%。这些数字说明,突出结果属于特定预算下的实验轨迹,普遍的单次成功承诺缺少依据。
四、禁用梯度训练,实验拥有数据与成本
“训练禁用”的范围是本次编辑机制。实验材料包含练习题和反馈。
Astra 获得了 GSM8K、MATH 等训练划分中的练习材料及答案,测试集属于隔离对象。前向工具负责运行模型,Python 环境负责权重分析与编辑。
50次预算指50次工具评估调用,单次生成调用的容量上限为512道练习题;教师强制读取的容量上限为1024段文本。 它缺少“五十道题”的含义。
日志记载,50次预算轨迹包含 158轮交互、80次Python运行,墙钟时间是 20.3小时;服务等待占用 4.7小时。这些数字提供运行背景,缺少构成通用成本报价的条件。实验8运行记录说明
这条路径的编辑机制排除了梯度更新,模型推理、练习评估、编辑搜索和最终测试构成了成本。完整成本优势需要同目标、同资源口径的对照实验。
公开性提供了后续核验入口:日志仓库包含提示、回复、代码与结果,补丁重建脚本检查目标张量的 SHA-256。仓库说明排除的内容包含早期提示版本的试验过程和部分运行材料。日志仓库
Hugging Face 模型页记载,akhaliq 重建了检查点并重跑 MATH-500,编辑后成绩为 51.0%。该重跑的题目数为500、单题采样数为4;其原始模型检查是25题的小规模测试,完整基线配对实验属于另一项工作。本文核对了公开材料,缺少本文的模型运行实验。模型与重跑记录
五、一个失败结果,划出了边界
团队做了一组 Gemma 3 270M IT 的后续实验。这个模型的重复循环问题轻,原始输出触及长度上限的比例为 8.5%。
同类权重编辑的 MATH-500 原始得分是 6.8%。编辑后预算与成绩的对应关系为:5次 7.0%,10次 7.6%,25次 7.7%,50次 7.0%。作者报告的结论是,明确的能力提升缺少成立证据。Gemma 后续实验
这个结果划出了边界:修复一个阻碍答案生成的循环,与补足缺失的算术和代数能力,具有不同难度。
原文包含其他规模的探索:读取游戏网络权重、识别简单扩散模型的生成形状、构造小游戏与围棋网络。奉承行为识别实验的纯权重版本失败;补充注意力观察工具的版本获得了成功。任务与工具权限,影响证据范围。
作者提出了模型审计、能力编辑、模型合并与自我改进等未来方向。它们的身份是研究展望。Qwen 的这次补丁属于大模型编辑另一模型的案例,自身权重优化与无限递归提升,需要新的实验。
这项工作的进展,是自然语言目标、模型推理与权重补丁形成了一条实验链。它展示了行为修复的入口,通用能力改造的边界留给后续研究。
参考资料
- 研究原文:Sparks of Weight-Space Programming。
- 实验日志、编辑代码与结果。
- 实验8设置与数据来源。
- 编辑后模型与Hugging Face重跑记录。
- Qwen3.5-0.8B官方模型卡。
核验日期:2026年11月3日。日志版本:4d09ba6。图表为本文原创,结果数据来自作者与模型页的公开记录。
