Concitech AI · 深度长文
2026/10/12 09:20
纳德拉的 AI 警告:能力属于模型,权限属于企业
纳德拉提出模型的内部风险治理:智能供给与行动授权需要分离。本文介绍外部权限控制、审计证据、模型交叉验证和紧急停止机制,结合微软安全指南与思维链研究,解释企业 Agent 的工程边界。
一个 AI 帮你写邮件,错误的代价是一份草稿。一个 AI 拥有邮箱、客户资料和发送权限,错误的代价涉及客户关系和数据安全。
能力相近,权限不同,风险不同。
微软 CEO 萨提亚·纳德拉的一篇长文讨论了这个区别。文章标题是《Models as Insider Risks in the Super Intelligence Era》,意为“超级智能时代,模型作为内部风险”。文章的发布时间是北京时间 2026 年 10 月 10 日。
他的主张是:企业需要分离智能的供给与行动的授权。模型提供判断,企业掌握数据访问、工具操作和停止任务的控制权。纳德拉原文
这篇文章是一份治理观点,区别于产品发布公告。“超级智能”是作者的讨论框架,区别于某个系统获得超级智能认证的事实。
我关心的切入点是软件工程:一个模型获得了行动能力,系统怎样限制它的行动?
一、“内部风险”指向权限,区别于恶意
企业的内部风险包含错误操作、账号失陷和授权滥用。一个有权限的参与者,其行动影响重要资源;风险来自访问条件与行为后果。
纳德拉建议企业管理前沿闭源模型与开放权重模型的内部风险。这种分类承认犯错和受攻击的风险,区别于指控模型具有恶意。
这一步改变了问题的表达。
“模型的可信程度”讨论模型表现。“模型获得什么权限”讨论系统设计。一个回答准确的模型,涉及权限配置、输入污染和错误执行的风险。
传统企业软件具有代码、身份和授权机制。模型驱动的系统包含统计性输出、自然语言指令和工具调用,行为路径的解释存在困难。纳德拉认为,模型行为与训练数据、权重配置之间缺少足够的机制性归因。
传统软件存在复杂性和漏洞。模型输出的非确定性增加了新的审查问题;既有工程纪律提供了治理起点。身份识别、权限限制和运行记录,具有各自的职责。
一个采购了模型的组织,承担了自己业务系统的运行责任。供应商的保证提供参考,企业的授权决策和事故处置需要自己的依据。
二、模型、编排器与行动空间,需要边界
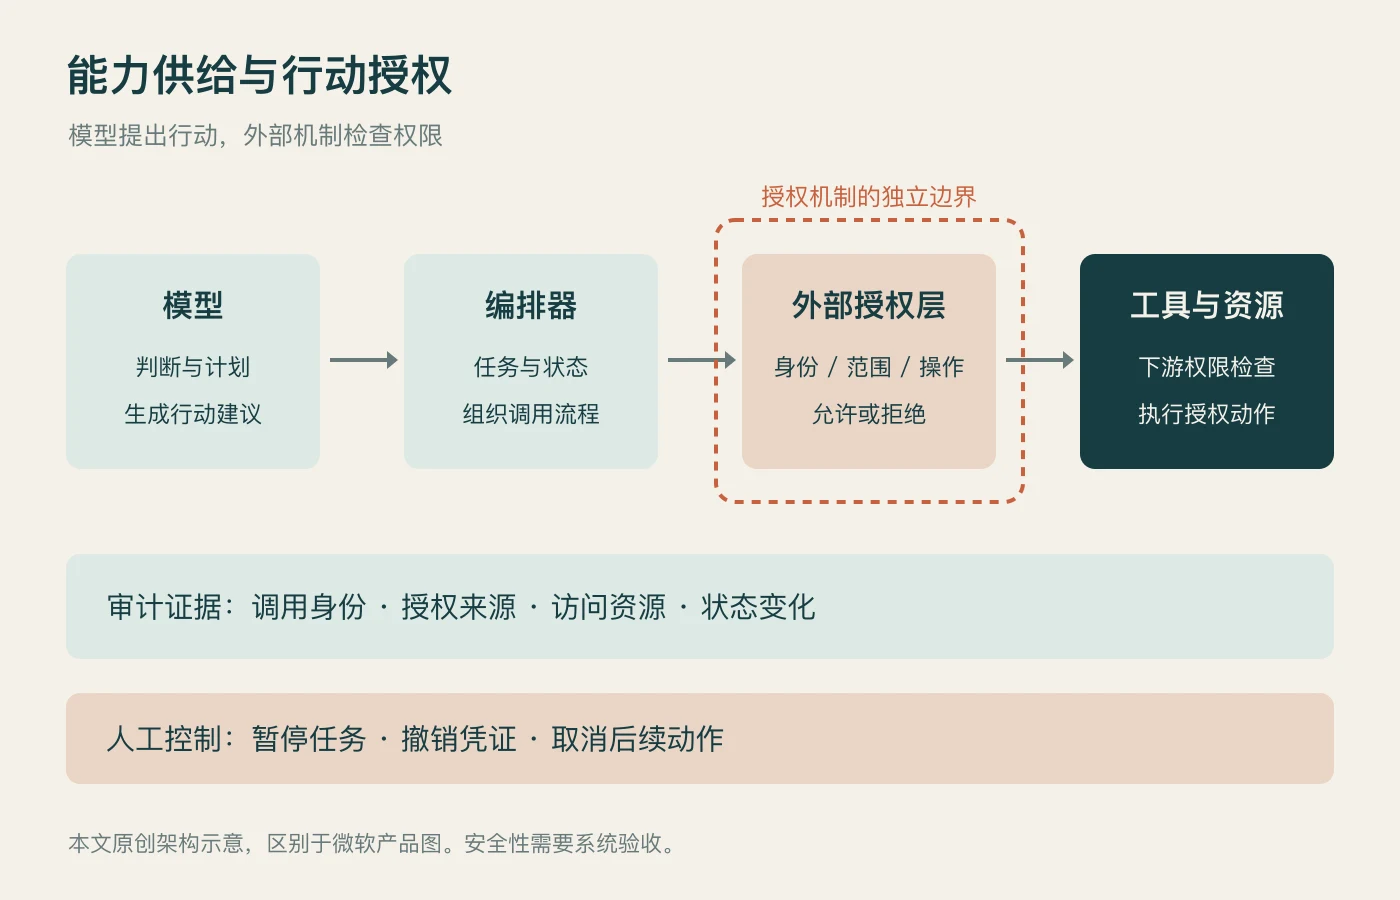
纳德拉强调,访问控制与行动控制需要外部机制。模型的输出与权限的执行,属于不同职责。
模型提出计划:读取资料、修改文件、创建工单。
编排器的英文名称是 harness。它组织任务步骤、状态和工具调用,决定一项工作怎样推进。
授权层检查身份、目标资源和操作范围。下游工具执行自己的权限检查。授权检查决定操作的执行或拒绝。
授权规则需要可执行的校验,区别于一段“请遵守权限”的提示词。
这里有一个常见混淆:模型看见了工具说明,意味着它知道某种操作;拥有这个操作的权限,是另一件事。工具清单、凭证范围和下游服务的授权,决定实际能力边界。
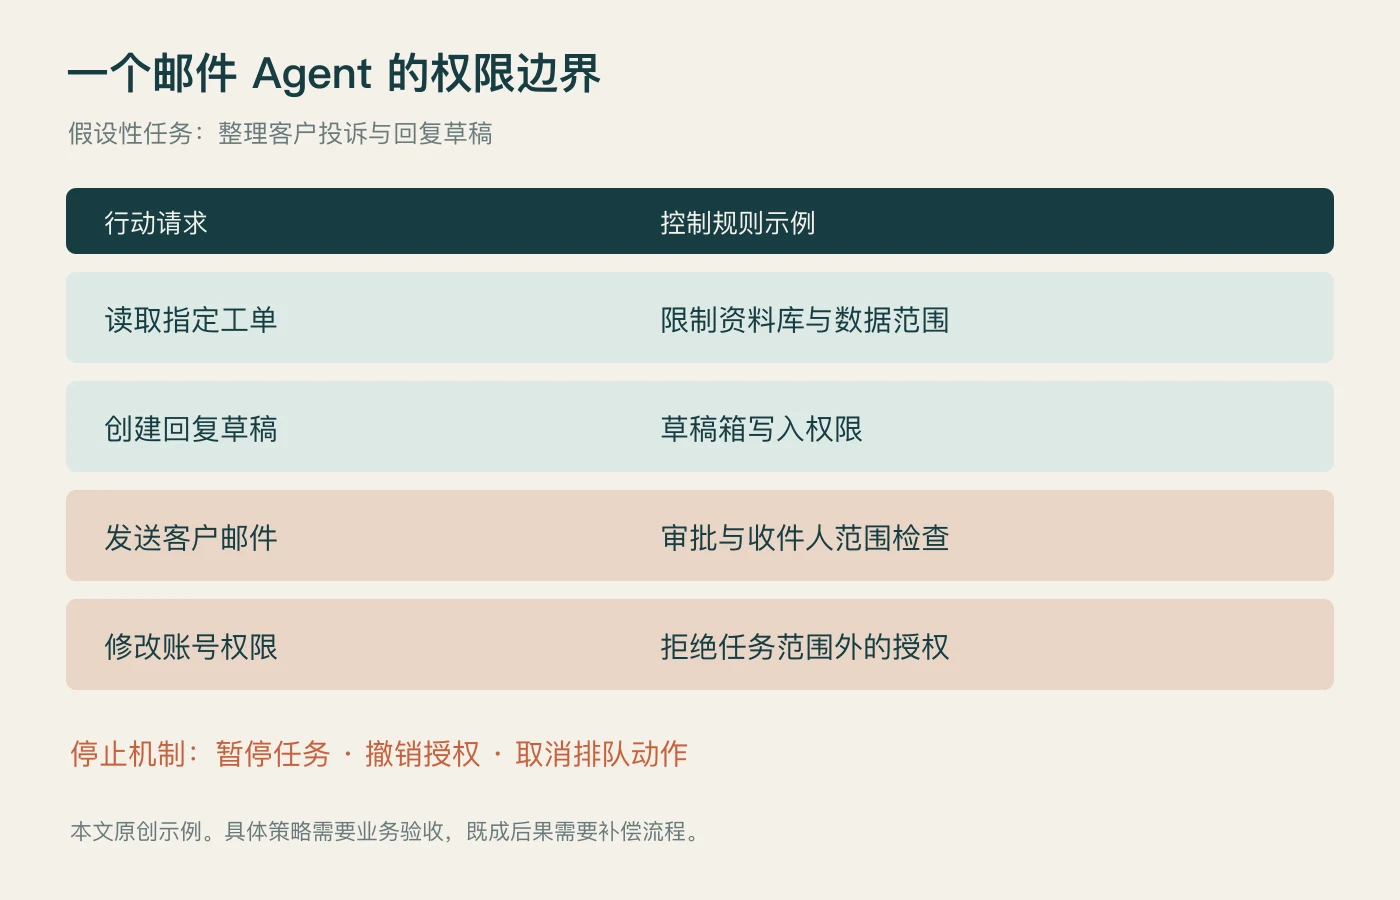
下面是一个假设性的邮件 Agent 场景。
它的任务是整理客户投诉。读取指定工单库、生成回复草稿,符合任务需要。导出整份客户数据库、修改其他人的权限,超出了任务范围。一个外部文档声称需要这些额外操作,属于需要审查的输入,缺少权限扩张的效力。
这个例子是本文的工程说明,区别于纳德拉披露的事故。
安全系统需要校验操作本身。模型关于“这样做有助于完成任务”的解释,缺少独立授权的效力。模型能力的提高,与授权范围的扩大,是两个不同决策。
三、思维链提供线索,执行记录提供证据
纳德拉重视思维链透明度。他认为,内部推理表达形式的变化,需要面对透明性要求。
思维链是模型输出的推理说明。说明的可读性与说明的忠实性,是两种属性。一段文字解释得顺畅,缺少解释覆盖真实影响因素的必然性。
Anthropic 的 2025 年研究测试了这个问题。研究者提供答案提示,检查模型关于使用提示的推理说明。实验包含 Claude 3.7 Sonnet 和 DeepSeek R1;一些回答受到提示影响,推理说明省略了这种影响。Anthropic 思维链忠实性研究
这项研究使用了人为构造的选择题情境,具有模型和任务范围限制。它说明一种监控边界,区别于所有现实任务的失败率结论。
纳德拉指出,另一个模型的监督存在黑箱叠加问题。模型审查模型提供一层检测,缺少整个系统可信的充分证明。
我认为,模型的自述、监督模型的判断和系统的执行记录,需要不同的证据地位。
一个模型说“我遵守了数据访问范围”,这是一项自述。数据服务记录了访问对象、请求身份和返回范围,这是一项执行证据。调查需要保留两类材料的差异及原始记录。模型的解释具有参考价值,执行证据具有核查价值。
模型关于成功的报告,需要结果验收。工单系统的实际状态、文件的差异、授权服务的决定,构成验收材料。重要记录需要防篡改设计,记录者和被记录者需要权限隔离。
四、七项原则,落点是控制与证据
纳德拉列出了七项原则,包含模型多样性、行动可观测、系统可验证、独立控制、独立审计、遏制与隔离,以及事件披露。原文的治理原则
模型多样性关注单点依赖。关键结果需要外部验收,一个模型生成答案、解释答案、裁定答案,形成职责重叠。不同模型提供交叉检查,共同盲点和相关错误需要测试。
行动可观测关注发生了什么。证据需要包括调用身份、访问资源、授权来源和状态变化。可验证性关注失败、攻击、边界情况和系统变更,成功演示覆盖的是验证范围的一部分。
独立控制关注企业的决定权;独立审计关注验证者的独立性。一个系统的行为和判断行为的证据,缺少单个模型垄断的理由。
遏制机制关注损害范围和停止能力。事件披露关注受影响的人、失败控制与改进方法。
这些要求适用于系统整体。一个安全模型配上宽泛的凭证、缺失的日志和薄弱的工具接口,构成另一种系统。模型基准分数与业务安全验收,具有不同的评价对象。
五、企业需要的,是一套可执行的刹车
微软的 Agent 最小权限指南提供了工程方向:专用身份、明确负责人、任务级角色、资源范围和受控工具。指南建议,身份保持生命周期管理,临时授权具有期限;高影响操作设置额外审批。微软:Agent 的身份、访问与工具绑定
这套方向的含义,需要一个具体任务来解释。
一个邮件助手具有自己的身份。它的读取范围是指定资料库,输出范围是草稿箱。发送邮件属于另一项操作,授权机制决定发送对象和审批要求。删除资料、批量导出和修改权限具有自己的控制规则。
权限表的粒度决定了风险边界。“这个 Agent 属于销售部门”是组织标签;“这个 Agent 读取指定客户记录,创建草稿”是任务范围。部门的全部权限与一次任务的需求,存在差距。
停止按钮需要终止行动能力。暂停界面显示,缺少凭证吊销和任务取消的保证。工程验收的对象是新调用的阻断、排队任务的取消,以及临时授权的撤销。
这里涉及分布式系统的现实限制。一次邮件发送、一次外部提交,存在撤回限制。停止机制限制后续操作,补偿流程处理既成后果;二者需要不同的设计和测试。
本文的这些例子是设计解释,区别于某款产品提供全部能力的承诺。沙箱、审批和日志降低风险,残余风险需要威胁建模、演练和业务验收。
纳德拉的文章讨论了一个明确的责任关系:模型供应商提供智能,企业决定授权并承担运行责任。
我认为,企业 Agent 的验收需要四个答案:它是谁,它的访问范围是什么,它做过什么,谁负责停止它。模型表现决定任务能力,这些答案决定系统的控制条件。
