Concitech AI · 深度长文
2026/09/05 08:53
NVIDIA PAIR:一条入口,多台电脑,各自显存
NVIDIA PAIR 是本地 AI 的统一入口,调度对象包括 RTX、DGX Spark 与 Apple M4 设备。每个请求归属单个节点,显存保持独立。开源 beta 的价值是并发容量,短板涉及调度信号、模型副本与安全边界。
一套家庭设备包含 Mac、RTX 电脑与 DGX Spark。每台机器具备模型推理能力。Agent 认识一个地址。
NVIDIA PAIR 接过请求,检查模型库存与节点负载。单个请求归属一台机器。其他节点接收其余请求。
产品定位是推理路由器。它处理请求队列;显存合并属于另一类技术。
这条边界决定 PAIR 的价值。多 Agent 工作流获得并发容量。单条大模型请求保留原有硬件上限。
一个端点与一组对等节点
每台设备安装 PAIR。节点关系是对等关系。中央控制节点数量为零。每个节点承担请求发送与请求执行两种角色。
mDNS 发现候选设备。IP 地址承担备用入口。六位 PIN 建立节点互信。证书固定节点身份。mTLS 保护节点通信。
本地应用使用两个兼容端点:
- Ollama 接口:
127.0.0.1:11434 - LM Studio / OpenAI 兼容接口:
127.0.0.1:1234
PAIR 代理占用常用端口。推理引擎使用后续端口。Agent 工具看到普通的 Ollama 或 OpenAI 接口。请求进入代理。代理读取引擎类型与模型名称。
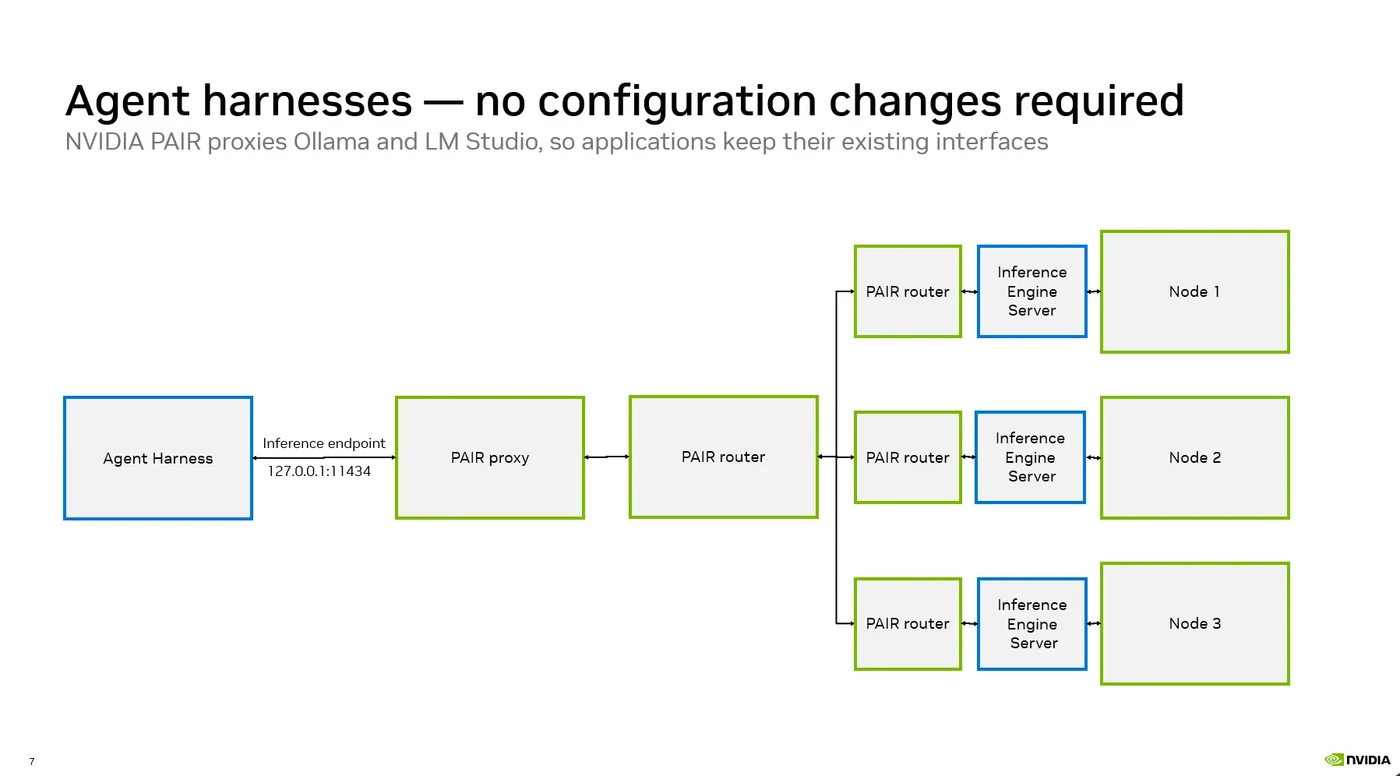
兼容端点、PAIR 代理、路由器与三节点结构。来源:NVIDIA。
候选节点需要三项资格:
- 网络状态:连通
- 推理引擎状态:运行
- 模型库存:包含指定模型
合格节点进入候选表。任务数与 GPU 利用率产生排序。代理选择首个节点。该节点执行完整请求。响应路径与请求路径相同。
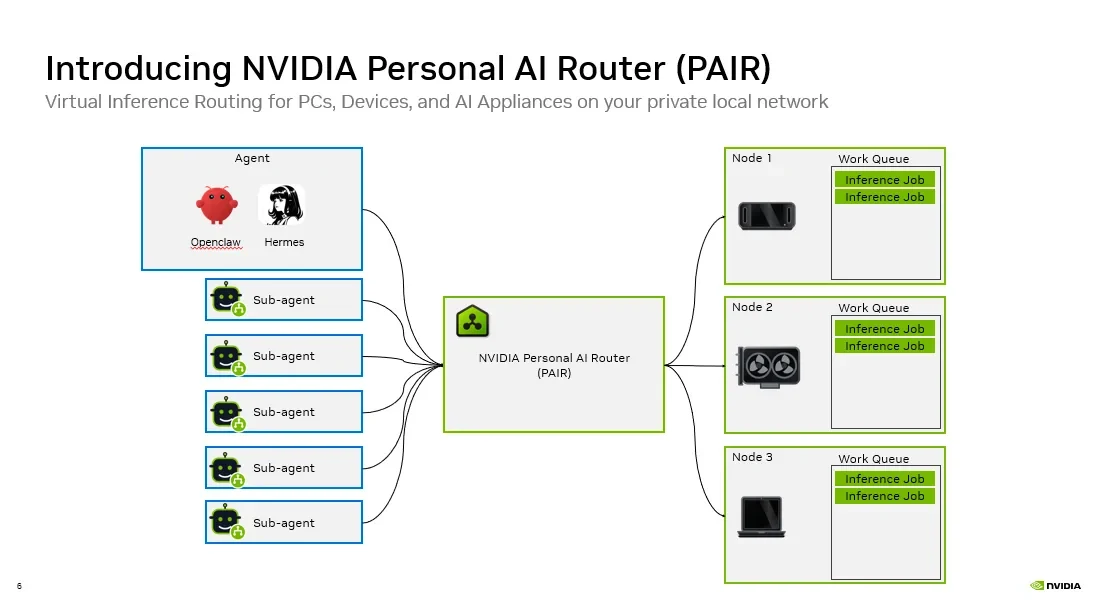
PAIR 请求路由图。多个 Agent 请求进入一个路由器,每项任务归属一个节点。来源:NVIDIA。
三台机器与三组独立显存
官方文档给出五条边界:
- 显存归属保持节点级
- 模型分片需要其他工具
- 单个请求的驻留节点是一个固定节点
- 运行中迁移属于能力表之外
- 模型存储归属 Ollama 或 LM Studio
Mac、RTX 电脑与 DGX Spark 提供三个独立执行槽。每份模型占用本机内存。设备数量增加请求并发。单个模型的显存上限归属所选节点。
70B 模型的唯一副本位于 DGX Spark。相关请求的归属节点是 DGX Spark。RTX 机器与 Mac 缺少该模型副本,调度器缺少替代节点。
相同模型的三份副本产生三个候选节点。请求队列获得分流空间。模型放置决定调度自由度。
PAIR 增加并发槽位。单条请求速度取决于所选节点、模型格式、推理引擎与上下文长度。顺序任务的收益有限。
支持范围与开源状态
PAIR 的产品状态是 beta。NVIDIA 的验证范围包括:
- GeForce RTX 20 系列及后续产品
- RTX PRO 工作站 GPU
- DGX Spark 与其他 GB10 设备
- Apple M4 系列及后续产品
系统范围覆盖 Windows、macOS 与 Linux。推理后端是 Ollama 和 LM Studio。运行阶段的联网需求:无。模型下载阶段的联网需求:有。
NVIDIA 公开了代码仓库。许可证是 Apache-2.0。最新发行版是 v0.1.1,发布日期为 2026 年 8 月 28 日。
Apache-2.0 许可证提供代码审查与源码构建条件。v0.1.1 的已知问题列表包含调度、平台与故障处理缺口。
一组演示与一个数字冲突
NVIDIA 技术博客给出一组 Hermes 五子 Agent 演示。模型是 Qwen 3.6 35B A3B。推理引擎是 Ollama。
单台 RTX Spark 笔记本的平均完成时间是 18 分钟。三设备集群包含 RTX Spark 笔记本、DGX Spark 与 RTX 5090。博客正文给出的平均完成时间是 8 分 48 秒。
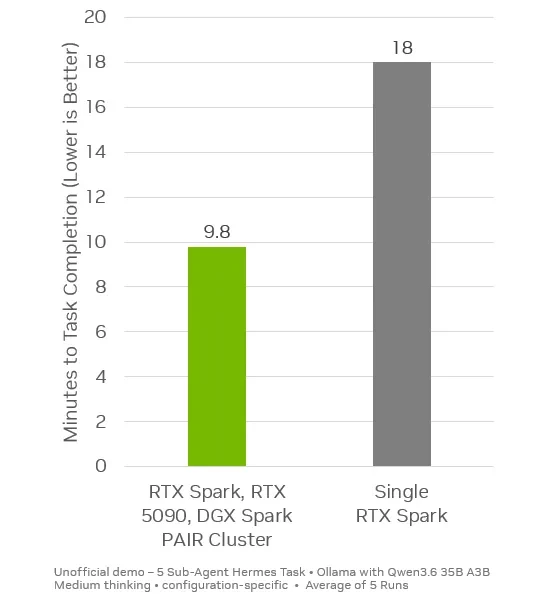
NVIDIA 官方演示图。图中集群时间是 9.8 分钟,博客正文数字是 8 分 48 秒。来源:NVIDIA。
图中文字是 9.8 分钟。正文数字是 8 分 48 秒。换算结果是 8.8 分钟。两者相差 1 分钟。
数字冲突削弱精确比较。NVIDIA 对该测试的定性是“非官方、特定配置演示”。测试次数是五次。工作负载、模型、引擎设置、硬件和节点状态影响结果。
这组材料支持一个方向判断:并发任务受益于多节点。通用倍速结论缺少证据。
调度器的负载视野与容量盲区
PAIR v0.1.1 的调度信号包括待处理任务数与粗粒度 GPU 利用率。输入表缺少 GPU 型号、可用显存、实测延迟、请求成本与模型热状态。
这套策略带来四个问题。
任务计数。三 Token 回复与长文本生成属于同一个计数单位。任务数量缺少请求成本信息。
异构节点。小 GPU 与大 GPU 的相同利用率得到相同压力分数。混合集群存在慢节点接单风险。
模型热状态。模型库存的判断依据是文件存在状态。模型内存驻留状态位于排序输入表之外。冷加载延迟归属请求。
多 GPU 节点。遥测值取最大利用率。其他 GPU 的空闲容量位于调度视野之外。
统一内存设备存在显存展示误差。Windows 集成 GPU 的显示值低于实际容量。缺少 NVIDIA 驱动的 Linux 设备显存值为空。调度器输入表缺少显存,展示误差影响用户的模型放置判断。
这些局限符合 v0.1.1 的早期版本身份。异构设备数量增加。调度质量的重要性上升。
本地推理的安全边界
“数据留在家中”是 PAIR 的卖点。技术文档给出了具体边界。
本机应用连接 loopback HTTP。节点推理流量使用 mTLS。节点加入需要邀请与六位 PIN。集群成员证书获得固定关系。
配对阶段的传输方式是明文。PIN 承担认证。节点硬件遥测使用未认证的明文 HTTP。同网段设备拥有主机名、硬件清单与利用率的读取权限。
适用网络是可信家庭或工作室 LAN。风险网络包括共享公寓、公共 Wi-Fi 与陌生终端所在网段。
“本地”描述数据路径。“零信任安全”属于另一项判断。PAIR 的安全模型依赖设备信任与网络信任。
家庭 AI 集群的适用任务
收益场景包括多 Agent 工作流、并发本地工具、相同模型多副本与混合模型库存。
低收益场景包括单条长推理、顺序任务、单副本大模型与低速网络。
一台主机运行 Agent。另一台主机承担游戏或创作。其他节点接收推理请求。这种分工符合 PAIR 的设计目标。
我的判断是:PAIR 与家庭网络里的负载均衡器同类。它的价值是闲置算力的队列化。“超级 GPU 虚拟化”属于另一类产品。
统一入口解决接入。模型副本位置与调度策略决定使用体验。
v0.1.1 适合家庭实验。生产部署需要容量感知、模型热状态与明确的遥测隐私控制。
