Concitech AI · 深度长文
2026/10/26 09:49
RTX 4090 算力翻倍?三个 GitHub 项目与实测边界
三个开源项目覆盖 Turing、Ampere 与 Ada 架构的部分显卡。RTX 4090 的特定 Tensor Core 指令吞吐接近两倍,矩阵乘法收益存在差异。本文介绍仓库、测试条件、Windows 实验路线与硬件风险。
RTX 4090 的一组测试记录引发关注:FP16 输入、FP32 累加的 Tensor Core 指令吞吐为 165.6 → 331.6 TFLOPS。
相同功耗上限,接近两倍的指令吞吐。这是开源项目提交的硬件测试结果。
但“显卡性能翻倍”存在口径问题。另一位持卡人的复现显示,指令吞吐接近两倍,cuBLAS 矩阵乘法的收益介于持平与约 34% 之间。游戏帧率、整套模型的训练速度、聊天机器人的输出速度,缺少两倍提升的统一证据。
这件事的主体是三个 GitHub 仓库:Turing 路线的 turing-unlock、Ampere 路线的 gpu-unlock,以及 Ada 路线的 gpu-unlock-ada。它们涉及 RTX 20、30、40 系列的部分型号,硬件验证范围存在差别。
“解锁”的对象:一种计算路径
Tensor Core 是 GPU 的矩阵乘加单元。它处理的核心运算形如 D = A × B + C。
输入数据的格式、累加结果的格式,是两个概念。FP16 或 BF16 描述输入格式,FP32 累加描述中间结果的精度。混合精度计算的这条路径,是这些项目关注的对象。NVIDIA 的 Tensor Core 技术说明介绍了输入与累加精度的区别。
项目描述的机制,是显卡初始化阶段的速率选择状态修改。Linux 路线采用内核模块,模块的执行顺序位于官方 NVIDIA 驱动接管显卡之前。
“官方驱动保持原样”描述的是驱动文件;内核模块、固件执行与启动链的改动,属于另一个风险层级。它与普通应用的安装存在区别。
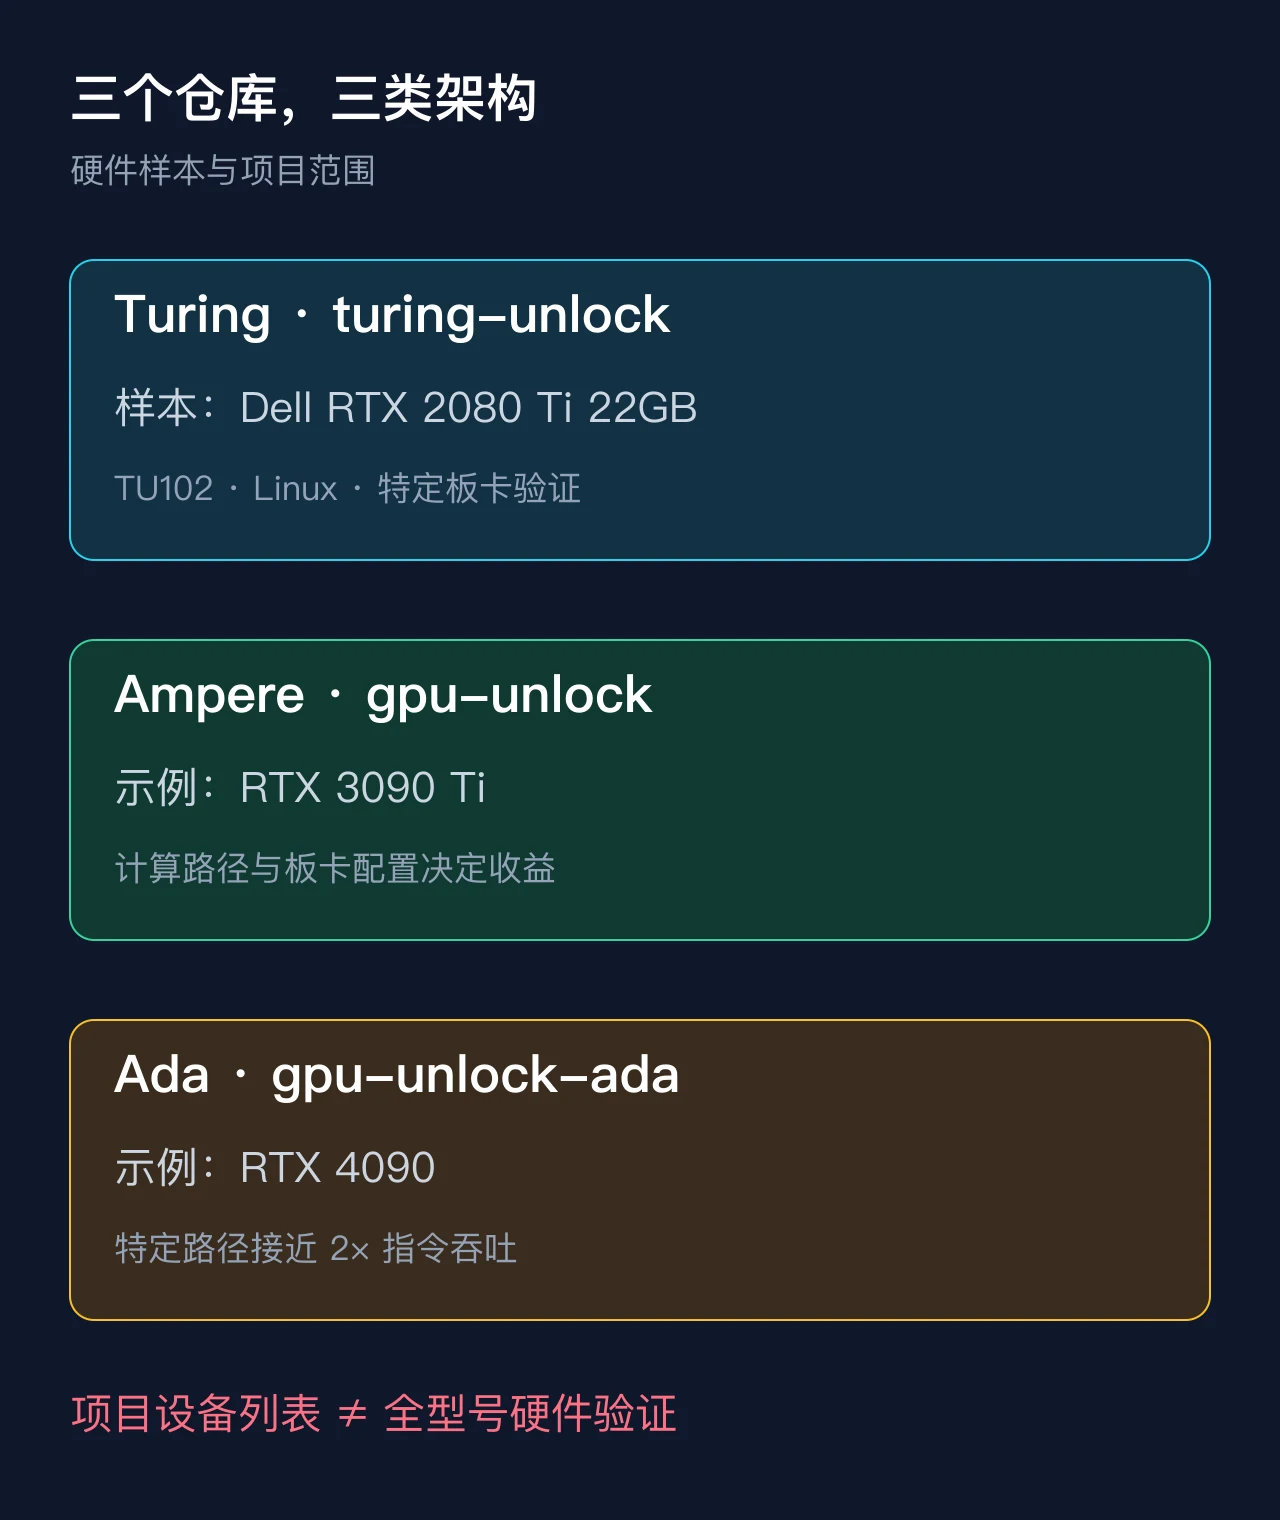
图:三个仓库的定位。样本来自项目文档;型号名称代表测试对象,兼容性结论限于对应配置。
仓库一:turing-unlock,RTX 2080 Ti 的特定样本
GitHub:nlzy/turing-unlock
这个仓库是 gpu-unlock 的 Turing 适配,目标涉及 TU102。README 列出的测试对象,是一张 Dell RTX 2080 Ti 22GB,驱动版本为 575.51.03。22GB 是这张样卡的显存配置,普通零售版 2080 Ti 的兼容性需要额外证据。
250W 功耗上限下的 cuBLAS FP16 输入、FP32 累加测试,包含四种方阵规模。2048 阶测试的吞吐为 55.7 → 91.4 TFLOPS,增幅约 64%;8192 阶为 52.8 → 77.9 TFLOPS,增幅约 48%。
这组数据展示了收益与矩阵规模的关系,“2080 Ti 的全部计算翻倍”超出了它的证据范围。
README 包含硬件损坏警告:Tensor Core 的满速运行涉及功耗风险。这个警告属于项目介绍的必要部分。
仓库二:gpu-unlock,RTX 30 系列的实验入口
GitHub:Zagitta/gpu-unlock
这个项目关注 Ampere 显卡的 FP16、BF16 输入与 FP32 累加路径。它提供 Linux 内核模块与发行版打包方案,README 汇总了不同型号的持卡人反馈。
RTX 3090 Ti 的一组 8192 阶稠密 GEMM 测试采用 450W 功耗上限,结果为:
| 输入格式,FP32 累加 | 基线 | 解锁状态 | 增幅 |
|---|---|---|---|
| FP16 | 87.46 TFLOPS | 118.39 TFLOPS | 约 35% |
| BF16 | 87.50 TFLOPS | 157.41 TFLOPS | 约 80% |
| TF32 | 42.58 TFLOPS | 82.61 TFLOPS | 约 94% |
同一张卡的三条路径,收益存在差异。计算格式的选择,决定了这份成绩单的含义。
兼容性反馈包含反例。一款 RTX 3080 Ti 20GB OEM 样卡完成了解锁流程,BF16 吞吐保持半速。设备列表、模块成功日志与工作负载收益,代表三种证据。
部分应用反馈涉及模型预填充收益;显存带宽主导的解码,以及 INT8 路径,缺少同等收益预期。生产任务的性能结论,需要对应任务的测试。
仓库三:gpu-unlock-ada,RTX 4090 的两倍指令吞吐
GitHub:JustAResearcher/gpu-unlock-ada
这个分支的 Linux 模块集成了 Ada 相关载荷。仓库的原始 RTX 4090 报告给出 165.6 → 331.6 TFLOPS 的 FP16/FP32 指令吞吐,以及 165.5 → 330.6 TFLOPS 的 BF16/FP32 指令吞吐。
一次独立持卡人复现采用同一张 RTX 4090、相同测试程序、NVIDIA 615.78.08 驱动和 450W 功耗上限。它的 FP16/FP32 指令吞吐是 160.4 → 320.4 TFLOPS;FP16/FP16、INT8、标量 FP32 的吞吐接近基线。
这说明,受影响的是特定计算路径。GPU 的显存容量、内存带宽与其他指令单元,缺少两倍提升的证据。
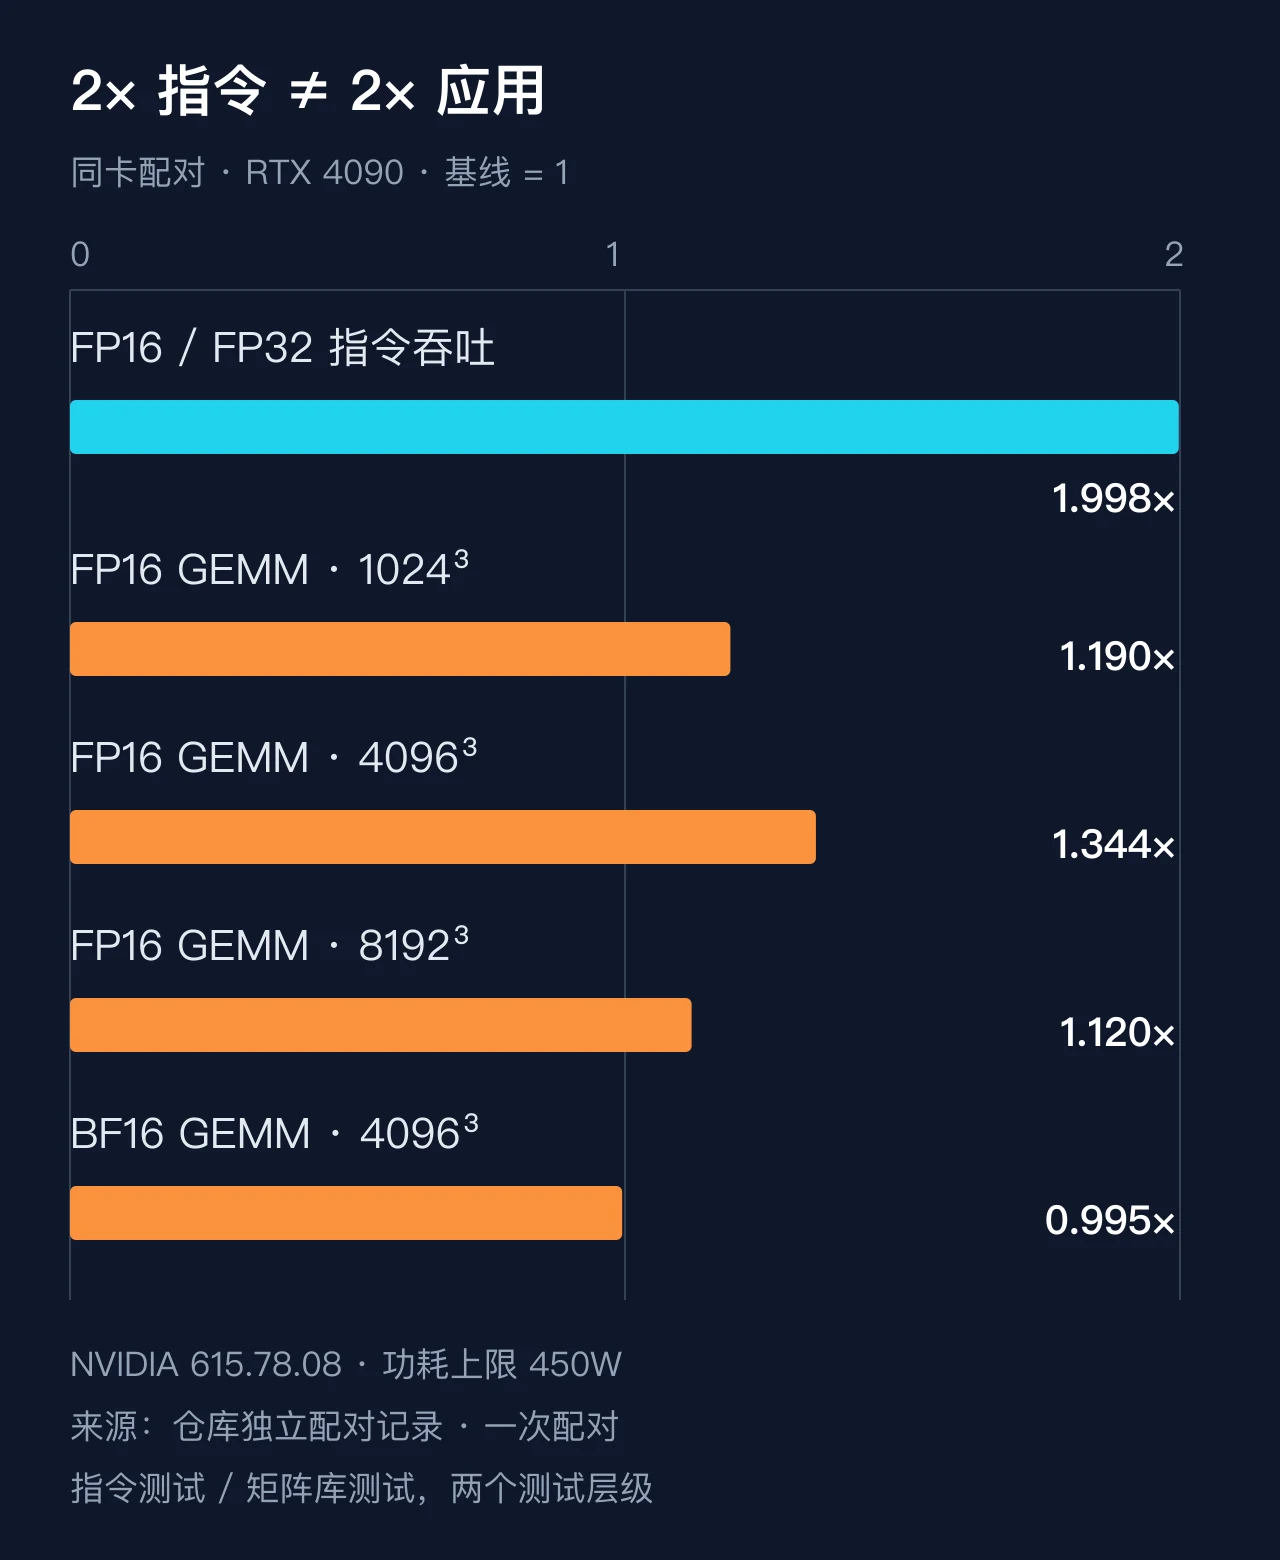
图:同卡配对测试,基线归一化为 1。柱长表示吞吐比值;指令测试与 cuBLAS GEMM 属于不同测试层级。来源:仓库的独立复现记录。
实际 cuBLAS 方阵乘法包含另一组结果:FP16 的提升约 12%—34%;BF16 的两个规模提升约 16%—20%,4096 阶的结果接近持平。
完整证据见 RTX 4090 配对复现记录。记录包含原始输出、数值检查和限制说明。它代表一次基线与解锁状态的配对测试,缺少长期稳定性验证和代表性训练、推理任务。
Ada 分支包含 RTX 4070 Ti SUPER 等实验对象。单卡报告属于对应设备、驱动与功耗配置,全系列兼容性需要额外验证。
Windows 路线:特定板卡的启动实验
相关载荷的来源之一是 TOTORONG/AD103_win_unlocker。它的 英文安装与验证文档描述了一条手动 UEFI 启动路线。
公开方案绑定演示板卡的 ROM 哈希;其他 ROM 属于验证范围之外。文档的实体证据来自一张卡,模拟测试与多机硬件复现存在差别。演示配置包含 Secure Boot 关闭操作,这属于主机安全设置的改变。
“Windows 复现”代表一条实验路径,缺少“所有 RTX 40 显卡的通用 Windows 工具”这一含义。本文保留项目入口,省略安装命令和启动参数。
算力数字之外的四道检查
第一道是硬件身份:芯片、PCI ID、板卡厂商、显存改装情况与驱动版本,构成一份兼容性记录。
第二道是计算口径:指令吞吐、矩阵库性能、完整应用耗时,属于三个层级。某条指令的两倍吞吐,回答的是这个层级的问题;应用收益需要应用测试。
第三道是结果正确性:输出一致性、误差、GPU 错误日志与异常恢复,属于性能报告的组成部分。数值检查的覆盖面决定结论范围。
第四道是系统与硬件风险:内核模块拥有高权限,启动链改动影响故障恢复,供电与散热决定运行约束。短时跑分缺少证明长期安全的能力。
三个仓库的价值,是提供代码、机制说明与可检查的测试记录。“一键变专业卡”“全场景两倍”“零风险”缺少相同强度的证据。
项目介绍的结论是:部分 RTX 显卡的特定 Tensor Core 路径存在显著性能余量;实际收益的答案,属于对应应用的实测。
