Concitech AI · 深度长文
2026/09/04 09:19
“软件工程终结”论文火了:作者 6 天后,先把“终结”删了
一篇名为《软件工程的终结》的论文突然走红,但当前版本已经改名,结论也从“旧的软件工程正在结束”变成“软件工程没有结束,而是在扩展”。标题退了一步,代码退居幕后的判断却值得认真看。
这两天,一张论文首页截图在 X 上流传。
标题够狠:《软件工程的终结》。转发它的人进一步解释说,写代码作为一项技能已经结束,工程师以后只需要提出意图、指挥 Agent,再验收结果。
我找到原论文后,先碰到一个有意思的细节:这已经不是它现在的标题。
arXiv 记录显示,作者 6 月 4 日提交 v1,标题是 The End of Software Engineering。6 月 10 日更新 v2 时,“终结”被拿掉,论文改名为 Agentic Software: How AI Agents Are Restructuring the Software Paradigm,中文可以译作《Agent 软件:AI Agent 如何重构软件范式》。
结论也一起变了。
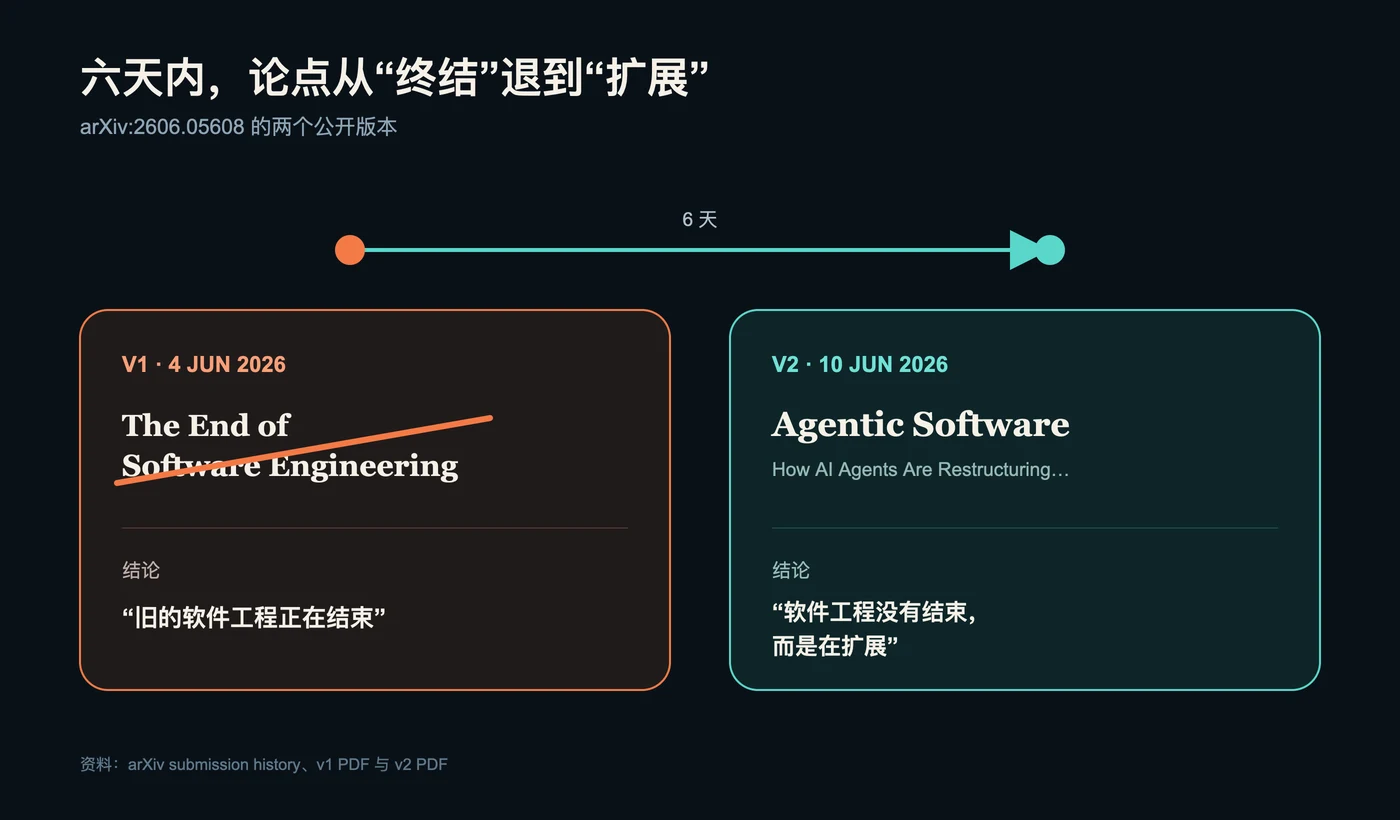
v1 最后一句是“旧的软件工程正在结束,新的已经开始”。v2 改成“旧的软件工程没有结束,它正在长成更大的东西”。
六天里,作者撤掉了最有传播力的两个词,也把论点从职业消亡收回到工程范式变化。
先说清楚:这是什么论文
网上常把它描述成“中国研究人员刚刚发表的论文”。准确说,它是一篇 15 页的 arXiv 预印本,只有一位作者 Zhenfeng Cao,署名机构是深圳一家企业。公开页面没有显示会议或期刊的同行评审信息。
论文也没有训练新模型、发布新数据集或完成一组全新的对照实验。它更接近 position paper:提出一套观点,再用已有论文、开源项目和企业案例支撑。
这不妨碍它有好想法。但阅读时要分清两件事:哪些是作者提出的未来判断,哪些是实验已经证实的结果。
推文把前者写成了后者。
论文的核心:代码不再是唯一的“决策载体”
传统软件先把决策写进代码,再由机器照着执行。遇到新需求,人要找到对应逻辑,修改、测试、部署。
论文设想的 Agent 软件不同。人提供目标和约束,LLM 在运行时规划步骤、调用工具,需要时临时生成代码,完成任务后丢掉中间产物。Agent 本身既像软件,又像操作软件的人。
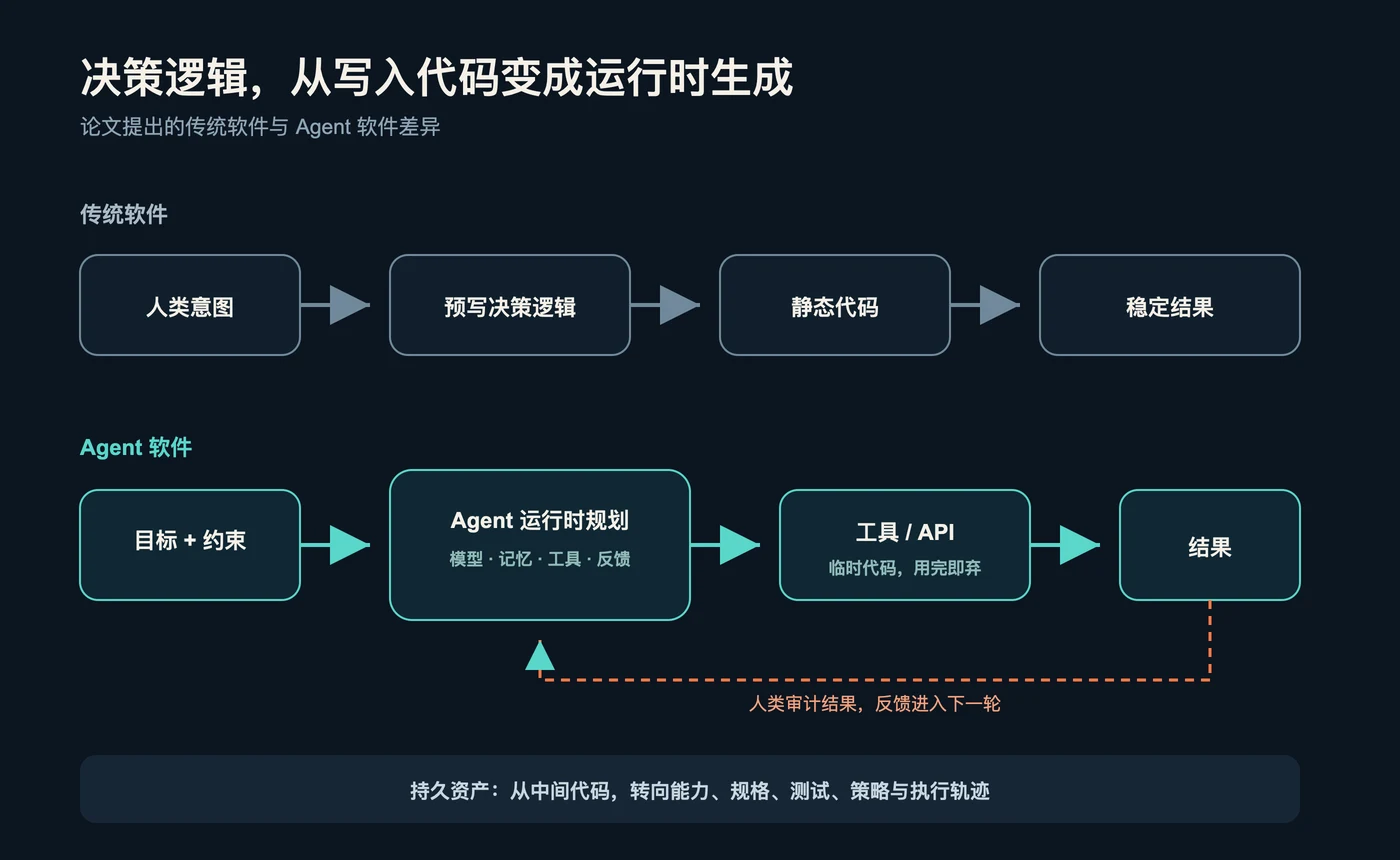
这套说法里有一句值得记住:长期存在的资产,可能从一段段中间代码,转向生成和验证结果的能力。
它并不适用于所有软件。数据库内核、支付账本、飞控系统和公共 API 仍需要稳定、可审计、长期维护的代码。一次性数据清洗脚本、后台运营流程、内部报表和临时集成,则更可能由 Agent 按需生成,用完即弃。
代码不会整体消失。它会发生分层:越靠近稳定基础设施,越需要长期维护;越靠近临时任务,越可能成为耗材。
人的工作确实在变,但不是只剩“写提示词”
论文给未来工程师起了一个新名字:Intent Architect,意图架构师。
这个词容易被理解成“会描述需求的人”。实际工作远比一句 Prompt 麻烦。目标要能执行,权限要有边界,成功要有可计算的标准;多 Agent 之间如何共享状态、哪里必须停下来等人审批、失败后怎样回滚,也需要提前设计。
论文把人的新职责概括为意图表达、架构监督、质量校准和伦理治理。换成更具体的工程语言,就是规格、权限、测试、可观测性和责任边界。
Agent 写得越快,这些东西越不能含糊。过去一个含糊需求可能换来一次会议;现在它可能换来几千行代码、几十次工具调用,以及一项已经写入生产数据库的错误操作。
所以“判断成为工作”这个方向是对的,但判断不是代码之外的软技能。它仍然需要工程知识。没有数据库、并发、安全和故障恢复经验的人,很难知道 Agent 交付的东西究竟哪里会坏。
论文最扎实的数字,恰好不支持“写代码已经结束”
论文引用 EvoClaw 的结果:12 个前沿模型搭配 4 种 Agent 框架,在孤立任务上总体成绩超过 80%;换成跨多个提交、错误会不断累积的连续软件演进任务,最好也只有 38%。
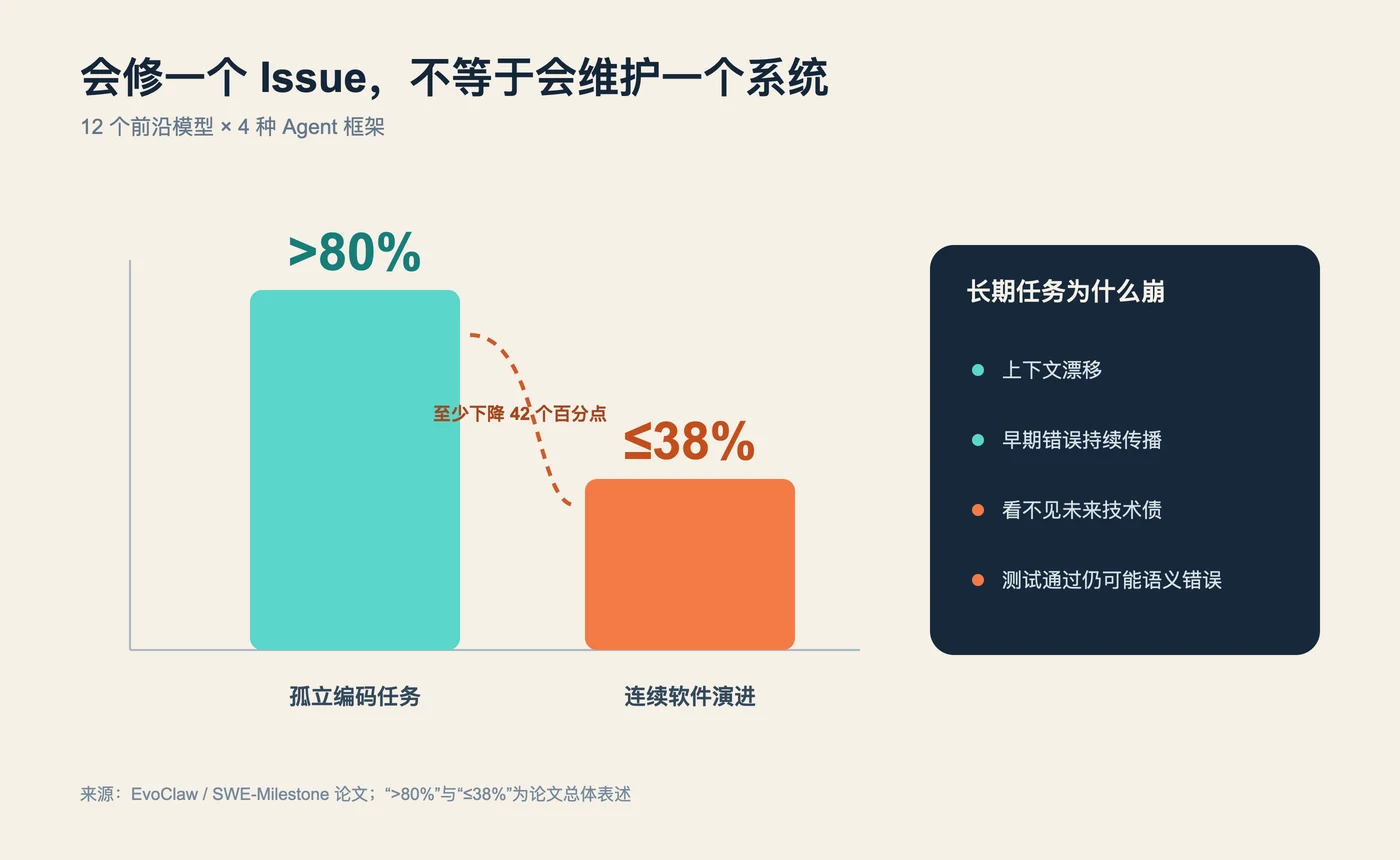
原因并不神秘。上下文会漂移,早期错误会传到后续提交,Agent 倾向于优化眼前任务,也可能通过测试却破坏隐藏语义。
这组数据测的正是“工程”和“写一个补丁”的区别。
单次任务有清楚的入口、出口和测试,模型可以很强。真实软件会连续变化,今天的捷径变成下个月的技术债,局部正确不等于系统还能维护。当前 Agent 在这类长期一致性上仍然吃力。
论文自己也因此写道,可靠的全自主软件开发仍需要数年研究。推文却把这段限制压缩成了“写代码已经彻底结束”。
另一组“突破证据”,到 2026 年已经过期
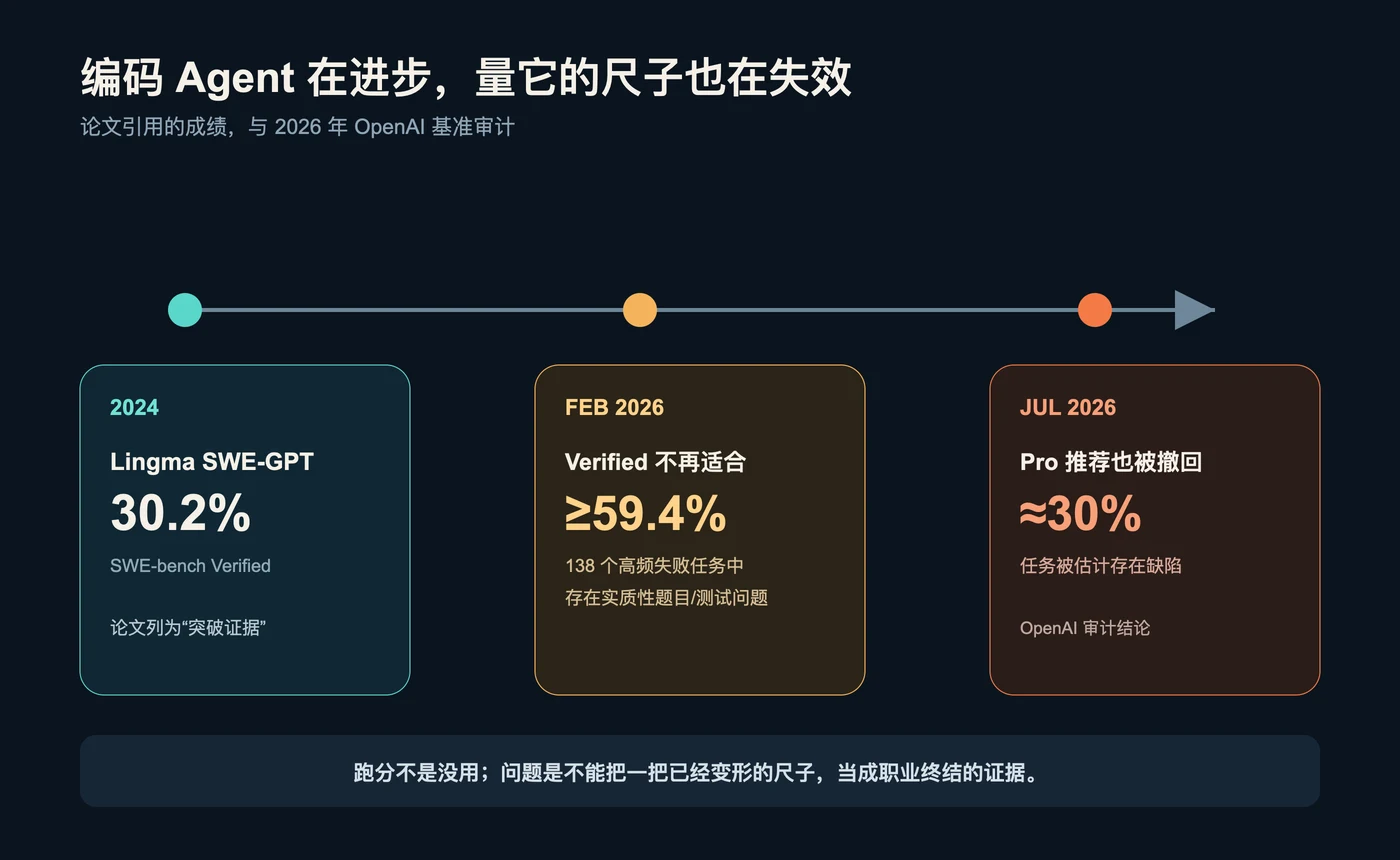
论文还引用 Lingma SWE-GPT 在 SWE-bench Verified 上的 30.2%,并把它列入 Agent 范式的突破证据。这个结果来自 2024 年,当时确实有价值。
问题是,论文提交前几个月,OpenAI 已经宣布不再用 SWE-bench Verified 衡量前沿编码能力。原因包括测试用例会拒绝正确解法,以及训练数据污染。OpenAI 对 138 个高频失败任务做审计,至少 59.4% 存在实质性的测试或题目问题。
7 月,OpenAI 又审查 SWE-Bench Pro,估计约 30% 任务有缺陷,并撤回了此前推荐。OpenAI 当然不能替行业决定标准,但这些数字说明,编码 Agent 跑分的“尺子”本身也在坏。
论文引用的 LangChain 案例同样需要降温。那篇文章是两位 Cisco 工程负责人发表在 LangChain 博客上的 guest post。它报告 20 多个调试流程的根因定位时间缩短 93%,一个月 512 次会话节省 200 多个工程小时。
案例很有参考价值,但对照使用的是历史基线,公开页面没有提供完整数据和独立复现实验。它能说明协调型 Agent 值得试,不能独自证明软件工程已经换代。
“复杂度交给模型”没有让复杂度消失
论文用一个第一性原理论证解释 Agent 为什么必然扩张:系统组件增加后,潜在依赖图数量急剧增长;人的认知容量近似固定,模型能力却会随计算投入上升。
前半句是熟悉的复杂性问题。后半句更像假设。
算力增长可以扩大搜索、上下文和推理预算,却不能自动提供正确的业务目标、完整测试或事故责任。把决策逻辑从静态代码移到运行时,还会增加随机性、版本漂移、成本波动和审计难度。
复杂度并没有被消灭,只是换了位置。过去我们审查源代码;以后还要审查模型、Prompt、工具权限、记忆、执行轨迹和评测器。
这也是 v2 改名后更可信的地方。Agentic Engineering 扩大了软件工程的范围:工程对象从“代码库”变成“模型驱动的运行系统”。
工程师现在该练什么
代码生成能力会继续贬值,尤其是样板代码和边界清楚的局部修改。与其和模型比打字速度,不如把精力移到三件更难外包的事上。
先把需求写成可检验的规格,而不是一段听起来合理的愿望。再把权限、审批和回滚设计进流程。最后建立跨版本评测,观察 Agent 连续工作十次、五十次之后,系统是不是还保持一致。
这些工作听上去没有“意图架构师”那么酷,却是 Agent 能进生产的前提。
《软件工程的终结》之所以传播,是因为它替行业喊出了焦虑。作者六天后的修改更接近事实:“亲手写出大量代码”不再足以定义一个工程师,软件工程仍在继续。
代码可能越来越像中间产物。规格、验证、边界和责任不会。
参考资料
- Zhenfeng Cao, Agentic Software: How AI Agents Are Restructuring the Software Paradigm(v2)
- Zhenfeng Cao, The End of Software Engineering(v1)
- Gangda Deng et al., SWE-Milestone / EvoClaw: Evaluating AI Agents on Continuous Software Evolution
- OpenAI, Why SWE-bench Verified no longer measures frontier coding capabilities
- OpenAI, Separating signal from noise in coding evaluations
- Renuka Kumar & Prashanth Ramagopal, Agentic Engineering: How Swarms of AI Agents Are Redefining Software Engineering
- Anatoli Kopadze, 原始推文
