Concitech AI · 深度长文
2026/09/08 21:16
Uber 的 AI 软件工厂:70% PR 来自智能体,成本公式接管预算
Uber 披露 AI 软件工厂的规模与成本模型:70% 以上 PR 归因于智能体,内部技能超过 3600 个,日调用超过 3 万次。工程重点转向模型路由、上下文压缩和工具调用。
Uber 给出三组数字:
- 70% 以上 Pull Request 归因于本地或云端智能体;
- 工程师创建了 3600 多个 Agent Skill;
- 每日 Skill 调用量超过 3 万次。
Uber 的 AI 编程是一条生产线。
生产线遇到一个熟悉问题:产量增长,成本跟着增长。
Uber 的解法跨越模型议价。团队拆开一次智能体会话,找到六个乘数。每个乘数对应一个工程控制面。
核心内容是一条成本公式。“70% PR”属于规模背景。
一条乘法公式
Uber 把总支出拆成六项:
总支出 = 用户数 × 人均会话数 × 每会话轮数 × 每轮请求数 × 每请求 Token 数 × Token 单价
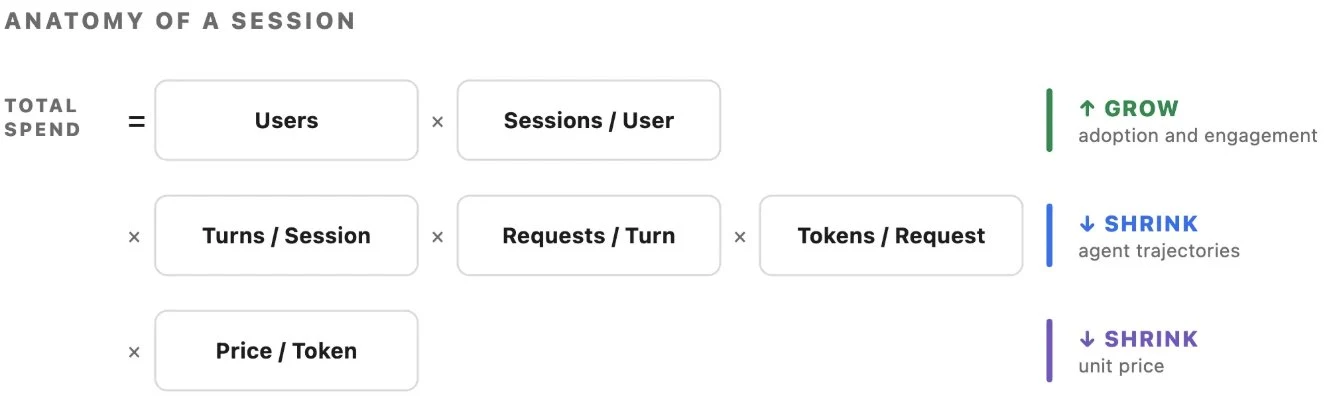
Uber 的智能体成本公式。图片来源:Uber Engineering。
前两项代表采用率和参与度。Uber 希望它们增长。后四项代表生产效率。团队调整会话轮数、请求数量、上下文体积和模型单价。
乘法结构解释了 AI 预算的失控。一次请求节省 20%,十次请求保持原量。会话数量增长十倍,账单扩大八倍。
乘法结构解释了优化价值。上下文减少、调用轮数下降、缓存命中率上升。三个小改进产生组合效果。
使用量增长,单位成本下降
Uber 公布了 2026 年 2 月至 8 月中旬的数据。全体员工的智能体周活用户增长 7 倍。智能体周请求量增长 9.4 倍。AI 总支出曲线的 4 月后段接近平线。
用户结构、工作负载和模型版本发生变化。Uber 使用固定模型隔离内部优化收益。2026 年 2 月至 7 月的固定模型口径包含两项降幅:每 1000 次请求成本的峰值降幅约 34%;每会话成本的 6 月峰值降幅是 52%。
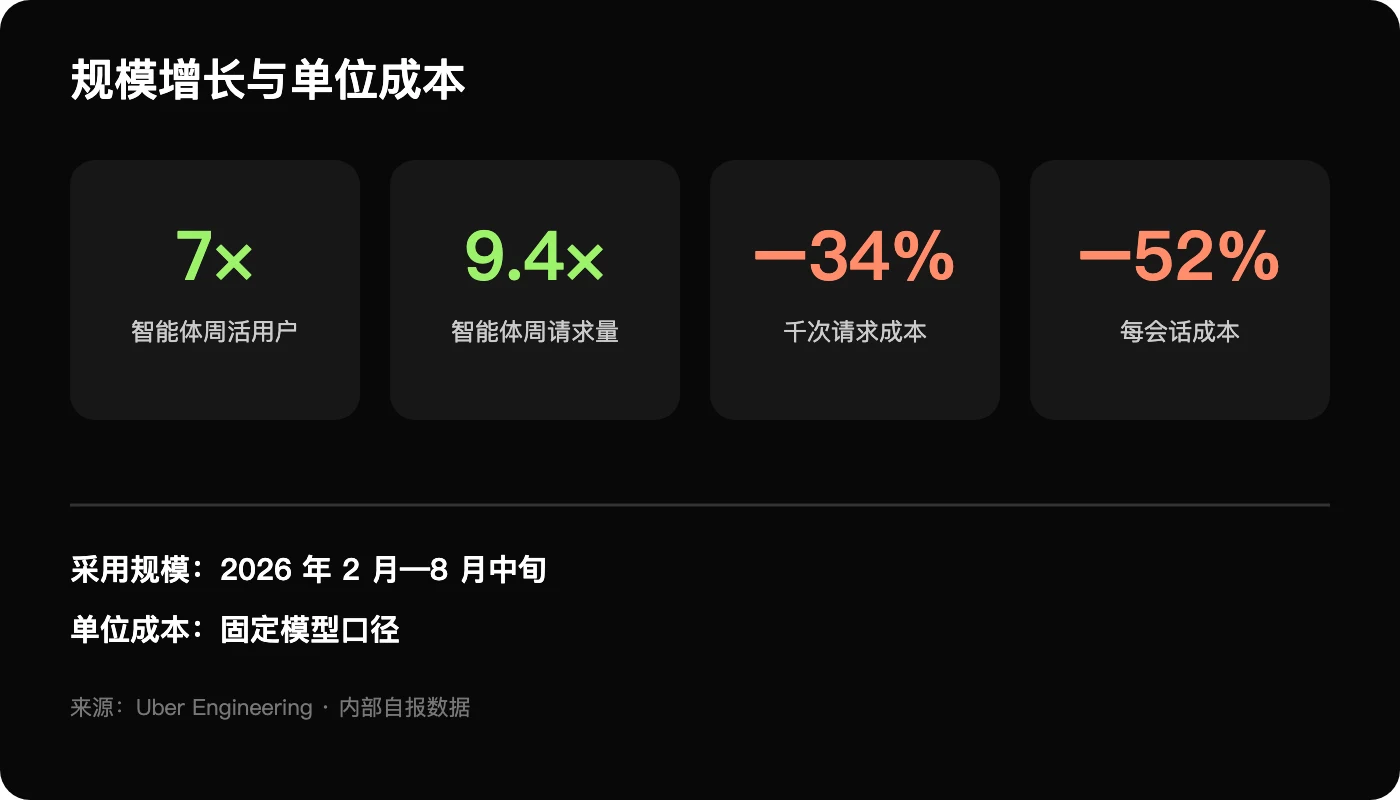
Uber 官方自报数据。采用规模与单位成本使用不同统计口径。
这些数字来自 Uber 内部统计。外部复现缺少原始数据。代码库、人员结构和任务组合影响结果。
收窄后的结论是:Uber 找到了一套适合自身环境的成本工程方法。
模型选择变成基准问题
Uber 的托管智能体拥有专用基准。uReview 负责代码审查。基准使用真实 Pull Request 和已知 Bug,指标包含 Precision、Recall、F1、单次审查成本、延迟、超时和噪声。
团队寻找 Pareto 前沿。部署条件包含质量优势和成本优势。前沿外模型失去部署价值。
Uber SWE Benchmark 覆盖数千个真实 PR 和大型 Monorepo。前沿模型与开源权重模型进入同一套任务评测。
主智能体负责任务拆解和验收。子智能体负责边界清楚的子任务。子智能体的默认模型拥有较低成本。工程师保留人工覆盖权。
这个做法减少“全员使用最强模型”的浪费。模型名失去中心位置。每个工作负载拥有自己的价格与质量曲线。
Token 成本藏在工具定义里
Uber 的 MCP 网关连接 1000 多个内部和第三方工具。标准 MCP 把工具 Schema 放进会话上下文。100 多个工具产生约 5 万至 7 万 Token 的初始负担。每轮对话携带这些内容。
Uber 采用两个出口:CLI 工具解析和 Tool Search。
CLI 把网关工具映射成命令。模型发出命令,运行时解析目标工具。Tool Search 包含目录查询和目标工具加载。会话摆脱完整工具清单。
这项设计很像操作系统。智能体拥有系统调用入口。工具实现留在上下文之外。
Code Mode 减少协议往返
标准工具调用把请求、轮询和结果逐段送回模型。SQL 任务包含一次提交、两至五次状态轮询和一次结果拉取。每一步产生模型请求。
Code Mode 把循环放进 Python 子进程。模型接收最终摘要。
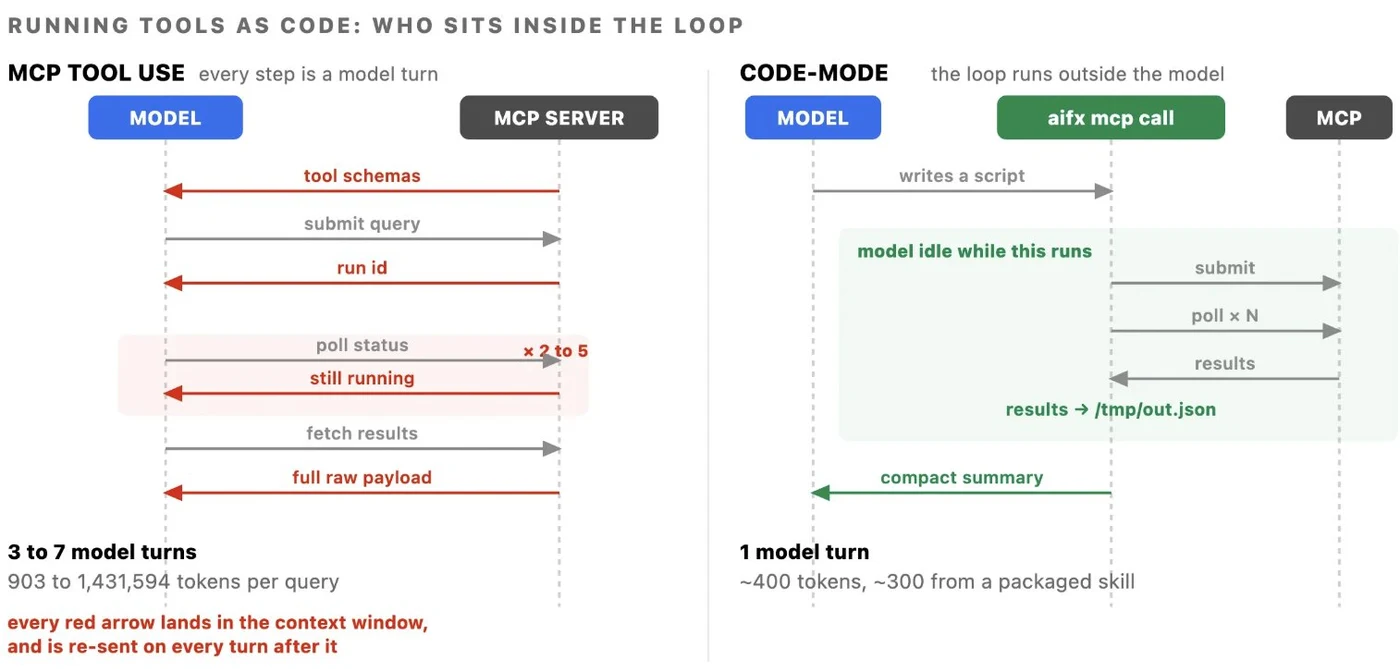
相同仓库查询的两种执行路径。图片来源:Uber Engineering。
实验环境是同一会话。五组 SQL 内容相同。三个小结果集的 Token 降幅是 55%、58% 和 71%。批量工作流的降幅超过 90%。
一个宽表查询出现接近 100% 的降幅。该结果包含一个特殊条件:Code Mode 保留中间数据,模型输入是结果摘要。该结果的适用范围止于特定工作流。
Uber 部署了 25 个以上预制 Code Mode Skill。高频 MCP 工作流获得统一执行脚本。
上下文图谱减少搜索轮次
Uber 的代码库包含数亿行代码,数据系统包含数千张表。智能体的大量轮次用于寻找信息。
团队构建了 AI Context Graph。图谱包含 2400 万个节点、8000 万条边、86 类节点和 117 类关系。数据来源覆盖 30 多个内部系统,内容包含服务、团队、事故、PR、架构文档、部署记录和数据集。
官方文章展示一个对照案例。同一个模型接收同一个问题。图谱组用时 38 秒,答案正确。对照组用时 20 分 09 秒,调用两个子智能体,遇到三个错误,结论错误。
这个案例属于官方展示。图谱平均收益缺少批量证据。案例揭示的瓶颈具有现实性:代码生成速度上升,信息定位成为耗时大户。
400K 压缩线与一小时缓存
百万 Token 上下文采用 40 万 Token 的自动压缩线。大上下文制造缓存突增和重复输入成本。推理强度的默认档位是 Medium。
提示词缓存有价格。Uber 给出的供应商口径是:缓存读取价格是标准输入的 0.1 倍,5 分钟缓存写入价格是 1.25 倍,1 小时缓存写入价格是 2 倍。
工程师会话包含五分钟以上的空闲段。交互式会话的 TTL 改为一小时。短任务子智能体保留五分钟 TTL。
这项选择说明一个细节:缓存周期匹配工作节奏。写入价格下限与会话总成本下限属于两个目标。
软件工厂的组织变化
Uber 把智能体使用分成四层。托管智能体占据控制层。团队掌握模型路由、执行框架、评测和支出。
交互式编程工具保留个人自由。个人会话的统一优化缺少控制条件。托管智能体拥有固定任务、固定评测和固定成本曲线。
Uber 的战略方向是托管智能体。代码审查、CI 自愈、端到端 PR、值班告警、Bug 调试和代码维护进入自动会话。人工负责评审和升级。
软件工厂出现两个产品面:工程产品和经济产品。工程产品交付代码。经济产品控制每个有效任务的成本。
我的判断
70% PR 与 70% 工程价值属于两种口径。PR 归因、代码规模、缺陷率和人工修改量缺少公开数据。
文章证明了另一件事:Agent 成本是一个系统工程问题。
模型价格是六个乘数之一。工具 Schema、轮询协议、上下文搜索、缓存周期和子智能体路由改变账单。
聊天界面是企业级 Agent 平台的入口。评测、路由、上下文和成本遥测组成平台护城河。
Uber 采用“每个完成任务的成本”管理智能体。这个指标接近软件工厂的真实产出。Token 单价缺少任务质量信息。
