Concitech AI · 深度长文
2026/08/31 11:10
Google WikiSkill:别再把聊天记录当成 Agent 的记忆
Agent 跑得越久,日志越多,为什么能力却没有持续增长?Google Research 的 WikiSkill 把执行轨迹、复盘知识和可执行 Skill 分成三层,并用实验说明:好规程能弥补模型规模,坏规程也会拖垮强模型。
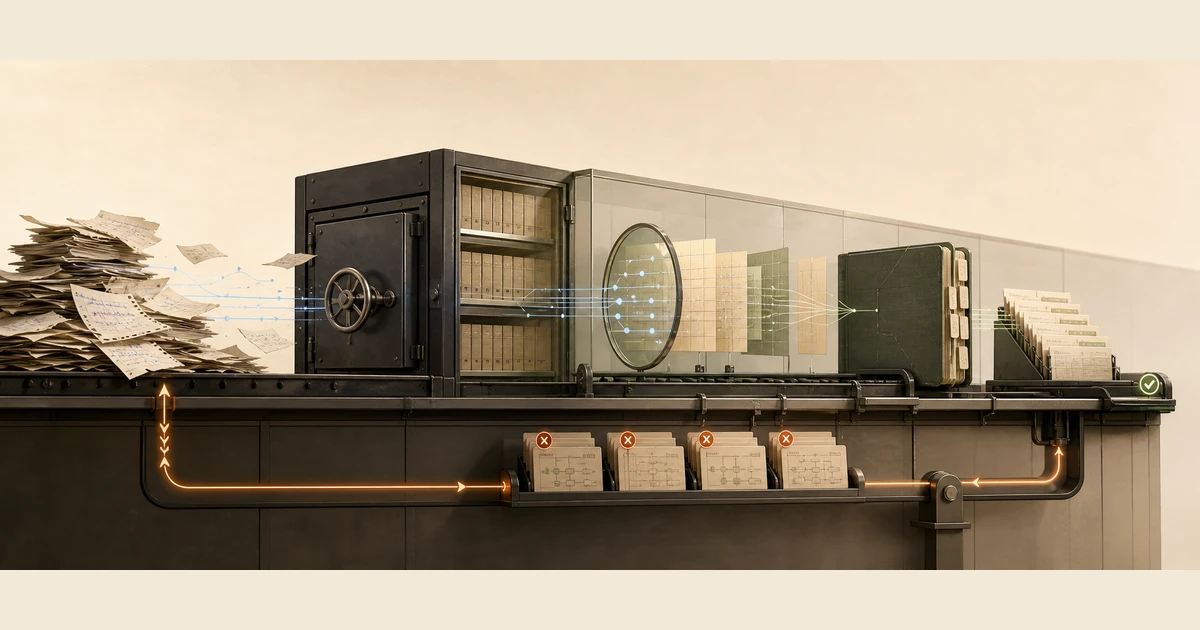
Agent 每天执行任务、调用工具、遇到报错,硬盘里的日志越来越多。可下次碰到同一个坑,它仍可能从头再摔一遍。
原因很简单:记录发生过什么,不等于知道为什么失败,更不等于已经形成一套下次能照着做的规程。
Google Research 与 Virginia Tech 的研究者最近发布了论文 WikiSkill,专门处理这个问题。它没有给模型塞进更长的“记忆”,而是把 Agent 的经验拆成三类资产:原始执行轨迹、经过整理的知识、可直接执行的 Skill。
这个区分听起来像文件整理,实验结果却相当扎眼。Qwen-3.5-9B 加上 WikiSkill 后,在五个任务上的平均成绩达到 47.4,超过没有 Skill 的 Qwen-3.6-27B(39.4)。在 SpreadsheetBench 上,Qwen-3.6-27B 从 40.8 提升到 81.7。
不过,“有 Skill”并不总是好事。一套由 4B 小模型摸索出的 Spreadsheet Skill,交给 Gemini-3.5-Flash 后,成绩反而从 50.5 跌到 18.1。
这篇论文最有价值的地方,也正在这个反例里:经验可以复用,但经验必须经过编译,而且要为使用它的模型做验证。
聊天记录为什么很难产生复利
常见的 Agent 记忆方案,是把历史对话、工具输出、报错和总结放进同一个知识库。下次执行时,再用搜索或长上下文把相关内容找回来。
问题是,这些材料处在不同层级。
一段完整轨迹是证据。它保留当时的输入、推理、工具调用和结果,适合追溯,却通常又长又乱。
“这个 API 在空结果时会返回 200,而不是 404”是一条诊断知识。它解释了反复出现的模式,但还没有告诉 Agent 具体怎么操作。
“查询后先检查响应体是否为空;为空时切换备用接口”才是程序性知识,也就是 Skill。它应该简短、明确,并且能被测试。
把这三者混在一个文件里,会出现两种坏结果:要么 Agent 每次背着一大包日志工作,要么一次偶然成功的做法被匆忙写成“永久规则”。前者浪费上下文,后者会把脆弱的补丁扩散到更多任务。
WikiSkill 的三层:证据、诊断和规程
WikiSkill 的工作区有三个物理分开的目录。
Raw Layer 保存只写一次的执行轨迹。历史不能被后来的总结覆盖,因为系统需要知道一条结论究竟来自哪些成功或失败案例。
Wiki Layer 保存持续积累的模式,包括失败原因、有效策略、可操作的替代方案、历次 Skill 修改记录及其验证结果。Wiki 不会因为某次 Skill 回滚而清空。
Skill Layer 则保存当前生效的程序性指令。候选 Skill 只有在验证集上带来提升才会被接受,效果变差就回滚。每个 Skill 还带有 PURPOSE.md,用来指回促成这次修改的 Wiki 模式。
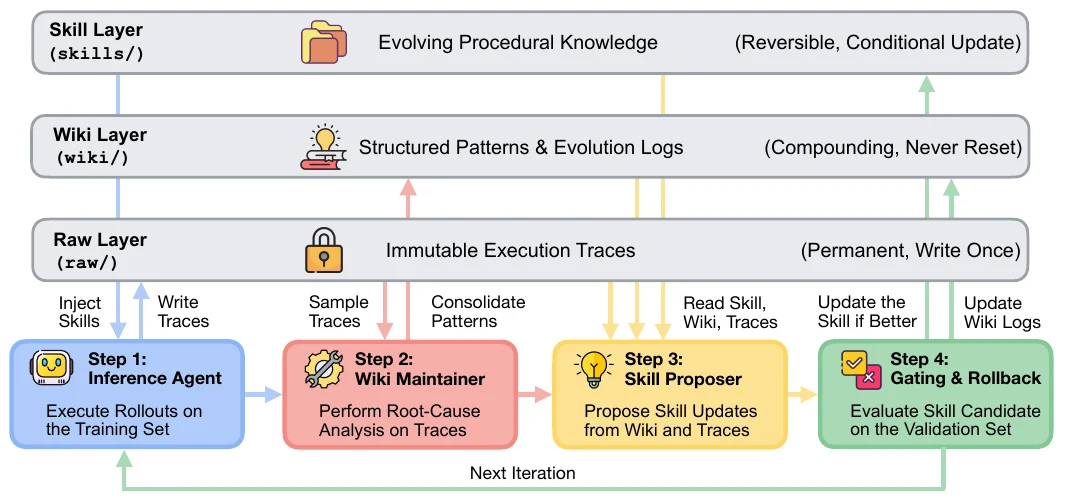
整个循环有四个角色:Inference Agent 执行任务并留下轨迹;Wiki Maintainer 从轨迹里找原因和模式;Skill Proposer 据此修改 Skill;Gating 机制在验证集上决定接受还是回滚。
这里有个很实用的设计:战术可以撤回,诊断不能跟着消失。
某条 Skill 修改没能提高分数,只能证明这个改法不合适。它背后的失败模式、尝试过的方案以及回滚结果仍有价值。WikiSkill 把这些信息留在 Wiki 中,避免后续迭代再次提出同一个坏点子。
好 Skill 能补模型规模,但不能替代模型能力
论文在五类任务上做了测试:数学推理、网页搜索、电子表格操作、长文档问答和交互式环境任务。模型覆盖 Qwen、Gemma 和 Gemini,共五个不同规模或系列。
所有方法都从空 Skill 集开始。进化得到的 Skill 在推理时完整注入系统提示词;表中结果是三次独立运行的平均值。
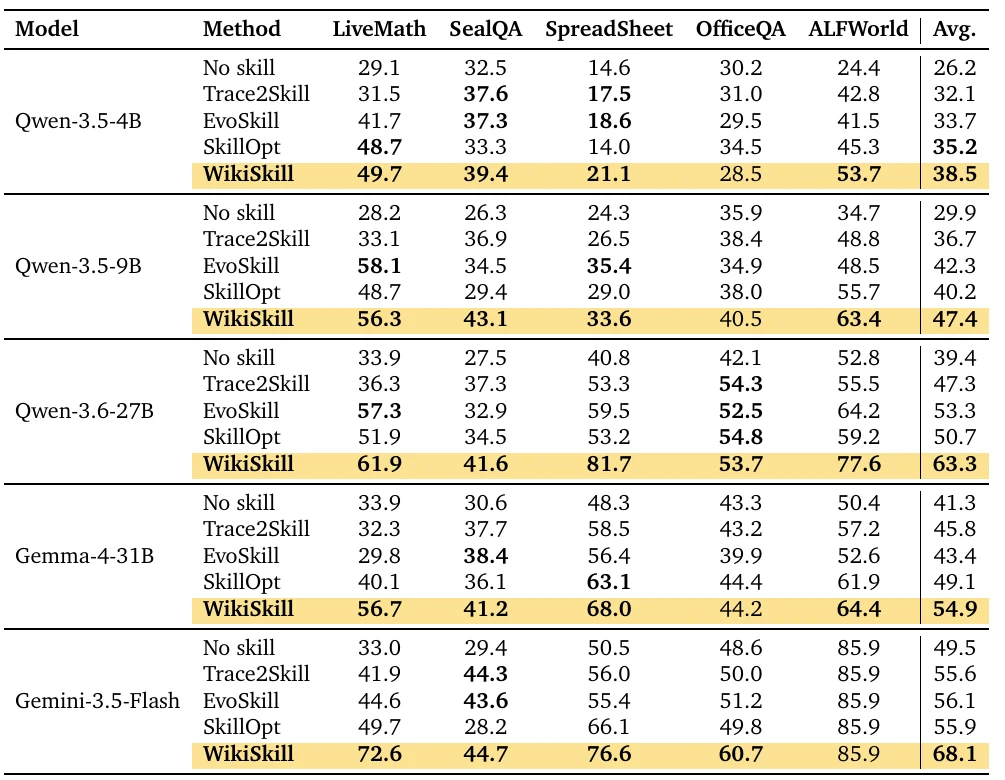
WikiSkill 在五个模型的平均成绩上均列第一。与每个模型上表现最好的既有 Skill 进化方法相比,平均分还高出 3.3 到 12.0 个点。
论文同时观察到两个方向。
一方面,程序性知识可以弥补部分参数规模差距。Qwen-3.5-9B 配合 WikiSkill 的平均成绩为 47.4,高于 Qwen-3.6-27B 裸跑的 39.4。
另一方面,更强的模型往往更能吃透好 Skill。Qwen 系列使用 WikiSkill 后,4B、9B、27B 模型的平均增益依次为 12.3、17.5 和 23.9 个点。SpreadsheetBench 上,这三个模型分别提升 6.5、9.3 和 40.9 个点。
所以,“Skill 可以让小模型打败大模型”只是局部现象。更完整的结论是:模型能力和程序性知识互补。好规程能减少探索,强模型也更可能执行复杂规程。
为什么小模型写的经验,会毒坏强模型
跨模型迁移实验比主结果更值得看。
同一套 Skill 换一个模型执行,效果可能更好,也可能突然崩掉。在 ALFWorld 上,Qwen-3.6-27B 进化出的 Skill 让 Qwen-3.5-9B 得到 70.2,高于它使用自进化 Skill 时的 63.4。这说明“发现规程”和“执行规程”是两种能力,最好的老师未必是自己。
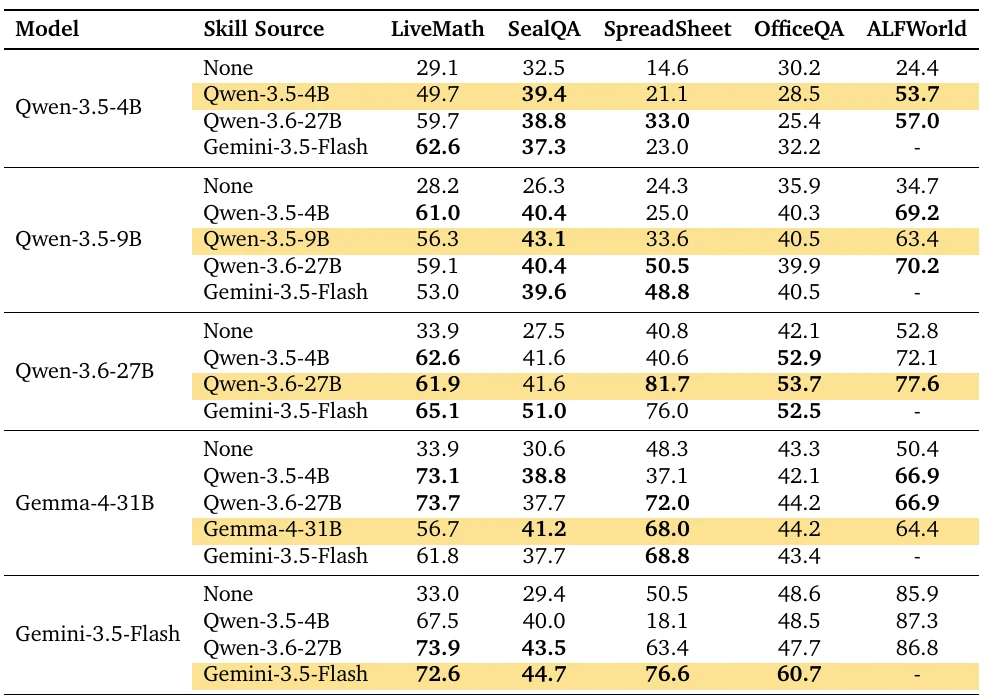
负迁移同样明显。Qwen-3.5-4B 生成的 Spreadsheet Skill,让 Gemini-3.5-Flash 从 50.5 降到 18.1;换成 Qwen-3.6-27B 生成的 Skill,Gemini 得到 63.4。
研究者检查轨迹后发现,小模型的 Skill 写入了很多底层补丁,例如单行 Python 命令和字符串转换规则。这些办法能帮 4B 模型避开执行错误,却限制了 Gemini 使用完整的端到端脚本。零碎的诊断步骤还增加了工具调用,可能在任务完成前耗尽交互预算。
这对企业内部 Skill 库是个直接警告:Skill 不是与模型无关的“最佳实践”。模型、工具环境和任务预算一变,过去的护栏可能就成了枷锁。上线前必须按目标模型重新跑评测,不能因为文件名叫 best-practice.md 就默认它通用。
“开卷训练”为什么反而写不出好手册
WikiSkill 还有一个容易被误读的消融实验。
默认设置里,负责改写 Skill 的 Skill Proposer 可以读取 Wiki;执行训练任务的 Inference Agent 只能读取当前 Skill,不能直接翻 Wiki。这个限制会迫使轨迹暴露 Skill 的真实缺口。
当 Skill Proposer 能看 Wiki、Inference Agent 不能看时,四个基准的平均成绩为 63.7。让 Inference Agent 在执行任务时也读取 Wiki,平均成绩降到 60.9,LiveMath 从 72.6 降到 64.8。
论文给出的解释是:执行 Agent 如果能临时从 Wiki 找到答案,当前 Skill 的缺陷就不再明显。后续系统看到的是“任务完成了”,却很难判断究竟是哪条规程需要修补。
这不是“模型不能看知识库”的普遍结论。实验讨论的是 Skill 进化阶段,而且作者把原因明确写成假设。它说明的是另一个工程问题:如果你想改进操作手册,评测时就不能让执行者绕过手册靠隐藏资料救场。
企业该怎样搭自己的 Skill 库
WikiSkill 还只是研究原型,但它给生产系统提供了四条能直接落地的原则。
- 原始轨迹只读保存,复盘知识持续整理,线上 Skill 单独版本化。三者不要共用一个“记忆库”。
- 每次 Skill 修改都保留证据链,记录它解决了哪个失败模式、在哪个验证集上有效、后来为什么回滚。
- 按目标模型和工具环境做回归测试。跨模型迁移默认视为一次新发布,而不是复制文件。
- 让执行者和总结者分工。执行 Agent 负责暴露问题,维护 Agent 负责归因,Skill 修改必须经过独立验证。
论文也留下了几个尚未解决的坑。它为了隔离 Skill 质量,直接把全部生效 Skill 注入提示词,没有测试 Skill 数量增长后的检索和触发;Wiki 会持续积累,目前没有自动清理机制;实验也没有覆盖持续数小时、包含数百次动作的超长任务。
换句话说,WikiSkill 解决的是“如何把经验编译成规程”,还没有解决企业规模 Skill 库的检索、淘汰和权限治理。
结语
很多所谓的 Agent 记忆,只是在保存聊天记录。保存很容易,学习很难。
WikiSkill 的贡献,是给二者划出一条清楚的边界:轨迹负责还原事实,Wiki 负责积累理解,Skill 负责指导下一次行动。只有最后一层可以随时回滚;前两层负责让系统知道自己为什么改、改过什么、哪里还会犯错。
如果一个团队只想让 Agent “记得更多”,它最终多半会得到一个越来越贵的上下文。如果它开始认真管理证据、诊断和规程,才有可能把一次次失败变成可复用的能力。
