Concitech AI · 深度长文
2026/11/07 06:40
X公开网页重写内幕!AI写代码,慢网首帖测试24.7秒降至3秒
X工程团队披露网页应用重写,AI参与实现与测试,工程师负责架构和审查。慢网测试的个人资料页首帖中位耗时为旧版24.7秒、新版3秒,首页收益小于资料页。流式HTML、数据预取与渐进迁移,揭示AI编程之外的工程责任。
AI参与大型系统重写,工程师的责任落到了架构与验收。
X的11月4日工程博客介绍,五人团队与AI编程Agent完成了新版网页应用的首版,首版建设周期少于六个月。工程师确定架构、选择任务、审查变更,Agent承担大量编码与迁移工作。
首版完成与全面替换,属于不同状态。原文披露,新应用承接未登录页面与搜索爬虫,登录用户采用逐国迁移。旧应用承担其余流量。X工程博客
文章的核心问题是:浏览器等待什么,服务端承担什么,迁移结果由什么证明。
一套应用,服务三类访问者
X介绍的新应用统一了原有三条服务路径,面向普通访客、搜索爬虫与链接预览机器人。这里的“一套服务”指应用架构,物理服务器与实例数量属于部署问题。
访问目标解释了这种设计的理由。
人需要内容与交互。搜索引擎需要正文、链接、结构化数据与正确状态码。聊天工具的预览机器人需要标题、描述与卡片图。
三个目标对应不同的工作量。一个预览卡片请求,缺少加载完整时间线的业务需求;一个正文索引请求,需要完整的内容语义;用户页面的内容展示与交互准备,具有不同的完成时刻。
统一的应用代码,需要表达这些差别。统一逻辑与相同输出,是两个概念。
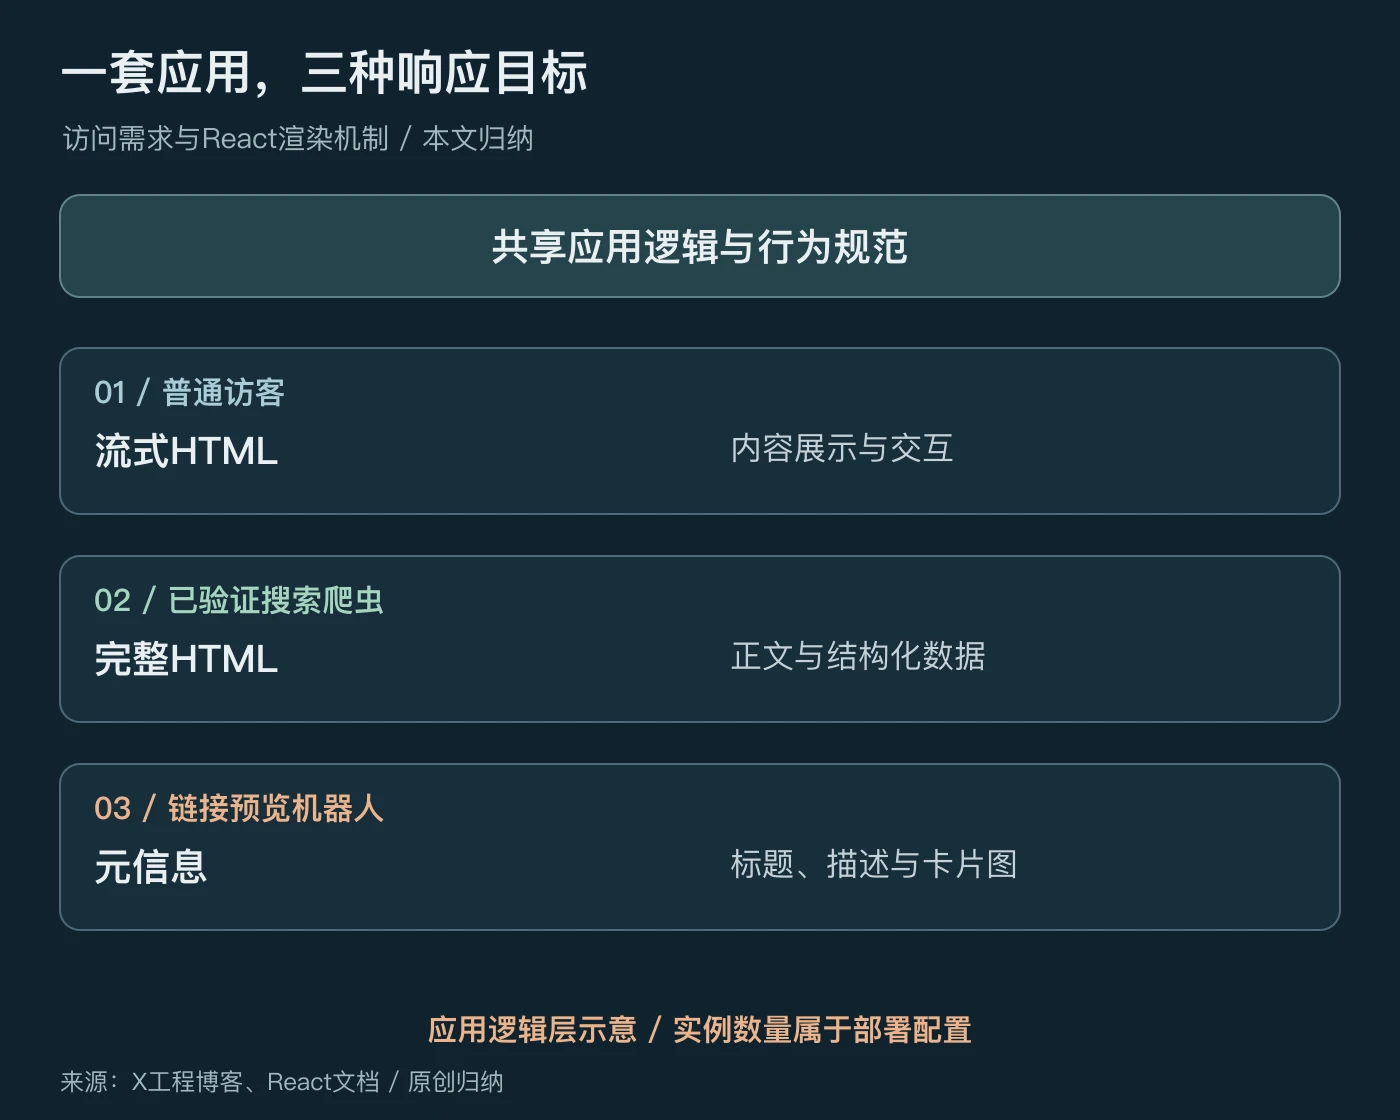
图1:X案例的需求归纳与React渲染机制示意。三类访问者共享应用逻辑,响应策略具有区别。本文原创。
流式HTML,改变的是依赖链
一个客户端渲染页面的简化链路,是HTML外壳、JavaScript、数据请求与内容渲染。数据请求依赖代码执行,代码执行依赖脚本下载。慢连接的等待包含这些先后关系。
服务端渲染改变了内容的来源。浏览器收到的HTML包含业务内容,脚本承担后续交互。流式渲染提供分段输出,页面外壳和各个内容区域具有独立的准备进度。
React文档提供两类回调:onShellReady对应外壳就绪,onAllReady对应全部渲染完成。前者提供渐进输出入口,后者适合需要完整文档的场景。Suspense边界表达内容区的等待与占位。React服务端渲染文档
这套机制解释了一个常见现象:首字节耗时增加,内容出现时间缩短。
空外壳的交付工作是提供页面框架,正文HTML的交付包含数据获取与渲染。两种响应的首字节承担不同含义。用户关心的完成目标,是看见内容和完成操作,指标选择需要对应业务目标。
SSR增加服务端工作量,缓存、容量与错误处理构成配套责任。流式输出开始后的HTTP状态码修改受到限制,内容错误与外壳错误需要对应处理。一个框架名称,缺少代替这些设计的能力。
数据获取,需要脱离组件等待
页面包含作者、帖子与引用内容,数据形成依赖图。组件的渲染顺序与网络请求的启动顺序,具有不同的优化目标。
Relay文档推荐分离数据获取与渲染,预加载查询,减少逐层发起请求造成的往返。useQueryLoader管理查询引用,usePreloadedQuery读取对应结果。Relay查询文档
一个假设页面包含资料区与帖子区。资料区的显示需要作者信息,帖子区需要帖子查询。查询之间存在真实依赖,串行关系具有理由;两项查询缺少依赖,串行关系构成额外等待。
我的工程判断是,性能分析需要一张依赖图。图中每条边,需要业务或数据上的解释。代码中的先后顺序,缺少天然的业务合理性。
预取需要约束。一次悬停代表访问意图的线索,预取请求产生带宽、服务端与缓存成本。页面切换收益与这些成本,构成评估对象。
24.7秒与3秒,是什么条件的结果?
X公布的11月3日实验采用空缓存、关闭Service Worker的Chromium,慢网配置包含150毫秒附加延迟、1.6Mbps下载、750Kbps上传与4倍CPU减速。下面是7次加载的首帖出现耗时中位数:
| 登录页面 | 旧版rweb | 新版应用 |
|---|---|---|
| 首页 | 24.6秒 | 14.1秒 |
| SpaceX个人资料页 | 24.7秒 | 3.0秒 |
| SpaceX帖子页 | 21.7秒 | 1.7秒 |
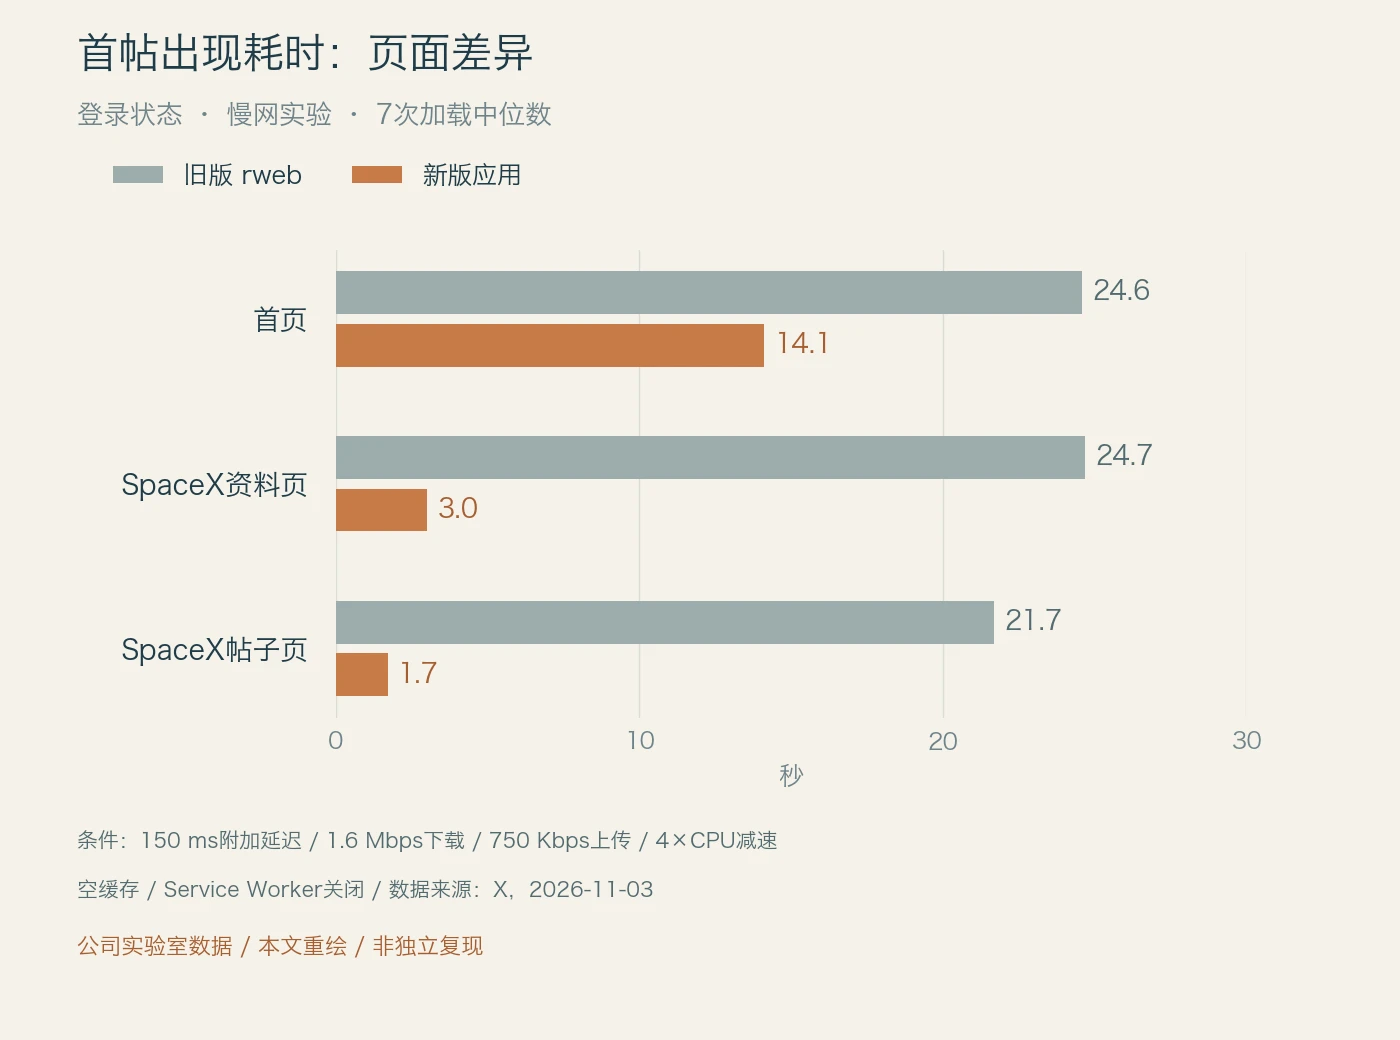
图2:X公布数据的重绘图,单位为秒;指标为首帖出现耗时中位数。测试条件同上,本文缺少独立复现;全站收益需要真实流量数据。
首页的改善小于资料页与帖子页。原文解释,新版登录首页的时间线采用浏览器渲染。
这组结果需要保持三条边界:实验室与真实访问、首帖出现与交互就绪、特定页面与全站分布。加载动画属于视觉内容,FCP衡量首个内容绘制,首帖指标关注业务内容,两者回答不同问题。
服务器的慢,包含事件循环排队
服务端渲染的性能账本,包含CPU工作与排队。
Node.js文档指出,事件循环处理多个客户端的回调;某项回调占用线程,其他请求等待执行机会。一个上游响应的网络耗时,与应用处理该响应的时刻,存在区别。Node.js事件循环说明
这解释了一类排障陷阱:上游服务的延迟健康,网页请求出现超时。检查范围包含本地计算、队列、事件循环与上游网络。
渲染任务拆分、工作线程容量和限流,属于服务端设计选项。增加线程需要CPU和内存预算,流量分散需要观测验证。某项容量配置的正确性,来自负载结果。
搜索抓取与脚本调度,是另外两份账单
Google的官方说明给出Googlebot的2MB抓取上限,适用于非PDF资源;2MB包含HTTP响应头。截断之后的内容,缺少进入后续处理的机会。外部脚本与样式具有独立的资源限额。Google抓取说明
正文HTML的体积,影响搜索引擎获得的信息完整度。重复的图标、状态数据与结构化内容,具有体积成本;浏览器执行需要的材料,与爬虫索引需要的材料,具有独立的设计要求。
脚本调度影响交互时刻。MDN说明,模块脚本的默认执行等待文档解析,async改变执行时机,脚本执行依赖需要检查。流式文档的解析完成,涉及最后一批HTML抵达的时刻。MDN脚本说明
可见内容、脚本下载和事件绑定,是三个状态。首帖出现的胜利,需要搭配交互指标观察。
AI写代码,验收规格决定迁移质量
X描述的约束包含AGENTS.md、仓库Skills、lint与提交检查,旧服务充当行为规格。工程判断与审查,构成人类团队的工作。
这个分工的可迁移部分,是建立可执行的验收对象。
一个旧链接的重定向、一项404状态、一组语言版本和一张预览卡片,包含长期积累的产品承诺。重写的目标需要说明哪些行为继承、哪些行为改变,以及差异的理由。
我的建议是,迁移任务的交付物包含行为对照、关键路径测试、性能测量与流量回退条件。AI生成的代码接受这些约束,代码行数与提交数量提供的是工作量线索。
X案例展示了AI参与实现的速度,以及工程约束的分量。软件团队的可复用经验,是规格、证据与发布控制的关系。
